콘텐츠로 이동
35 posts with the tag “Python”

파이썬으로 IMF에서 각국의 GDP 수집하기 (v.2025)

이번 글에서는 파이썬을 사용하여 IMF(국제통화기금)에서 WEO(World Economic Outlook) 데이터베이스를 통해 세계 경제 데이터를 수집하고 GDP(국내총생산) 데이터를 조회하고 시각화하는 방법을 소개합니다.

WEO 데이터베이스에는 각국의 GDP, 인플레이션, 실업률 등 다양한 경제 지표가 포함되어 있습니다. 여기서는 GDP 데이터를 중심으로 다룹니다.

다음 내용을 다룹니다:

  • WEO 데이터를 SDMX 3.0 API를 통해 수집하는 방법
  • GDP 데이터 조회 및 시각화 방법

먼저 필요한 파이썬 라이브러리를 설치합니다. pandas, requests, matplotlib 라이브러리가 필요합니다.

Terminal window
pip install pandas requests matplotlib

IMF의 WEO 데이터는 SDMX 3.0 API를 통해 접근할 수 있습니다. 다음은 파이썬을 사용하여 GDP 데이터를 수집하는 예제 코드입니다.

import json
import requests
def get_weo_data():
# Dataset
# - Dataset name: World Economic Outlook (WEO)
# - ID: WEO
# - Agency: IMF.RES
# - Version: 9.0.0
"IMF.RES,WEO"
# Data Query
# https://api.imf.org/external/sdmx/3.0/data/{context}/{agencyID}/{resourceID}/{version}/{key}[?c][&updatedAfter][&firstNObservations][&lastNObservations][&dimensionAtObservation][&attributes][&measures][&includeHistory][&asOf]
url = "https://api.imf.org/external/sdmx/3.0/data/dataflow/IMF.RES/WEO/9.0.0/*"
res = requests.get(url)
data = json.loads(res.text)
return data

get_weo_data 함수를 호출하여 WEO 데이터를 수집할 수 있습니다.

import json
with open("weo_data.json", "w") as fout:
data = get_weo_data()
json.dump(data, fout)

수집한 데이터는 SDMX 3.0 형식으로 제공되서 파싱이 필요합니다.

데이터를 살펴보면 dataSets 키 아래에 여러 국가와 지표가 포함되어 있습니다. 그런데 키 값이 복잡하므로, 이를 해석하기 위해서는 structures 키 아래의 정보를 참고해야 합니다.

다음은 데이터를 파싱하여 판다스 데이터프레임으로 변환하는 예제 코드입니다.

output = []
for data_set in data_sets:
structure = structures[data_set["structure"]]
series_dims = structure["dimensions"]["series"]
obs_dims = structure["dimensions"]["observation"]
for series_key, series_content in data_set["series"].items():
# series dimensions 파싱
dim_indices = series_key.split(":")
series_info = {}
for i, dim_index in enumerate(dim_indices):
dim_id = series_dims[i]["id"]
dim_value_id = series_dims[i]["values"][int(dim_index)]["id"]
series_info[dim_id] = dim_value_id
# series attributes 파싱
attributes_info = {}
for attr_value, struct_attr in zip(series_content.get("attributes", []),
structure["attributes"]["series"]):
attr_id = struct_attr["id"]
# coded attribute는 index로 제공 => value id로 변환
if isinstance(attr_value, int):
attr_id_value = struct_attr["values"][attr_value]["id"]
else:
attr_id_value = attr_value # uncoded string
attributes_info[attr_id] = attr_id_value
# observations 처리
if "observations" not in series_content:
continue
for obs_key, obs_value in series_content["observations"].items():
obs_idx = int(obs_key)
obs_dim_value = obs_dims[0]["values"][obs_idx]["value"]
value = obs_value[0]
row = {
**series_info,
**attributes_info,
"TIME_PERIOD": obs_dim_value,
"VALUE": value
}
output.append(row)
# pandas DF 생성
import pandas as pd
df = pd.DataFrame(output)
df
.dataframe tbody tr th {
vertical-align: top;
}
.dataframe thead th {
text-align: right;
}
COUNTRY INDICATOR FREQUENCY SCALE DECIMALS_DISPLAYED OVERLAP COUNTRY_UPDATE_DATE TIME_PERIOD VALUE
0 ABW BCA A 9 3 OL 9/19/2025 1999 -435000000
1 ABW BCA A 9 3 OL 9/19/2025 2000 213000000
2 ABW BCA A 9 3 OL 9/19/2025 2001 310000000
3 ABW BCA A 9 3 OL 9/19/2025 2002 -333000000
4 ABW BCA A 9 3 OL 9/19/2025 2003 -167000000
... ... ... ... ... ... ... ... ... ...
354235 ZWE TXG_RPCH A 0 3 OL 9/5/2025 2026 -0.814
354236 ZWE TXG_RPCH A 0 3 OL 9/5/2025 2027 4.939
354237 ZWE TXG_RPCH A 0 3 OL 9/5/2025 2028 4.226
354238 ZWE TXG_RPCH A 0 3 OL 9/5/2025 2029 3.698
354239 ZWE TXG_RPCH A 0 3 OL 9/5/2025 2030 3.604

354240 rows × 9 columns

위 코드에서는 다음과 같은 작업을 수행합니다:

  • data_sets와 structures를 추출하여 각각의 시리즈와 관측치를 파싱합니다.
  • series_key를 ”:“로 분리하여 각 차원의 값을 추출합니다.
  • series_content의 attributes를 구조체의 attributes와 매핑하여 속성 값을 추출합니다.
  • observations를 순회하며 각 관측치의 시간과 값을 추출하여 최종적으로 판다스 데이터프레임으로 변환합니다.

이제 df 데이터프레임에는 각국의 GDP 데이터가 포함되어 있습니다. 이를 활용하여 다양한 분석과 시각화를 수행할 수 있습니다.

특정 데이터를 조회하기 위해서 국가 코드, 지표 코드 등을 알아야 합니다. 예를 들어, 미국은 “USA”, 한국은 “KOR”입니다. 주요 GDP 지표는 다음과 같습니다:

  • 실질 GDP (현재 가격): NGDP_R
  • 실질 GDP (전년 대비 증감률): NGDP_RPCH
  • GDP 갭 (실질 GDP - 잠재 GDP): NGAP_NPGDP

다음 링크에서 각국의 GDP 데이터를 직접 조회할 수도 있습니다: https://data.imf.org/en/Data-Explorer?datasetUrn=IMF.RES:WEO(9.0.0)

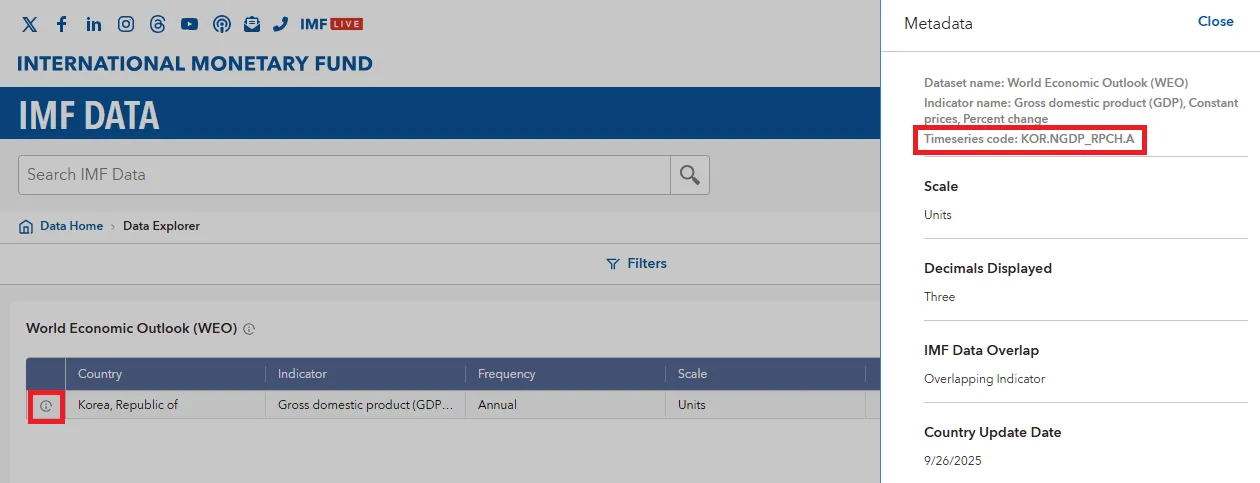
조회한 테이블 좌측의 ℹ️ 아이콘을 클릭하면 Timeseries code를 확인할 수 있는데, 여기서 국가 코드와 지표 코드를 알 수 있습니다. 예를 들어, Timeseries code: KOR.NGDP_RPCH.A는 한국(KOR)의 실질 GDP 성장률(NGDP_RPCH)을 의미합니다. A는 연간 데이터를 나타냅니다.
alt text

다음은 미국과 한국의 실질 GDP와 실질 GDP 성장률을 시각화하는 예제 코드입니다.

import matplotlib.pyplot as plt
# NGDP_R: 실질 GDP (현재 가격)
# NGDP_RPCH: 실질 GDP (전년 대비 증감률)
# NGAP_NPGDP: GDP 갭 (실질 GDP - 잠재 GDP)
fig, axes = plt.subplots(nrows=2, ncols=3, figsize=(12, 6))
# 미국
us_data = df[(df["COUNTRY"] == "USA") & (df["INDICATOR"] == "NGDP_R")].copy()
us_data["VALUE"] = pd.to_numeric(us_data["VALUE"])
us_data.plot(x="TIME_PERIOD", y="VALUE", title="US Real GDP Over Time", kind="line", ax=axes[0, 0])
us_data = df[(df["COUNTRY"] == "USA") & (df["INDICATOR"] == "NGDP_RPCH")].copy()
us_data["VALUE"] = pd.to_numeric(us_data["VALUE"])
us_data.plot(x="TIME_PERIOD", y="VALUE", title="US Real GDP Growth Rate Over Time", kind="line", ax=axes[0, 1])
us_data = df[(df["COUNTRY"] == "USA") & (df["INDICATOR"] == "NGAP_NPGDP")].copy()
us_data["VALUE"] = pd.to_numeric(us_data["VALUE"])
us_data.plot(x="TIME_PERIOD", y="VALUE", title="US GDP Gap Over Time", kind="line", ax=axes[0, 2])
# 한국
kr_data = df[(df["COUNTRY"] == "KOR") & (df["INDICATOR"] == "NGDP_R")].copy()
kr_data["VALUE"] = pd.to_numeric(kr_data["VALUE"])
kr_data.plot(x="TIME_PERIOD", y="VALUE", title="Korea Real GDP Over Time", kind="line", ax=axes[1, 0])
kr_data = df[(df["COUNTRY"] == "KOR") & (df["INDICATOR"] == "NGDP_RPCH")].copy()
kr_data["VALUE"] = pd.to_numeric(kr_data["VALUE"])
kr_data.plot(x="TIME_PERIOD", y="VALUE", title="Korea Real GDP Growth Rate Over Time", kind="line", ax=axes[1, 1])
kr_data = df[(df["COUNTRY"] == "KOR") & (df["INDICATOR"] == "NGAP_NPGDP")].copy()
kr_data["VALUE"] = pd.to_numeric(kr_data["VALUE"])
kr_data.plot(x="TIME_PERIOD", y="VALUE", title="Korea GDP Gap Over Time", kind="line", ax=axes[1, 2])
plt.tight_layout()
alt text

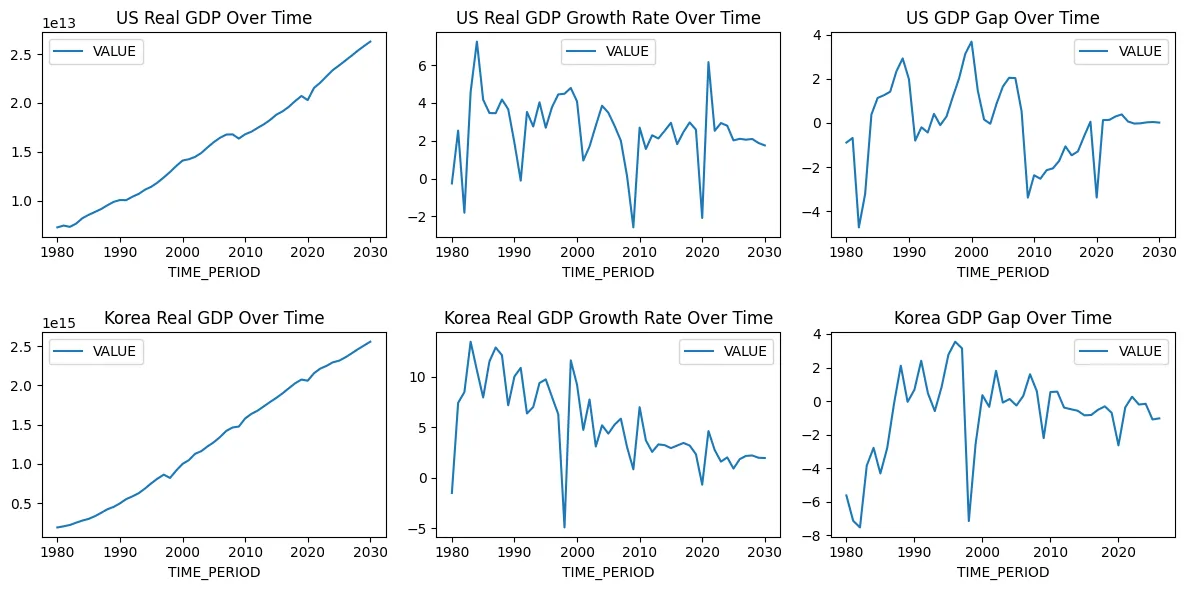
양국의 실질 GDP는 꾸준히 증가하는 추세를 보이며, 실질 GDP 성장률은 경기 변동에 따라 등락을 반복하는 모습을 확인할 수 있습니다.

GDP 갭 역시 경제 상황에 따라 변화하는 모습을 시각적으로 파악할 수 있습니다. 잠재 GDP는 경제가 완전 고용 상태에서 생산할 수 있는 최대 생산량을 나타내는데, GDP 갭이 양수일 경우 실제 GDP가 잠재 GDP를 초과하는 상태를 의미하며, 음수일 경우 그 반대를 의미합니다. GDP 갭이 양수로 크면 인플레이션 압력이 증가할 수 있고, 음수로 크면 경기 침체의 신호일 수 있습니다.

이와 같이 파이썬을 활용하여 IMF WEO 데이터베이스에서 각국의 GDP 데이터를 수집하고 분석할 수 있습니다. 미국, 한국 외에도 다양한 국가의 GDP 데이터를 동일한 방법으로 수집하여 비교 분석할 수 있습니다.
대신증권 크레온 API로 매수/매도 주문 넣고 확인하기

이번 포스트에서는 대신증권 크레온 API로 주식 주문을 내고 실시간으로 체결을 확인하고 주문 내역을 조회하는 방법을 다룹니다.

먼저 매수 또는 매도 주문을 내는 방법을 알아보겠습니다. 주문은 크레온 API의 CpTrade.CpTd0311 모듈을 사용하면 됩니다.

다음과 같이 order() 함수를 선언하고, action, code, amount를 매수/매도 구분, 주문할 종목 코드, 주식 수로 각각 입력 받도록 했습니다. 물론 더 다양한 입력을 받을 수 있게 이 함수를 수정할 수 있습니다.

import win32com.client
class Creon:
def __init__(self):
self.orderevent_handler = None
def order(self, action, code, amount):
if not code.startswith('A'):
code = 'A' + code
account_no, account_gflags = self.init_trade()
self.obj_CpTrade_CpTd0311.SetInputValue(0, action) # 1: 매도, 2: 매수
self.obj_CpTrade_CpTd0311.SetInputValue(1, account_no) # 계좌번호
self.obj_CpTrade_CpTd0311.SetInputValue(2, account_gflags[0]) # 상품구분
self.obj_CpTrade_CpTd0311.SetInputValue(3, code) # 종목코드
self.obj_CpTrade_CpTd0311.SetInputValue(4, amount) # 매수수량
self.obj_CpTrade_CpTd0311.SetInputValue(8, '03') # 시장가
result = self.obj_CpTrade_CpTd0311.BlockRequest()
if result != 0:
print('order request failed.', file=sys.stderr)
status = self.obj_CpTrade_CpTd0311.GetDibStatus()
msg = self.obj_CpTrade_CpTd0311.GetDibMsg1()
if status != 0:
print('order failed. {}'.format(msg), file=sys.stderr)
def buy(self, code, amount):
return self.order('2', code, amount)
def sell(self, code, amount):
return self.order('1', code, amount)

매수할 때는 buy() 함수를 호출해서 action을 2로 지정하고, 매도할 때는 sell() 함수를 호출해서 action을 1로 지정하도록 했습니다.

여기서는 시장가로 매수/매도를 하도록 했는데 지정가, 최유리지정가, 최우선지정가 등으로 변경할 수 있습니다. 이 부분은 CpTrade.CpTd0311 문서에서 SetInputValue의 8 - (string) 주문호가구분코드 항목을 함고하시기 바랍니다.

이렇게 매수 또는 매도 주문을 넣고 체결 되었을 때 다음과 같이 이벤트를 받을 수 있습니다.

class Creon:
def subscribe_orderevent(self, cb):
obj = win32com.client.Dispatch('Dscbo1.CpConclusion')
handler = win32com.client.WithEvents(obj, OrderEventHandler)
handler.set_attrs(obj, cb)
self.orderevent_handler = obj
obj.Subscribe()
def unsubscribe_orderevent(self):
if self.orderevent_handler is not None:
self.orderevent_handler.Unsubscribe()
self.orderevent_handler = None
class OrderEventHandler(EventHandler):
def OnReceived(self):
item = {
'계좌명': self.obj.GetHeaderValue(1),
'name': self.obj.GetHeaderValue(2),
'체결수량': self.obj.GetHeaderValue(3),
'체결가격': self.obj.GetHeaderValue(4),
'주문번호': self.obj.GetHeaderValue(5),
'원주문번호': self.obj.GetHeaderValue(6),
'계좌번호': self.obj.GetHeaderValue(7),
'상품관리구분코드': self.obj.GetHeaderValue(8),
'종목코드': self.obj.GetHeaderValue(9),
'매매구분코드': self.obj.GetHeaderValue(12),
'체결구분코드': self.obj.GetHeaderValue(14),
'현금신용대용구분코드': self.obj.GetHeaderValue(17),
}
self.cb(item)

subscribe_orderevent() 함수를 호출해서 체결 이벤트를 실시간으로 받아올 수 있습니다. 매수/매도 주문이 체결되면 지정된 콜백 함수 cb로 체결 정보를 전송합니다. 이를 위해서 OrderEventHandler 클래스를 선언했고, 이 클래스의 OnReceived() 함수에서 체결 정보를 cb에 전송합니다.

다음과 같이 지금까지 주문한 내역을 확인할 수도 있습니다.

class Creon:
def __init__(self, account_no=''):
self.obj_CpTrade_CpTd5341 = win32com.client.Dispatch('CpTrade.CpTd5341')
def get_trade_history(self):
account_no, account_gflags = self.init_trade()
self.obj_CpTrade_CpTd5341.SetInputValue(0, account_no)
self.obj_CpTrade_CpTd5341.SetInputValue(1, account_gflags[0]) # 상품구분
_fields = [0, 1, 2, 3, 4, 5, 6, 7, 8, 9, 10, 11, 12, 13, 14, 16, 17, 18, 19, 22, 24]
_keys = [
'상품관리구분코드', '주문번호', '원주문번호', '종목코드', '종목이름',
'주문내용', '주문호가구분코드내용', '주문수량', '주문단가', '총체결수량',
'체결수량', '체결단가', '확인수량', '정정취소구분내용 ', '거부사유내용',
'채권매수일', '거래세과세구분내용', '현금신용대용구분내용', '주문입력매체코드내용',
'정정취소가능수량', '매매구분',
]
result = self.request(self.obj_CpTrade_CpTd5341, dict(zip(_fields, _keys)), cntidx=6)
return result

주문 이후에 get_trade_history() 함수를 호출하면 다음과 같이 매수/매도 주문에 대한 정보들을 받아올 수 있습니다. 여기서는 삼성전자를 10주씩 매수->매도->매수한 다음 get_trade_history() 함수를 호출한 결과 입니다.

{'data': [{'상품관리구분코드': '10', '주문번호': 6095, '원주문번호': 0, '종목코드': 'A005930', '종목이름': '삼성전자', '주문내용': '정규장현금매수', '주문호가구분코드내용': '시장가', '주문수량': 10, '주문단가': 0, '총체결수량': 10, '체결수량': 10, '체결단가': 82430, '확인수량': 0, '정정취소구분내용 ': '정상주문', '거부사유내용': '', '채권매수일': '', '거래세과세구분내용': '', '현금신용대용구분내용': '', '주문입력매체코드내용': 'C8', '정정취소가능수량': 0, '매매구분': '매수'}, {'상품관리구분코드': '10', '주문번호': 6099, '원주문번호': 0, '종목코드': 'A005930', '종목이름': '삼성전자', '주문내용': '정규장현금매도', '주문호가구분코드내용': '시장가', '주문수량': 10, '주문단가': 0, '총체결수량': 10, '체결수량': 10, '체결단가': 82500, '확인수량': 0, '정정취소구분내용 ': '정상주문', '거부사유내용': '', '채권매수일': '', '거래세과세구분내용': '', '현금신용대용구분내용': '', '주문입력매체코드내용': 'C8', '정정취소가능수량': 0, '매매구분': '매도'}, {'상품관리구분코드': '10', '주문번호': 6121, '원주문번호': 0, '종목코드': 'A005930', '종목이름': '삼성전자', '주문내용': '정규장현금매수', '주문호가구분코드내용': '시장가', '주문수량': 10, '주문단가': 0, '총체결수량': 10, '체결수량': 10, '체결단가': 82500, '확인수량': 0, '정정취소구분내용 ': '정상주문', '거부사유내용': '', '채권매수일': '', '거래세과세구분내용': '', '현금신용대용구분내용': '', '주문입력매체코드내용': 'C8', '정정취소가능수량': 0, '매매구분': '매수'}]}

퀀티랩 systrader 프로젝트에서 전반적인 시스템 트레이딩 코드를 공개하고 있습니다. 앞으로 시스템 트레이딩에 필요한 주요 기능들을 퀀티랩 Github systrader 리포지토리에서 오픈소스로 개발해 나갈 예정입니다.

SysTrader의 주요 TODO 태스크는 다음과 같습니다.

  • 주요 시스템 트레이딩 기능 구현
  • 딥러닝 모델 기반 자동 매매
  • PyQt5 기반의 GUI 개발
  • 매매 현황 리포팅

관심 있으신 모든 분들께서 이 프로젝트에 참여해 주시면 감사하겠습니다. SysTrader는 모든 개미들을 위한 견고한 시스템 트레이딩 솔루션이 되는 것을 목표로 합니다.

대신증권 크레온 API로 실시간 주가 데이터 받기

이번 포스트에서는 대신증권 크레온 API를 이용한 실시간 주가를 획득하는 방법을 다룹니다. 여느 때와 같이 언어는 파이썬으로 진행합니다.

크레온 API는 문서화가 비교적 잘되어 있고 사용성이 좋습니다. [증권사 API 장단점 비교][/htsapi.html] 포스트에서 주요 증권사 API의 장단점을 비교해 놓았으니 참고하시기 바랍니다.

실시간 주가를 얻어오기 위한 모듈은 Dscbo1.StockCur이며 이에 대한 문서는 여기에서 확인할 수 있습니다.

실시간 데이터는 Publish/Subscribe 방식으로 데이터를 획득합니다. 크레온에서 실시간 주가 데이터를 발행(Publish)하고 사용자는 실시간 주가를 원하는 종목을 구독(Subscribe)합니다. 사용자는 크레온이 발행한 데이터를 콜백(callback)을 통해 받습니다.

그럼 파이썬으로 실시간 주가 데이터를 구독하는 함수와 데이터를 획득하는 콜백 함수를 구현해 보겠습니다.

import win32com.client
class Creon:
def __init__(self):
self.stockcur_handlers = {} # 주식/업종/ELW시세 subscribe event handlers
def subscribe_stockcur(self, code, cb):
if not code.startswith('A'):
code = 'A' + code
if code in self.stockcur_handlers:
return
obj = win32com.client.Dispatch('DsCbo1.StockCur')
obj.SetInputValue(0, code)
handler = win32com.client.WithEvents(obj, StockCurEventHandler)
handler.set_attrs(obj, cb)
self.stockcur_handlers[code] = obj
obj.Subscribe()
def unsubscribe_stockcur(self, code=None):
lst_code = []
if code is not None:
if not code.startswith('A'):
code = 'A' + code
if code not in self.stockcur_handlers:
return
lst_code.append(code)
else:
lst_code = list(self.stockcur_handlers.keys()).copy()
for code in lst_code:
obj = self.stockcur_handlers[code]
obj.Unsubscribe()
del self.stockcur_handlers[code]
class StockCurEventHandler:
def set_attrs(self, obj, cb):
self.obj = obj
self.cb = cb
def OnReceived(self):
item = {
'code': self.obj.GetHeaderValue(0),
'name': self.obj.GetHeaderValue(1),
'diffratio': self.obj.GetHeaderValue(2),
'timestamp': self.obj.GetHeaderValue(3),
'price_open': self.obj.GetHeaderValue(4),
'price_high': self.obj.GetHeaderValue(5),
'price_low': self.obj.GetHeaderValue(6),
'bid_sell': self.obj.GetHeaderValue(7),
'bid_buy': self.obj.GetHeaderValue(8),
'cum_volume': self.obj.GetHeaderValue(9), # 주, 거래소지수: 천주
'cum_trans': self.obj.GetHeaderValue(10),
'price': self.obj.GetHeaderValue(13),
'contract_type': self.obj.GetHeaderValue(14),
'cum_sellamount': self.obj.GetHeaderValue(15),
'buy_sellamount': self.obj.GetHeaderValue(16),
'contract_amount': self.obj.GetHeaderValue(17),
'second': self.obj.GetHeaderValue(18),
'price_type': chr(self.obj.GetHeaderValue(19)), # 1: 동시호가시간 예상체결가, 2: 장중 체결가
'market_flag': chr(self.obj.GetHeaderValue(20)), # '1': 장전예상체결, '2': 장중, '4': 장후시간외, '5': 장후예상체결
'premarket_volume': self.obj.GetHeaderValue(21),
'diffsign': chr(self.obj.GetHeaderValue(22)),
'LP보유수량':self.obj.GetHeaderValue(23),
'LP보유수량대비':self.obj.GetHeaderValue(24),
'LP보유율':self.obj.GetHeaderValue(25),
'체결상태(호가방식)':self.obj.GetHeaderValue(26),
'누적매도체결수량(호가방식)':self.obj.GetHeaderValue(27),
'누적매수체결수량(호가방식)':self.obj.GetHeaderValue(28),
}
self.cb(item)

이렇게 Creon 클래스에 실시간 주가를 구독하는 함수인 subscribe_stockcur와 구독을 취소하는 unsubscribe_stockcur 함수를 구현했습니다. subscribe_stockcur 함수에서 발행되는 주가 데이터를 처리하기 위한 StockCurEventHandler 클래스를 이어서 정의하였습니다.

subscribe_stockcur 함수에서 구독하는 종목마다 StockCurEventHandler를 할당해 주었습니다. 크레온이 주식 데이터를 발행하면 StockCurEventHandler의 OnReceived 함수가 호출됩니다.

여기서 필요한 데이터를 획득할 수 있습니다. 여기서는 이렇게 획득한 데이터를 StockCurEventHandler 객체를 생성할 때 인자로 넘겨준 cb 함수로 전달하고 있습니다.

다음과 같이 종목명과 가격을 출력하는 간단한 cb 함수를 선언하고 NAVER와 미래에셋증권 두 종목의 실시간 주가를 구독해 보았습니다.

from quantylab.systrader.creon import Creon
c = Creon()
def cb(item):
print(item['name'], item['price'])
c.subscribe_stockcur('035420', cb)
c.subscribe_stockcur('006800', cb)
# ...
c.unsubscribe_stockcur()

그러면 이런식으로 종목명과 주가가 출력되는 것을 볼 수 있습니다.

NAVER 389500
미래에셋증권 9990
미래에셋증권 10000
NAVER 390000
NAVER 389500
NAVER 389500
미래에셋증권 9990
NAVER 389500
NAVER 389500
미래에셋증권 9990
미래에셋증권 9990
미래에셋증권 9990
미래에셋증권 10000
미래에셋증권 9990
NAVER 390000
NAVER 389500
NAVER 389500
미래에셋증권 9990

퀀티랩 systrader 프로젝트에서 실시간 주가 확인 외에도 다양한 크레온 API 기능을 연결하고 있습니다. 퀀티랩 Github systrader 리포지토리에서 전체 코드를 확인할 수 있습니다. 문의는 이 리포지토리 이슈로 또는 네이버 카페로 주세요.

파이썬으로 DART에서 재무제표 수집하기

이번 포스트에서는 전자공시시스템(DART)에서 제공하는 재무제표를 파이썬으로 다운로드하고 파싱하는 방법을 다룹니다.

DART에서 재무제표를 얻어오는 방법은 다양한데 여기서는 두 가지 방법을 다룹니다.

첫 번째로 단일회사 주요계정 API를 활용한 방법입니다.

DART Open API를 사용하려면 인증키가 필요합니다. 인증키 획득 방법은 이 포스트에서 확인하세요.

다음은 단일회사 주요계정 API를 호출하여 재무제표 정보를 획득하는 함수 입니다. 인증키, 회사 고유번호, 사업연도, 보고서 코드를 입력하여 재무제표를 받아올 수 있습니다.

def get_fs(crtfc_key, corp_code, bsns_year, reprt_code):
# 단일회사 주요계정
# crtfc_key API 인증키 STRING(40) Y 발급받은 인증키(40자리)
# corp_code 고유번호 STRING(8) Y 공시대상회사의 고유번호(8자리)
# ※ 개발가이드 > 공시정보 > 고유번호 API조회 가능
# bsns_year 사업연도 STRING(1) Y 사업연도(4자리)
# ※ 2015년 이후 부터 정보제공
# reprt_code 보고서 코드 STRING(5) Y 1분기보고서 : 11013
# 반기보고서 : 11012
# 3분기보고서 : 11014
# 사업보고서 : 11011
api = 'https://opendart.fss.or.kr/api/fnlttSinglAcnt.json'
params = {
'crtfc_key': crtfc_key,
'corp_code': corp_code,
'bsns_year': bsns_year,
}
data = []
reprt_name = REPRT_NAMES.get(reprt_code, "")
params['reprt_code'] = reprt_code
res = self._request(api, params=params)
if res is None:
return None
if res.status_code != 200:
return None
item = json.loads(res.text)
if item.get('status', '') != '000':
return None
for _item in item.get('list'):
_item['corp_code'] = corp_code
_item['reprt_code'] = reprt_code
_item['reprt_name'] = reprt_name
data.append(_item)
return data

get_fs(crtfc_key, '00266961', 2015, '11011')와 같이 호출하면 다음과 같은 결과를 받아올 수 있습니다.

[{'account_nm': '자산총계', 'bfefrmtrm_amount': '9,881,190,909,324', 'bfefrmtrm_dt': '2018.12.31 현재', 'bfefrmtrm_nm': '제 20 기', 'bsns_year': '2020', 'corp_code': '00266961', 'frmtrm_amount': '12,299,527,120,786', 'frmtrm_dt': '2019.12.31 현재', 'frmtrm_nm': '제 21 기', ...}, {'account_nm': '부채총계', 'bfefrmtrm_amount': '3,932,050,396,031', 'bfefrmtrm_dt': '2018.12.31 현재', 'bfefrmtrm_nm': '제 20 기', 'bsns_year': '2020', 'corp_code': '00266961', 'frmtrm_amount': '5,795,601,052,206', 'frmtrm_dt': '2019.12.31 현재', 'frmtrm_nm': '제 21 기', ...}, ...]

DART Open API 재무정보 일괄 다운로드

섹션 제목: “DART Open API 재무정보 일괄 다운로드”

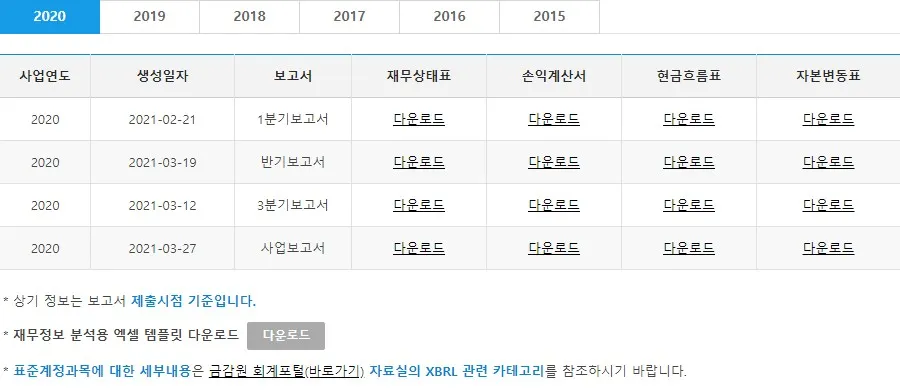
두 번째는 재무정보 일괄 다운로드로 한꺼번에 전체 기업의 재무제표 데이터를 받아오는 방법입니다. Open DART 사이트에서 공시정보 활용마당 / 재무정보 일괄다운로드를 클릭하면 다음과 같은 테이블을 볼 수 있습니다.

재무정보 일괄다운로드

여기서 다운로드 하면 해당 연도와 분기의 네 종류의 재무제표를 압축파일로 다운 받을 수 있습니다. 여기서는 다운로드, 압축해제를 포함하여 파이썬에서 재무제표를 읽어오는 방법을 다룹니다.

다음은 Selenium으로 다운로드 버튼을 클릭하여 파일을 다운로드하고 압축을 해제하는 코드입니다.

options = webdriver.ChromeOptions()
options.add_experimental_option("prefs", {
"download.default_directory": self.job_base,
"download.prompt_for_download": False,
"download.directory_upgrade": True,
"safebrowsing.enabled": True
})
options.add_argument("disable-infobars")
options.add_argument("--disable-extensions")
browser = webdriver.Chrome(executable_path=os.path.join(settings.QUANTYLAB_BASE, 'drivers/chromedriver'), chrome_options=options)
try:
browser.get('https://opendart.fss.or.kr/disclosureinfo/fnltt/dwld/main.do')
elem = browser.find_element_by_css_selector('table.tb01')
for elem_a in elem.find_elements_by_link_text('다운로드'):
filename = re.findall(r'.*\(.*\'(.+)\'\).*', elem_a.get_attribute('onclick'))[0]
# 파일 다운로드
elem_a.click()
time.sleep(10)
# 압축파일 로드
filepath = os.path.join(base, filename)
z = zipfile.ZipFile(filepath)
for info in z.infolist():
# 한글 파일명 인코딩 수정
_filename = info.filename.encode('cp437').decode('euc-kr')
_filepath = os.path.join(base, _filename)
if os.path.exists(_filepath):
continue
info.filename = _filename
# 압축해제
z.extract(info, base)
z.close()
except Exception as e:
print(str(e))
finally:
browser.quit()

이렇게 압축해제까지 하면 2020_1분기보고서_04_현금흐름표_20210211.txt과 같은 파일들이 생성되어 있을 것입니다.

이 텍스트 파일은 다음과 같이 pandas로 쉽게 DataFrame으로 읽어올 수 있습니다. 다만 sep과 encoding을 다음과 같이 적절하게 정해주는 것이 중요합니다.

df = pd.read_csv(filepath, sep='\t', encoding='cp949')

여기서 당기, 당기 1분기, 당기 반기 등의 다양한 컬럼이 생기는데 저는 이들을 당기로 통합하여 정리했습니다.

다음은 포괄손익계산서의 일부 항목을 나타낸 것입니다.

항목명결산기준일보고서종류당기
영업수익2018-12-31사업보고서5,586,904,533,355
영업이익(손실)2018-12-31사업보고서942,532,561,543
당기순이익(손실)2018-12-31사업보고서627,901,873,332

그런데 재무제표를 볼 때 항목의 흐름을 보는 것이 중요합니다. 예를 들어 영업 이익이 꾸준히 증가하고 있는지를 보고 싶은 것입니다.

그래서 동일 항목에 대해서 결산기준일 순서대로 DataFrame을 재구성하고자 합니다. 이를 위해 DataFrame의 pivot 함수를 사용합니다.

df_pivot = df.pivot(values='value', index='항목명', columns='결산기준일')

동일 항목이지만 항목명이 다르게 적혀있는 경우가 있어서 이를 맞춰주는 처리를 했습니다.

그럼 다음과 같이 동일 항목의 값을 분기 순서대로 볼 수 있습니다.

항목명2015-12-312016-03-312016-06-302016-09-302016-12-312017-03-312017-06-302017-09-302017-12-312018-03-312018-06-302018-09-302018-12-312019-03-312019-06-302019-09-302019-12-312020-03-312020-06-302020-09-30
매출액3,251,157,100,000937,280,220,152987,281,364,2951,013,075,223,7704,022,629,619,9821,082,247,281,1961,129,631,366,8471,200,676,275,2204,678,468,928,0321,309,059,864,2481,363,615,953,3321,397,713,834,6745,586,904,533,3551,510,861,770,2821,630,275,004,3951,664,815,000,0786,593,400,065,2441,732,064,462,0971,902,467,957,4911,360,779,374,259
영업이익762,203,849,000256,827,536,675272,663,961,847282,298,051,5251,102,040,475,792290,797,289,304285,213,522,180312,084,238,4441,179,187,806,331256,980,563,870250,583,189,279221,718,402,565942,532,561,543206,244,504,954128,334,709,480202,086,039,366710,070,173,513221,495,078,328230,597,573,115291,726,798,004
당기순이익516,986,279,000165,036,146,535213,223,506,226198,000,157,034759,072,951,187210,876,050,870171,420,229,303215,798,264,368770,101,670,207153,751,654,038281,758,577,70168,386,763,908627,901,873,33287,585,903,29027,756,852,97585,268,053,088396,821,062,465134,874,581,86590,682,203,810235,342,965,699

기술적 분석 라이브러리 TA-LIB Python Wrapper

기술적 분석(Technical Analysis)는 과거 축적된 주가와 거래량 등을 분석하여 미래 주가의 방향성을 예측하는 분석 방법입니다. 대표적인 보조지표(Indicator)로 이동평균(Moving Average), 볼린저밴드(Bollinger Band), Moving Average Convergence Divergence(MACD), Relative Strength Index(RSI) 등이 있습니다.

보조지표들 외에도 차트에서 패턴을 알아내기도 합니다. 대표적인 패턴으로 Three Line Strike, Two Black Gapping, Three Black Crows, Evening Star, Abandoned Baby 등이 있습니다.

이번 포스트에서는 기술적 분석 라이브러리인 TA-LIB의 Python Wrapper에 대해서 소개하고자 합니다. TA-LIB를 이용하면 이동평균, 볼린저밴드, MACD, RSI 등의 대표적인 기술적 분석 보조지표를 쉽게 계산할 수 있고 다양한 차트 패턴을 포착할 수 있습니다. 자세한 기능은 이 문서에서 확인할 수 있습니다.

우분투 환경에서 TA-LIB 설치를 진행합니다.

Terminal window
wget http://prdownloads.sourceforge.net/ta-lib/ta-lib-0.4.0-src.tar.gz
tar -xzf ta-lib-0.4.0-src.tar.gz
cd ta-lib/
./configure --prefix=/usr
make
sudo make install

다음과 같이 make가 없다는 메시지가 뜬다면 make를 먼서 설치하고 다시 make 명령을 실행하면 됩니다.

Command 'make' not found, but can be installed with:
sudo apt install make
sudo apt install make-guile

이제 TA-LIB 파이썬 라이브러리를 설치하면 됩니다. TA-LIB이 설치되어 있어야 TA-LIB 파이썬 라이브러리를 설치할 수 있습니다.

Terminal window
pip install ta-lib

TA-LIB 파이썬 라이브러리를 이용하여 볼린저밴드를 추가해 보겠습니다. 먼저 다음과 같은 OHLCV(Open-High-Low-Close-Volume) 데이터, 즉 봉차트가 있습니다.

import pandas as pd
df = pd.read_csv('chart.csv')
closecodedatediffdiffratiodiffsignhighlowopenpricevolume
46200.0593020180823100.0NaN246200.045700.046150.03093430000006730918
46150.0593020180824-50.0NaN546400.045550.045900.03022130000006582535
46300.0593020180827150.00.325027246550.046000.046100.02436960000005263782
46550.0593020180828250.00.539957246950.046300.046800.03433230000007365976
46800.0593020180829250.00.537057246800.046400.046750.02599640000005572374
47650.0593020180830850.01.816239247950.046700.046950.058025900000012193231
48450.0593020180831800.01.678909248450.047000.047100.065231800000013577454
……………………………
43500.0593020190806-450.0-1.023891543800.042500.042500.065480500000015083824
43200.0593020190807-300.0-0.689655543900.043100.043600.043450000000010002533
42650.0593020190808-550.0-1.273148543500.042650.043250.072807400000016926881
43150.0593020190809500.01.172333243350.043050.043250.04187190000009685147
43700.0593020190812550.01.274623244000.043550.044000.03705310000008466169
43000.0593020190813-700.0-1.601831543500.042950.043500.03141910000007276979
43700.0593020190814700.01.601831244250.043500.043900.03834270000008750135

TA-LIB 파이썬 라이브러리 모듈 이름은 talib 입니다. talib을 임포트하고 볼린저밴드를 구하는 함수를 호출합니다. 이 문서에서 함수들의 Signature를 확인할 수 있습니다.

upperband, middleband, lowerband = BBANDS(close, timeperiod=5, nbdevup=2, nbdevdn=2, matype=0)

이렇게 Upper Bollinger Band, Middle Bollinger Band, Lower Bollinger Band를 쉽게 구할 수 있습니다.

import talib
ubb, mbb, lbb = talib.BBANDS(df.close, 20, 2)
df['ubb'] = ubb
df['mbb'] = mbb
df['lbb'] = lbb
closecodedatediffdiffratiodiffsignhighlowopenpricevolumeubbmbblbb
46200.0593020180823100.0NaN246200.045700.046150.03093430000006730918NaNNaNNaN
46150.0593020180824-50.0NaN546400.045550.045900.03022130000006582535NaNNaNNaN
46300.0593020180827150.00.325027246550.046000.046100.02436960000005263782NaNNaNNaN
46550.0593020180828250.00.539957246950.046300.046800.03433230000007365976NaNNaNNaN
46800.0593020180829250.00.537057246800.046400.046750.02599640000005572374NaNNaNNaN
47650.0593020180830850.01.816239247950.046700.046950.058025900000012193231NaNNaNNaN
48450.0593020180831800.01.678909248450.047000.047100.065231800000013577454NaNNaNNaN
……………………………………
43500.0593020190806-450.0-1.023891543800.042500.042500.06548050000001508382448098.40053746057.544016.599463
43200.0593020190807-300.0-0.689655543900.043100.043600.04345000000001000253348325.70744245940.043554.292558
42650.0593020190808-550.0-1.273148543500.042650.043250.07280740000001692688148540.42638545762.542984.573615
43150.0593020190809500.01.172333243350.043050.043250.0418719000000968514748592.45711345605.042617.542887
43700.0593020190812550.01.274623244000.043550.044000.0370531000000846616948538.70090545467.542396.299095
43000.0593020190813-700.0-1.601831543500.042950.043500.0314191000000727697948456.11615645275.042093.883844
43700.0593020190814700.01.601831244250.043500.043900.0383427000000875013548388.64143945157.541926.358561

파이썬으로 Maximum Drawdown (MDD) 확인하기

Maximum Drawdown (MDD)는 특정 기간동안 발생한 최대 낙폭을 의미하는 하방 리스크 지표 입니다. MDD가 클수록 투자 리스크가 크기 때문에 유의해야 합니다.

MDD = (기간 동안의 최저점 - 기간 동안의 최고점) / 기간 동안의 최고점으로 간단히 구할 수 있습니다.

파이썬에서 MDD를 다음과 같이 구할 수 있습니다.

import numpy as np
def get_mdd(x):
"""
MDD(Maximum Draw-Down)
:return: (peak_upper, peak_lower, mdd rate)
"""
arr_v = np.array(x)
peak_lower = np.argmax(np.maximum.accumulate(arr_v) - arr_v)
peak_upper = np.argmax(arr_v[:peak_lower])
return peak_upper, peak_lower, (arr_v[peak_lower] - arr_v[peak_upper]) / arr_v[peak_upper]
data = [['20190219', 125000.0, 127500.0, 123500.0, 126000.0, 57757], ['20190220', 125000.0, 127000.0, 124500.0, 126000.0, 68453], ['20190221', 125500.0, 126000.0, 124000.0, 125000.0, 43961], ['20190222', 125000.0, 125000.0, 123500.0, 125000.0, 31065], ['20190225', 125500.0, 126000.0, 124000.0, 125500.0, 45852], ['20190226', 125000.0, 127000.0, 124500.0, 126500.0, 37404], ['20190227', 126500.0, 127000.0, 124500.0, 126000.0, 36131], ['20190228', 126500.0, 127000.0, 124500.0, 125000.0, 69474], ['20190304', 124500.0, 125500.0, 122500.0, 123500.0, 65517], ['20190305', 123000.0, 125000.0, 122000.0, 124500.0, 35186], ['20190306', 124000.0, 124500.0, 122500.0, 123500.0, 35449], ['20190307', 123500.0, 124000.0, 122000.0, 123500.0, 34768], ['20190308', 122500.0, 122500.0, 120500.0, 121500.0, 35118], ['20190311', 121500.0, 122500.0, 120000.0, 122500.0, 39576], ['20190312', 123000.0, 124000.0, 122000.0, 123500.0, 24117], ['20190313', 123000.0, 123500.0, 121500.0, 123500.0, 37649], ['20190314', 123000.0, 124000.0, 122000.0, 123500.0, 95132], ['20190315', 123000.0, 128000.0, 123000.0, 126500.0, 107246], ['20190318', 127000.0, 131000.0, 126500.0, 131000.0, 74644], ['20190319', 130000.0, 134000.0, 129500.0, 133000.0, 68348], ['20190320', 132000.0, 133000.0, 129500.0, 131000.0, 42697], ['20190321', 130000.0, 132000.0, 127500.0, 128500.0, 54018], ['20190322', 127500.0, 129500.0, 126500.0, 127000.0, 32380], ['20190325', 125500.0, 126500.0, 124000.0, 124500.0, 37185], ['20190326', 124500.0, 125500.0, 123500.0, 124000.0, 45161], ['20190327', 124000.0, 125000.0, 123500.0, 124000.0, 34336], ['20190328', 124000.0, 124500.0, 120500.0, 121500.0, 43518], ['20190329', 122500.0, 125000.0, 122000.0, 124500.0, 39035], ['20190401', 124000.0, 126500.0, 124000.0, 126500.0, 22463], ['20190402', 125500.0, 126500.0, 123500.0, 126000.0, 31754], ['20190403', 124500.0, 128000.0, 124500.0, 128000.0, 36250], ['20190404', 128500.0, 128500.0, 126000.0, 128000.0, 34854], ['20190405', 127500.0, 129000.0, 126000.0, 127500.0, 33513], ['20190408', 127500.0, 128000.0, 126000.0, 128000.0, 39005], ['20190409', 128000.0, 129000.0, 127500.0, 128500.0, 33266], ['20190410', 128000.0, 129000.0, 126500.0, 128000.0, 64476], ['20190411', 128500.0, 129000.0, 125000.0, 125000.0, 84802], ['20190412', 126000.0, 127500.0, 125500.0, 127000.0, 39663], ['20190415', 126500.0, 128500.0, 126000.0, 127000.0, 61140], ['20190416', 127000.0, 129000.0, 126500.0, 128500.0, 40123], ['20190417', 128500.0, 129000.0, 127000.0, 128000.0, 30846], ['20190418', 128000.0, 128500.0, 124000.0, 124500.0, 55346], ['20190419', 124500.0, 125000.0, 122000.0, 123000.0, 53439], ['20190422', 123000.0, 123500.0, 121000.0, 122500.0, 30421], ['20190423', 122500.0, 123500.0, 120500.0, 121500.0, 54997], ['20190424', 122500.0, 122500.0, 119500.0, 120000.0, 63486], ['20190425', 121000.0, 121000.0, 118500.0, 119000.0, 36046], ['20190426', 118500.0, 119500.0, 117000.0, 119000.0, 43749], ['20190429', 119000.0, 119500.0, 117000.0, 119500.0, 33516], ['20190430', 122000.0, 123000.0, 119000.0, 119500.0, 94118], ['20190502', 118500.0, 122000.0, 118000.0, 121000.0, 56723], ['20190503', 121000.0, 122000.0, 119500.0, 120000.0, 35240], ['20190507', 118500.0, 119500.0, 117000.0, 117500.0, 44453], ['20190508', 116500.0, 117000.0, 115000.0, 116500.0, 52805], ['20190509', 117000.0, 117000.0, 113000.0, 113000.0, 116012], ['20190510', 113000.0, 114500.0, 110000.0, 111500.0, 86072], ['20190513', 110500.0, 110500.0, 107500.0, 108500.0, 70847], ['20190514', 107500.0, 108000.0, 105000.0, 106500.0, 92820], ['20190515', 107000.0, 107500.0, 105000.0, 107000.0, 68937], ['20190516', 107000.0, 107500.0, 104000.0, 105000.0, 64047]]
import pandas as pd
df = pd.DataFrame(data, columns=['date', 'open', 'high', 'low', 'close', 'volume'])
mdd = get_mdd(df['close'])
(19, 59, -0.21052631578947367)
import matplotlib.pyplot as plt
import matplotlib.gridspec as gridspec
fig = plt.figure(figsize=(8, 5))
fig.set_facecolor('w')
gs = gridspec.GridSpec(2, 1, height_ratios=[3, 1])
axes = []
axes.append(plt.subplot(gs[0]))
axes.append(plt.subplot(gs[1], sharex=axes[0]))
axes[0].get_xaxis().set_visible(False)
from mpl_finance import candlestick_ohlc
x = np.arange(len(df.index))
ohlc = df[['open', 'high', 'low', 'close']].astype(int).values
dohlc = np.hstack((np.reshape(x, (-1, 1)), ohlc))
# 봉차트
candlestick_ohlc(axes[0], dohlc, width=0.5, colorup='r', colordown='b')
# 거래량 차트
axes[1].bar(x, df.volume, color='k', width=0.6, align='center')
import datetime
_xticks = []
_xlabels = []
_wd_prev = 0
for _x, d in zip(x, df.date.values):
weekday = datetime.datetime.strptime(str(d), '%Y%m%d').weekday()
if weekday <= _wd_prev:
_xticks.append(_x)
_xlabels.append(datetime.datetime.strptime(str(d), '%Y%m%d').strftime('%m/%d'))
_wd_prev = weekday
axes[1].set_xticks(_xticks)
axes[1].set_xticklabels(_xlabels, rotation=45, minor=False)
# MDD 그리기
axes[0].plot(mdd[:2], df.loc[mdd[:2], 'close'], 'k')
plt.tight_layout()
plt.show()

mdd

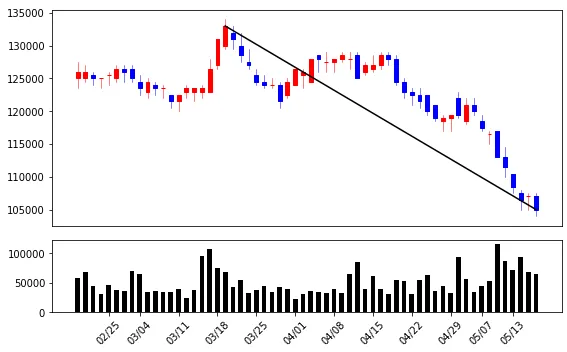
이 차트에서는 약 -21%의 MDD가 발생했습니다. 포트폴리오를 구성할 때 보유하고자 하는 종목들의 MDD를 전체적으로 확인해보는 것이 좋습니다. 특히 보유하고자 하는 종목 수가 적을수록 MDD가 낮은 종목을 보유하는 것이 안전할 것입니다.

bokeh로 봉차트(Candlestick Chart) 그리기

파이썬에서 봉차트를 제공하는 라이브러리가 많지 않습니다. 필자는 matplotlib에서 떨어져 나온 mpl_finance와 bokeh 정도로 알고 있습니다. 이미 mpl_finance로 봉차트를 그리는 방법은 이전 포스트 Matplotlib으로 봉차트(Candlestick Chart) 그리기 에서 다루었습니다.

이번 포스트에서 bokeh로 봉차트를 그리는 방법에 대해서 다루겠습니다. bokeh는 Anaconda에서 개발 중인 차트 라이브러리 입니다. matplotlib과 matplotlib 기반인 seaborn과는 다르게 독자 노선을 가지는 라이브러리 입니다. bokeh는 웹에 최적화 되어있는 라이브러리 입니다. matplotlib을 웹브라우저에 띄우려면 차트를 png 등의 그림으로 변환하여 보여줘야 해서 응답형(reponsible) 차트를 웹에 띄우기가 어렵습니다. 그래서 보통 웹에 차트를 띄울 때는 데이터만 서버에서 받고 Chart.js와 D3.js 같은 자바스크립트 라이브러리를 사용하여 데이터를 가시화 합니다. bokeh는 파이썬에서 차트를 가시화하고 그 결과를 쉽게 웹에 띄울 수 있는 여러 방법을 제공합니다. 이 포스트에서는 다루지 않겠습니다.

bokeh에서 봉차트를 제공하고 있습니다. bokeh 봉차트 문서에서 상세한 정보를 확인해 보세요.

먼저 Anaconda3가 설치되어 있는 상태라 가정하고 글을 이어나가겠습니다. Jupyter Lab(Notebook)에서 bokeh가 잘 설치되어 있는지 확인합니다.

from bokeh.io import output_notebook, show
from bokeh.plotting import figure, gridplot
output_notebook()

BokehJS 0.12.16 successfully loaded.

이렇게 로딩이 성공되었다는 메시지가 뜨는지 확인합니다. 만약 다음과 같은 메시지가 뜬다면 Jupyter Lab의 Extension을 설치해야 합니다.

Loading BokehJS ...
JavaScript output is disabled in JupyterLab

Anaconda Prompt에서 다음과 같이 jupyterlab_bokeh 확장을 설치합니다.

Terminal window
jupyter labextension install jupyterlab_bokeh

설치가 되지 않는다면 아마도 node.js가 설치되어 있지 않아서일 것입니다. 그렇다면 conda install nodejs를 통해 먼저 node.js를 설치하고 다시 jupyterlab_bokeh 확장을 설치합니다.

bokeh가 잘 설치되어 있다면 이제 봉차트를 그릴 준비가 되었습니다. 차트 데이터는 다음과 같이 ['date', 'open', 'high', 'low', 'close', 'volume']의 리스트로 있습니다.

import pandas as pd
data = [['20190219', 125000.0, 127500.0, 123500.0, 126000.0, 57757], ['20190220', 125000.0, 127000.0, 124500.0, 126000.0, 68453], ['20190221', 125500.0, 126000.0, 124000.0, 125000.0, 43961], ['20190222', 125000.0, 125000.0, 123500.0, 125000.0, 31065], ['20190225', 125500.0, 126000.0, 124000.0, 125500.0, 45852], ['20190226', 125000.0, 127000.0, 124500.0, 126500.0, 37404], ['20190227', 126500.0, 127000.0, 124500.0, 126000.0, 36131], ['20190228', 126500.0, 127000.0, 124500.0, 125000.0, 69474], ['20190304', 124500.0, 125500.0, 122500.0, 123500.0, 65517], ['20190305', 123000.0, 125000.0, 122000.0, 124500.0, 35186], ['20190306', 124000.0, 124500.0, 122500.0, 123500.0, 35449], ['20190307', 123500.0, 124000.0, 122000.0, 123500.0, 34768], ['20190308', 122500.0, 122500.0, 120500.0, 121500.0, 35118], ['20190311', 121500.0, 122500.0, 120000.0, 122500.0, 39576], ['20190312', 123000.0, 124000.0, 122000.0, 123500.0, 24117], ['20190313', 123000.0, 123500.0, 121500.0, 123500.0, 37649], ['20190314', 123000.0, 124000.0, 122000.0, 123500.0, 95132], ['20190315', 123000.0, 128000.0, 123000.0, 126500.0, 107246], ['20190318', 127000.0, 131000.0, 126500.0, 131000.0, 74644], ['20190319', 130000.0, 134000.0, 129500.0, 133000.0, 68348], ['20190320', 132000.0, 133000.0, 129500.0, 131000.0, 42697], ['20190321', 130000.0, 132000.0, 127500.0, 128500.0, 54018], ['20190322', 127500.0, 129500.0, 126500.0, 127000.0, 32380], ['20190325', 125500.0, 126500.0, 124000.0, 124500.0, 37185], ['20190326', 124500.0, 125500.0, 123500.0, 124000.0, 45161], ['20190327', 124000.0, 125000.0, 123500.0, 124000.0, 34336], ['20190328', 124000.0, 124500.0, 120500.0, 121500.0, 43518], ['20190329', 122500.0, 125000.0, 122000.0, 124500.0, 39035], ['20190401', 124000.0, 126500.0, 124000.0, 126500.0, 22463], ['20190402', 125500.0, 126500.0, 123500.0, 126000.0, 31754], ['20190403', 124500.0, 128000.0, 124500.0, 128000.0, 36250], ['20190404', 128500.0, 128500.0, 126000.0, 128000.0, 34854], ['20190405', 127500.0, 129000.0, 126000.0, 127500.0, 33513], ['20190408', 127500.0, 128000.0, 126000.0, 128000.0, 39005], ['20190409', 128000.0, 129000.0, 127500.0, 128500.0, 33266], ['20190410', 128000.0, 129000.0, 126500.0, 128000.0, 64476], ['20190411', 128500.0, 129000.0, 125000.0, 125000.0, 84802], ['20190412', 126000.0, 127500.0, 125500.0, 127000.0, 39663], ['20190415', 126500.0, 128500.0, 126000.0, 127000.0, 61140], ['20190416', 127000.0, 129000.0, 126500.0, 128500.0, 40123], ['20190417', 128500.0, 129000.0, 127000.0, 128000.0, 30846], ['20190418', 128000.0, 128500.0, 124000.0, 124500.0, 55346], ['20190419', 124500.0, 125000.0, 122000.0, 123000.0, 53439], ['20190422', 123000.0, 123500.0, 121000.0, 122500.0, 30421], ['20190423', 122500.0, 123500.0, 120500.0, 121500.0, 54997], ['20190424', 122500.0, 122500.0, 119500.0, 120000.0, 63486], ['20190425', 121000.0, 121000.0, 118500.0, 119000.0, 36046], ['20190426', 118500.0, 119500.0, 117000.0, 119000.0, 43749], ['20190429', 119000.0, 119500.0, 117000.0, 119500.0, 33516], ['20190430', 122000.0, 123000.0, 119000.0, 119500.0, 94118], ['20190502', 118500.0, 122000.0, 118000.0, 121000.0, 56723], ['20190503', 121000.0, 122000.0, 119500.0, 120000.0, 35240], ['20190507', 118500.0, 119500.0, 117000.0, 117500.0, 44453], ['20190508', 116500.0, 117000.0, 115000.0, 116500.0, 52805], ['20190509', 117000.0, 117000.0, 113000.0, 113000.0, 116012], ['20190510', 113000.0, 114500.0, 110000.0, 111500.0, 86072], ['20190513', 110500.0, 110500.0, 107500.0, 108500.0, 70847], ['20190514', 107500.0, 108000.0, 105000.0, 106500.0, 92820], ['20190515', 107000.0, 107500.0, 105000.0, 107000.0, 68937], ['20190516', 107000.0, 107500.0, 104000.0, 105000.0, 64047]]
df = pd.DataFrame(data, columns=['date', 'open', 'high', 'low', 'close', 'volume'])
dateopenhighlowclosevolume
20190219125000.0127500.0123500.0126000.057757
20190220125000.0127000.0124500.0126000.068453
20190221125500.0126000.0124000.0125000.043961
20190222125000.0125000.0123500.0125000.031065
20190225125500.0126000.0124000.0125500.045852
20190226125000.0127000.0124500.0126500.037404
20190227126500.0127000.0124500.0126000.036131
20190228126500.0127000.0124500.0125000.069474
20190304124500.0125500.0122500.0123500.065517
20190305123000.0125000.0122000.0124500.035186
20190306124000.0124500.0122500.0123500.035449
20190307123500.0124000.0122000.0123500.034768
20190308122500.0122500.0120500.0121500.035118
20190311121500.0122500.0120000.0122500.039576
20190312123000.0124000.0122000.0123500.024117
20190313123000.0123500.0121500.0123500.037649
20190314123000.0124000.0122000.0123500.095132
20190315123000.0128000.0123000.0126500.0107246
20190318127000.0131000.0126500.0131000.074644
20190319130000.0134000.0129500.0133000.068348
20190320132000.0133000.0129500.0131000.042697
20190321130000.0132000.0127500.0128500.054018
20190322127500.0129500.0126500.0127000.032380
20190325125500.0126500.0124000.0124500.037185
20190326124500.0125500.0123500.0124000.045161
20190327124000.0125000.0123500.0124000.034336
20190328124000.0124500.0120500.0121500.043518
20190329122500.0125000.0122000.0124500.039035
20190401124000.0126500.0124000.0126500.022463
20190402125500.0126500.0123500.0126000.031754
20190403124500.0128000.0124500.0128000.036250
20190404128500.0128500.0126000.0128000.034854
20190405127500.0129000.0126000.0127500.033513
20190408127500.0128000.0126000.0128000.039005
20190409128000.0129000.0127500.0128500.033266
20190410128000.0129000.0126500.0128000.064476
20190411128500.0129000.0125000.0125000.084802
20190412126000.0127500.0125500.0127000.039663
20190415126500.0128500.0126000.0127000.061140
20190416127000.0129000.0126500.0128500.040123
20190417128500.0129000.0127000.0128000.030846
20190418128000.0128500.0124000.0124500.055346
20190419124500.0125000.0122000.0123000.053439
20190422123000.0123500.0121000.0122500.030421
20190423122500.0123500.0120500.0121500.054997
20190424122500.0122500.0119500.0120000.063486
20190425121000.0121000.0118500.0119000.036046
20190426118500.0119500.0117000.0119000.043749
20190429119000.0119500.0117000.0119500.033516
20190430122000.0123000.0119000.0119500.094118
20190502118500.0122000.0118000.0121000.056723
20190503121000.0122000.0119500.0120000.035240
20190507118500.0119500.0117000.0117500.044453
20190508116500.0117000.0115000.0116500.052805
20190509117000.0117000.0113000.0113000.0116012
20190510113000.0114500.0110000.0111500.086072
20190513110500.0110500.0107500.0108500.070847
20190514107500.0108000.0105000.0106500.092820
20190515107000.0107500.0105000.0107000.068937
20190516107000.0107500.0104000.0105000.064047

bokeh를 이용해 봉차트를 그려봅니다. 먼저 데이터에서 양봉과 음봉에 대한 mask를 저장합니다.

inc = df.close >= df.open
dec = df.open > df.close

inc는 양봉, dec는 음봉에 해당합니다. 이제 봉들을 그려줍니다. 하나의 봉은 bokeh에서 segment와 vbar로 구성되어 있습니다. segment는 high와 low까지 선으로 그은 봉의 꼬리를 그리는데 사용됩니다. vbar로는 봉의 몸통을 그립니다.

p_candlechart = figure(plot_width=1050, plot_height=200, x_range=(-1, len(df)), tools="crosshair")
p_candlechart.segment(df.index[inc], df.high[inc], df.index[inc], df.low[inc], color="red")
p_candlechart.segment(df.index[dec], df.high[dec], df.index[dec], df.low[dec], color="blue")
p_candlechart.vbar(df.index[inc], 0.5, df.open[inc], df.close[inc], fill_color="red", line_color="red")
p_candlechart.vbar(df.index[dec], 0.5, df.open[dec], df.close[dec], fill_color="blue", line_color="blue")

봉차트 밑에 거래량 막대차트(Bar Chart)까지 그려 줍니다. 이 때도 vbar를 사용하면 됩니다.

p_volumechart = figure(plot_width=1050, plot_height=100, x_range=p_candlechart.x_range, tools="crosshair")
p_volumechart.vbar(df.index, 0.5, df.volume, fill_color="black", line_color="black")

그리고 마지막으로 위 차트들을 gridplot으로 배치하여 가시화합니다.

p = gridplot([[p_candlechart], [p_volumechart]], toolbar_location=None)
show(p)

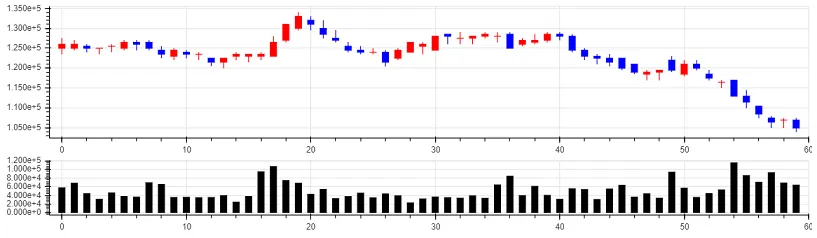
이 코드들을 모아서 다음과 같은 봉차트를 그릴 수 있습니다.

from bokeh.io import show, output_file
from bokeh.plotting import figure
from bokeh.layouts import gridplot
inc = df.close >= df.open
dec = df.open > df.close
p_candlechart = figure(plot_width=1050, plot_height=200, x_range=(-1, len(df)), tools="crosshair")
p_candlechart.segment(df.index[inc], df.high[inc], df.index[inc], df.low[inc], color="red")
p_candlechart.segment(df.index[dec], df.high[dec], df.index[dec], df.low[dec], color="blue")
p_candlechart.vbar(df.index[inc], 0.5, df.open[inc], df.close[inc], fill_color="red", line_color="red")
p_candlechart.vbar(df.index[dec], 0.5, df.open[dec], df.close[dec], fill_color="blue", line_color="blue")
p_volumechart = figure(plot_width=1050, plot_height=100, x_range=p_candlechart.x_range, tools="crosshair")
p_volumechart.vbar(df.index, 0.5, df.volume, fill_color="black", line_color="black")
p = gridplot([[p_candlechart], [p_volumechart]], toolbar_location=None)
show(p)

chart1

그러나 여기서 각 axis에 표시된 레이블들이 유용한 정보를 주지 못하고 있습니다. 좀 더 보기 좋게 레이블들을 포메팅 해보겠습니다.

p_candlechart.yaxis[0].formatter = NumeralTickFormatter(format='0,0')
p_candlechart.xaxis.visible = False

p_candlechart의 y 레이블을 다음과 같이 천단위로 콤마를 붙인 숫자로 표현합니다.

여기서 x 레이블은 거래량 차트에만 표시하기 위해서 숨기도록 합니다.

p_volumechart의 x 레이블을 날짜로 표현하고 y 레이블을 숫자로 표현합니다.

major_label = {
i: date.strftime('%Y%m%d') for i, date in enumerate(pd.to_datetime(df["date"]))
}
major_label.update({len(df): ''})
p_volumechart.xaxis.major_label_overrides = major_label
p_volumechart.yaxis[0].formatter = NumeralTickFormatter(format='0,0')

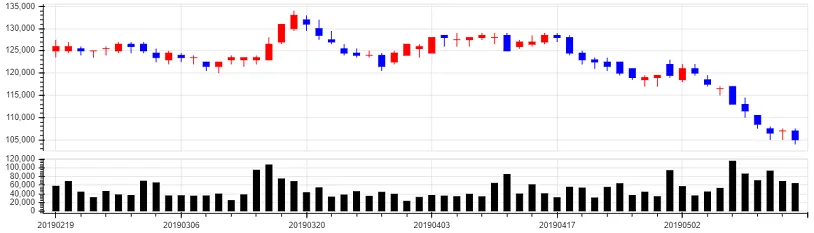
x 레이블의 마지막 값은 잘려서 나와서 숨겼습니다. 이제 이 코드들을 추가해서 다시 봉차트를 그려봅니다.

from bokeh.io import show, output_file
from bokeh.plotting import figure
from bokeh.layouts import gridplot
from bokeh.models.formatters import NumeralTickFormatter
inc = df.close >= df.open
dec = df.open > df.close
p_candlechart = figure(plot_width=1050, plot_height=200, x_range=(-1, len(df)), tools="crosshair")
p_candlechart.segment(df.index[inc], df.high[inc], df.index[inc], df.low[inc], color="red")
p_candlechart.segment(df.index[dec], df.high[dec], df.index[dec], df.low[dec], color="blue")
p_candlechart.vbar(df.index[inc], 0.5, df.open[inc], df.close[inc], fill_color="red", line_color="red")
p_candlechart.vbar(df.index[dec], 0.5, df.open[dec], df.close[dec], fill_color="blue", line_color="blue")
p_candlechart.yaxis[0].formatter = NumeralTickFormatter(format='0,0')
p_candlechart.xaxis.visible = False
p_volumechart = figure(plot_width=1050, plot_height=100, x_range=p_candlechart.x_range, tools="crosshair")
p_volumechart.vbar(df.index, 0.5, df.volume, fill_color="black", line_color="black")
major_label = {
i: date.strftime('%Y%m%d') for i, date in enumerate(pd.to_datetime(df["date"]))
}
major_label.update({len(df): ''})
p_volumechart.xaxis.major_label_overrides = major_label
p_volumechart.yaxis[0].formatter = NumeralTickFormatter(format='0,0')
p = gridplot([[p_candlechart], [p_volumechart]], toolbar_location=None)
show(p)

chart2

이렇게 x축은 날짜가, y축은 숫자가 보기좋게 나오게 됩니다. 이 차트를 html, json 등으로 웹에 넣어줄 수 있습니다. 자세한 사항은 bokeh 문서 Embedding Plots and Apps를 확인해 주세요.

아나콘다(Anaconda) 32bit 환경 설치하기

아나콘다는 파이썬 및 데이터 과학(data science) 패키지가 포함된 배포판 입니다. 기본적으로 아나콘다는 64bit 버전을 제공하고 있습니다.

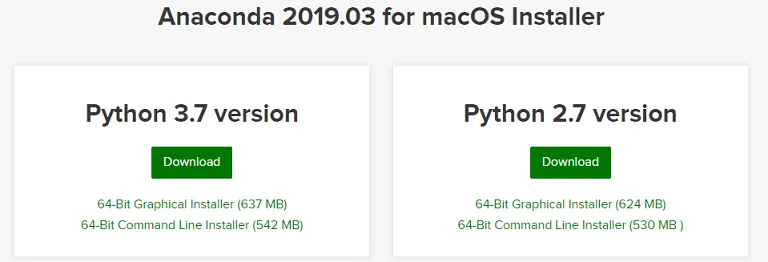
anaconda

그러나 시스템 트레이딩과 같이 Windows 환경에서 다른 프로그램들과 통신할 때 32bit 버전이 필요한 경우가 종종 있습니다. 이번 포스트에서는 아나콘다에서 32bit 파이썬 환경을 구성하는 방법에 대해서 다룹니다.

먼저 64bit 버전의 아나콘다를 다운받아서 설치합니다. 아나콘다 다운로드 페이지에서 최신 버전의 아나콘다를 받을 수 있습니다.

Anaconda Prompt를 열고 다음과 같이 명령을 입력합니다.

Terminal window
set CONDA_FORCE_32BIT=1
conda create -n py37_32 python=3.7 anaconda

설치하는데 시간이 꽤 걸릴 것이니 차분히 기다립니다. 여기서 python=3.7부분을 수정하여 원하는 버전을 설치할 수 있습니다.

설치가 완료되면 이제 32bit 버전의 파이썬을 사용할 수 있습니다. 다음과 같이 좀전에 설치한 파이썬 32bit 환경을 활성화 시키면 됩니다.

Terminal window
activate py37_32

프롬프트 커맨드 라인 처음에 (py37_32)가 표시되어 있으면 활성화가 제대로 된 것입니다. 이 환경을 비활성화 시키려면 다음과 같이 명령하면 됩니다.

Terminal window
deactivate

참고로 리눅스 운영체제에서는 source activate py37_32, source deactivate와 같이 명령을 줘야 합니다.

파이썬으로 크레온 플러스(Creon Plus) 자동 로그인하기

시스템 트레이딩에 관심 있는 분들이라면 주식투자 자동화에도 관심이 있을 것입니다. 주식투자 자동화의 첫걸음은 증권사 HTS API 자동 로그인 입니다. 증권사 HTS마다 그 방법이 다르며 이번 포스트에서는 대신증권의 크레온 플러스를 파이썬에서 자동으로 로그인하는 방법을 다루겠습니다.

크레온 다운로드센터에서 CREON HTS를 다운받습니다. CREON HTS에 CREON Plus가 포함되어 있습니다. 설치 과정은 생략하겠습니다.

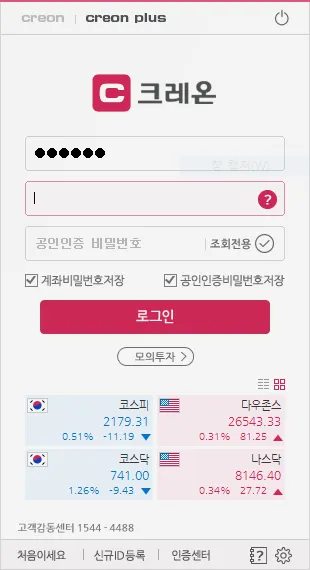
크레온 HTS를 실행하면 다음과 같은 로그인 창이 나타날 것입니다. 직접 크레온 HTS에 로그인하여 API를 사용할 때는 로그인 창 상단에 creon plus 버튼을 누르고 ID, 비밀번호, 공인인증 비밀번호(조회전용이 아닌 경우)를 입력하여 로그인 버튼을 누르면 됩니다.

크레온 로그인 창

이제 파이썬에서 크레온 HTS에 자동으로 로그인하기 위한 준비를 합니다.

파이썬 32bit 환경은 아나콘다를 설치 후에 32bit 환경을 설치하는 것을 권장합니다. 그 방법은 이 포스트를 참고 바랍니다.

커맨드 창에서 다음 pip 명령으로 pywinauto와 pywin32를 설치합니다.

Terminal window
pip install pywinauto
pip install pywin32

크레온 API를 감싸는(wrapping) 클래스를 만들겠습니다.

import win32com.client
from pywinauto import application
class Creon:
def __init__(self):
self.obj_CpUtil_CpCybos = win32com.client.Dispatch('CpUtil.CpCybos')
def kill_client(self):
os.system('taskkill /IM coStarter* /F /T')
os.system('taskkill /IM CpStart* /F /T')
os.system('taskkill /IM DibServer* /F /T')
os.system('wmic process where "name like \'%coStarter%\'" call terminate')
os.system('wmic process where "name like \'%CpStart%\'" call terminate')
os.system('wmic process where "name like \'%DibServer%\'" call terminate')
def connect(self, id_, pwd, pwdcert):
if not self.connected():
self.disconnect()
self.kill_client()
app = application.Application()
app.start(
'C:\CREON\STARTER\coStarter.exe /prj:cp /id:{id} /pwd:{pwd} /pwdcert:{pwdcert} /autostart'.format(
id=id_, pwd=pwd, pwdcert=pwdcert
)
)
while not self.connected():
time.sleep(1)
return True
def connected(self):
b_connected = self.obj_CpUtil_CpCybos.IsConnect
if b_connected == 0:
return False
return True
def disconnect(self):
if self.connected():
self.obj_CpUtil_CpCybos.PlusDisconnect()

Creon 클래스는 자동 로그인 기능을 위해 다음 함수들을 가집니다.

  • kill_client: 실행중인 크레온 HTS 프로그램을 종료합니다.
  • connect: 크레온 ID, 비밀번호, 공인인증서 비밀번호를 입력받아서 크레온 HTS에 로그인 합니다.
  • connected: 크레온 HTS에 연결되었는지 확인합니다.
  • disconnect: 크레온 HTS와의 연결을 해제합니다.

여기서 connect 함수를 호출하면 기존 크레온을 종료하고 로그인을 시도하게 되어 있습니다.

파이썬 메인 모듈에서 인자(argument) 파싱

파이썬 main을 실행할 때 인자(argument)를 주고싶은 경우 다음과 같이 할 수 있습니다. 인자는 positional argument와 optional argument로 구성할 수 있습니다. (자세한 정보는 https://docs.python.org/3.7/library/argparse.html 참고하세요.)

if __name__ == '__main__':
parser = argparse.ArgumentParser()
parser.add_argument('parg1') # positional argument
parser.add_argument('parg2') # positional argument
parser.add_argument('--oarg1') # optional argument
parser.add_argument('--oarg2') # optional argument
args = parser.parse_args()
print(args)

다음은 실행 커맨드에 따라 달라지는 args를 보여줍니다.

  • python main.py 1 2
    • Namespace(oarg1=None, oarg2=None, parg1='1', parg2='2')
  • python invalidanc.py 1 2 --oarg1=3
    • Namespace(oarg1='3', oarg2=None, parg1='1', parg2='2')
  • python invalidanc.py 1 2 --oarg1=3 --oarg2=4
    • Namespace(oarg1='3', oarg2='4', parg1='1', parg2='2')