콘텐츠로 이동
35 posts with the tag “Python”

기술적 분석 2장: 이동평균 추세와 수익률
이동평균 기반 추세 분석

1장에서는 MACD와 거래량 신호가 RSI·볼린저 반등보다 20일 수익률에서 상대적으로 나은 결과를 보였습니다. 이번 장에서는 그보다 단순한 추세 조건, 즉 종가 > MA20 > MA60을 계속 보유하는 전략으로 바꿔도 결과가 유지되는지 확인합니다. 사건별 수익률과 실제 포트폴리오 성과는 다를 수 있으므로, 다음 거래일 진입·거래비용·최대낙폭까지 함께 계산합니다.

df = df.sort_values(["code", "date"])
df["ma20"] = df.groupby("code")["close"].transform(
lambda x: x.rolling(20).mean()
)
df["ma60"] = df.groupby("code")["close"].transform(
lambda x: x.rolling(60).mean()
)
df["ma_trend"] = (
(df["close"] > df["ma20"]) &
(df["ma20"] > df["ma60"])
)
# 신호가 만들어진 다음 거래일부터 보유
df["position"] = df.groupby("code")["ma_trend"].shift(1).fillna(False)
df["strategy_return"] = df["position"] * df["return_1d"]

신호 당일의 종가 수익률을 사용하지 않고 다음 거래일부터 포지션을 적용했습니다. 이것만으로도 백테스트의 과도한 낙관을 상당히 줄일 수 있습니다.

2026년 1월 1일부터 9월 4일까지의 결과는 다음과 같습니다. 거래비용은 포지션이 바뀔 때 0.15%를 차감했습니다.

전략누적수익률연환산수익률최대낙폭Sharpe 근사
MA 추세+63.55%+111.03%-31.05%2.12
코스피+33.62%+55.69%-38.63%0.91

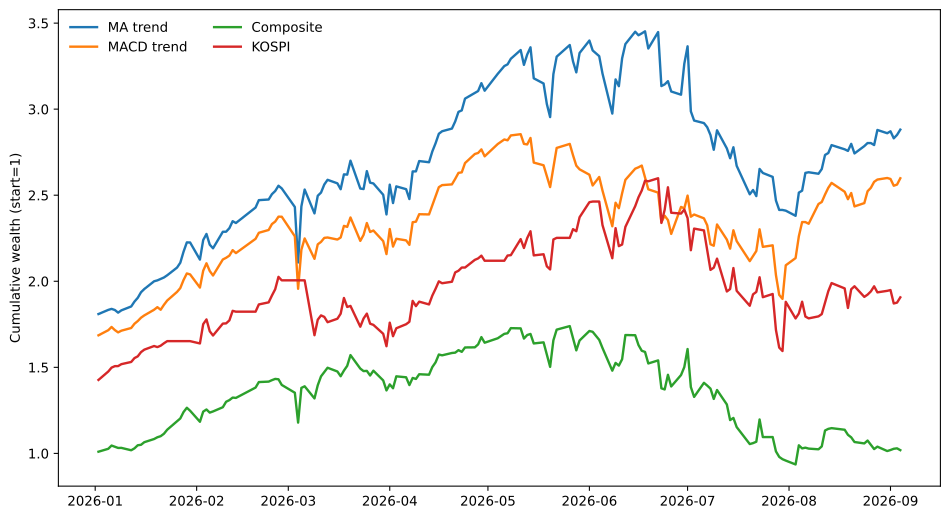
추세 전략과 코스피의 누적자산

이 차트는 검증 구간인 2026년 1월 1일부터 9월 4일까지, 시작 자산을 1로 놓고 매일의 수익률을 누적한 결과입니다. 가로축은 날짜이고 세로축은 누적자산입니다. 예를 들어 선이 1.64에서 끝나면 시작 자산 1이 1.64가 되었다는 뜻이므로 누적수익률은 약 +64%입니다. 하루 수익률이나 특정 종목의 주가가 아니라 포트폴리오 전체의 복리 성과를 그린 선입니다.

차트의 선은 다음과 같이 구성됩니다. 여기서 범례의 Composite는 composition(구성)이라는 별도 지표가 아니라, 여러 조건을 합친 복합 신호를 뜻합니다.

범례의미실제 보유 구성
MA trend종가 > MA20 > MA60인 상승 추세조건을 만족한 종목을 동일 비중으로 보유. 검증 구간 평균 90.7개
MACD trendMACD 골든크로스가 발생한 뒤 20거래일 동안 활성화활성 신호 종목을 동일 비중으로 보유. 평균 187.1개
Composite추세·RSI·MACD·거래량 조건을 모두 만족한 복합 신호종가 > MA20, MA20 > MA60, RSI 40~70, MACD > 시그널, 거래량 비율 > 1인 종목을 동일 비중으로 보유. 평균 15.4개
KOSPI비교 기준인 코스피코스피 일별 수익률을 그대로 누적한 벤치마크

세 전략 모두 기준일의 신호를 다음 거래일부터 적용하고, 포지션이 바뀔 때 거래비용 0.15%를 반영했습니다. 따라서 ‘구성’은 단순히 어떤 지표를 계산했는지가 아니라, 어떤 종목을 언제 포트폴리오에 넣고, 보유 종목 사이에 자금을 어떻게 나눴는지를 의미합니다. 조건을 만족하는 종목이 여러 개면 각 종목의 수익률을 동일 비중으로 평균내며, 조건을 만족하는 종목이 없으면 해당 날짜의 전략 수익률은 0으로 처리합니다.

이제 선의 높이보다 선 사이의 간격과 중간 하락을 봐야 합니다. MA 추세선의 검증 구간 끝값은 약 1.64로 코스피의 약 1.34보다 높지만, 중간에 크게 꺾인 구간도 있습니다. 이 중간 하락이 최대낙폭 -31.05%로 이어졌습니다. 즉 끝점은 “얼마나 벌었는가”, 선이 가장 깊게 내려간 폭은 “그 결과를 얻는 동안 얼마나 잃을 수 있었는가”를 보여줍니다. Composite 선이 거의 1 부근에 머무는 것은 조건이 더 엄격해 보인다는 이유만으로 성과가 좋아지는 것은 아니며, 적은 보유 종목 수와 신호 공백의 영향까지 함께 봐야 한다는 의미입니다.

MA 추세 전략은 검증 구간에서 코스피보다 29.93%포인트 높은 누적수익률을 기록했고, 최대낙폭도 코스피보다 7.58%포인트 작았습니다. 다만 평균 보유 종목 수가 약 90.7개인 분산 포트폴리오였고, 그 상태에서도 최대낙폭은 -31.05%였습니다. “수익률이 높았다”는 문장만으로는 부족하며, 투자자는 이 하락을 실제로 유지할 수 있는지도 판단해야 합니다.

이번 결과에서 얻는 구체적인 인사이트는 이동평균선이 “돌파 순간을 맞히는 신호”라기보다 상승 상태에 있는 종목을 보유하고 하락 상태의 종목을 비우는 필터로 작동했다는 점입니다. 1장의 신호별 평균수익률을 전략으로 옮겼을 때도 성과가 이어졌지만, -31.05%의 낙폭이 남았으므로 추세 필터가 위험을 제거한 것은 아닙니다. 또한 2026년 검증 구간의 시장 방향성과 표본 구성에 영향을 받은 결과이므로 다른 기간에도 같은 우위가 반복되는지는 별도 검증이 필요합니다.

다음 장에서는 RSI 30 이하를 매수 신호로 사용하는 평균회귀 발상이 실제로 통하는지 확인합니다.
결과 원본은 전략 결과 CSV, 누적자산 CSV에서 확인할 수 있습니다.

기술적 분석 1장: 지표 신호의 수익률 구분 능력

차트와 기술적 분석 데이터

기술적 분석에서 먼저 답해야 할 질문은 “이 지표가 유명한가?”가 아니라 “신호가 발생한 뒤의 수익률이 신호가 없을 때와 달라지는가?”입니다. 한 종목의 차트에서 그럴듯해 보이는 패턴만으로는 이 질문에 답할 수 없습니다.

이번 분석은 같은 표본과 같은 규칙으로 이동평균, RSI, MACD, 볼린저 밴드, 거래량, OBV 신호를 만들고, 신호 발생 뒤 5·20·60거래일 수익률을 비교합니다. 이 장에서는 분석에 사용할 데이터와 계산 규칙을 고정한 뒤, 전체 지표 결과를 먼저 훑어봅니다. 이후 각 장에서 지표를 하나씩 정의하고, 이 결과가 어떤 조건에서 유지되거나 무너지는지 확인합니다.

따라서 이 글의 결론은 “데이터를 공개했다”가 아닙니다. 어떤 신호가 이후 수익률과 더 강하게 연결됐고, 어떤 신호는 평균수익률만 좋아 보였는지를 구분하는 것이 이 장의 목적입니다.

분석 기준일은 2026년 9월 4일입니다. 기준일 거래대금이 큰 일반 주식 300개를 표본으로 선정하고, 2024년 1월 1일부터 2026년 9월 4일까지의 일봉을 사용했습니다. ETF, ETN, 인버스, 레버리지, 채권형 상품은 제외했습니다.

항목값
표본 종목 수300개
OHLCV 원자료 행 수185,309개
120일 워밍업 이후 지표 행 수150,419개
가격 데이터 기간2024-01-01 ~ 2026-09-04
학습 구간2024-01-01 ~ 2025-12-31
검증 구간2026-01-01 ~ 2026-09-04

표본은 모든 상장 종목을 대표하지 않습니다. 거래대금 상위 종목을 사용했기 때문에 유동성이 낮은 종목의 체결 문제를 줄이는 대신, 대형주와 관심 종목에 유리한 표본 편향이 생깁니다. 이 한계를 숨기지 않고 원자료와 조건을 함께 공개합니다.

import pandas as pd
df = pd.read_csv(
"ohlcv.csv",
dtype={"code": str},
parse_dates=["date"],
)
df = df.sort_values(["code", "date"])
df["return_1d"] = df.groupby("code")["close"].pct_change()
df["return_20d"] = df.groupby("code")["close"].pct_change(20)
print(df.shape)
print(df[["code", "date", "close", "return_20d"]].tail())

이 코드의 핵심은 종목별로 날짜를 정렬한 뒤 수익률을 계산하는 것입니다. 전체 데이터를 날짜만 기준으로 정렬하면 서로 다른 회사의 가격이 이어지는 오류가 생깁니다. 실제 지표 계산과 신호 정의는 공개한 Python 파일에서 재현할 수 있고, 이 장에서는 그 결과 파일을 같은 기준으로 읽어 비교합니다.

지표 신호와 20일 수익률의 관계

섹션 제목: “지표 신호와 20일 수익률의 관계”

먼저 중간 기간인 20거래일을 기준으로 비교합니다. 검증 구간은 2026년 1월 1일부터 9월 4일까지이며, 신호가 발생한 날의 종가부터 20거래일 뒤 종가까지의 수익률을 계산했습니다. 신호 당일의 수익률을 사용하지 않았기 때문에 신호 이후의 결과만 측정합니다.

import pandas as pd
results = pd.read_csv(
"event_results.csv",
encoding="utf-8-sig",
)
validation_20d = (
results.query(
"sample == '검증' and horizon_days == 20 "
"and signal != '복합 신호 진입'"
)
.assign(
positive_rate=lambda x: x["positive_rate"] * 100,
mean_return=lambda x: x["mean_return"] * 100,
median_return=lambda x: x["median_return"] * 100,
)
.loc[:, [
"signal", "events", "positive_rate",
"mean_return", "median_return",
]]
.sort_values("mean_return", ascending=False)
)
print(validation_20d.round(2).to_string(index=False))

실행 결과는 다음과 같습니다.

신호발생 횟수양수 비율평균 수익률중앙값 수익률
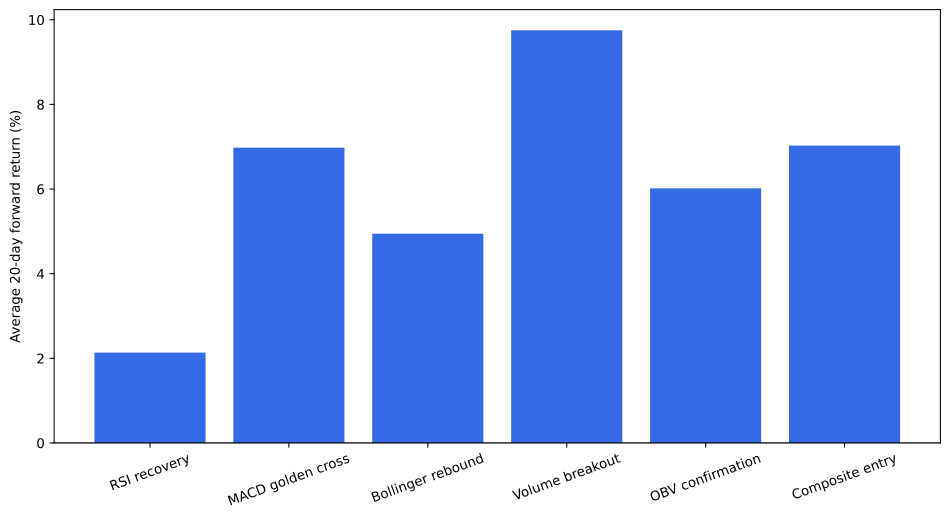
거래량 돌파2,72653.4%+9.75%+2.51%
MACD 골든크로스1,86855.1%+6.98%+2.72%
OBV 확인2,65353.8%+6.02%+2.03%
볼린저 하단 반등1,01549.4%+4.94%-0.27%
RSI 회복1,25847.1%+2.14%-0.91%

기술적 신호의 20일 선행수익률

이 표에서 가장 먼저 보이는 것은 평균수익률만으로 신호의 질을 판단하면 안 된다는 점입니다.

  • 거래량 돌파는 평균 수익률이 +9.75%로 가장 높고 중앙값도 +2.51%였습니다. 일부 대박 사례만으로 평균이 올라간 것이 아니라, 전형적인 신호에서도 수익률이 양수 쪽에 놓였다는 뜻입니다.
  • MACD 골든크로스는 양수 비율이 55.1%로 가장 높고 중앙값도 +2.72%였습니다. 이번 검증 구간에서는 추세 전환 신호 중 결과의 방향성이 가장 안정적이었습니다.
  • OBV 확인도 평균 +6.02%, 중앙값 +2.03%를 기록했습니다. 거래량 돌파와 함께 거래량을 확인하는 신호가 가격 반등만 보는 신호보다 일관된 결과를 보였다는 해석이 가능합니다.
  • RSI 회복과 볼린저 하단 반등은 평균수익률은 플러스였지만 중앙값이 각각 -0.91%, -0.27%였습니다. 소수의 큰 상승 사례가 평균을 끌어올렸을 가능성이 있어, “과매도 후 반등”을 반복적으로 기대하기에는 근거가 약합니다.

다만 이 결과가 신호가 발생하면 무조건 매수해야 한다는 뜻은 아닙니다. 가장 높은 양수 비율도 55.1%에 그쳤고, 모든 신호의 하위 25% 수익률은 마이너스였습니다. 즉 기술적 지표는 방향을 맞히는 단독 예언 도구라기보다, 어떤 상황에서 상대적으로 유리한 후보를 좁히는 필터로 해석하는 편이 적절합니다.

또한 이 표는 신호별 사건을 독립적으로 집계한 결과입니다. 신호가 겹치는 종목을 하나의 포트폴리오로 운용했을 때의 거래비용, 보유 비중, 최대낙폭은 아직 반영하지 않았습니다. 그래서 다음 장부터는 개별 지표의 신호 정의를 확인하고, 마지막 장에서 실제 전략 성과와 리스크를 별도로 비교합니다.

이번 결과는 다음 순서를 정하는 기준이 됩니다.

  • 이동평균과 MACD처럼 추세를 따라가는 신호는 왜 상대적으로 안정적이었는가
  • RSI와 볼린저 밴드의 반등 신호는 어떤 시장 국면에서 실패했는가
  • 거래량 돌파와 OBV 확인은 같은 정보를 반복해서 보는 것인가, 서로 보완하는가
  • 개별 신호의 관계가 실제 종목 스크리닝과 포트폴리오 백테스트에서도 유지되는가

다음 장에서는 이동평균선 신호를 전략으로 바꿔, 단순히 수익률이 높았다는 사실을 넘어 보유 시점과 최대낙폭까지 확인합니다.

원본은 OHLCV CSV, 종목 유니버스, 전체 데이터 설명에서 확인할 수 있습니다. 전체 재현 코드는 technical_analysis.py로 제공합니다.

기술적 분석 3장: RSI 과매도 신호의 수익률

RSI 평균회귀 분석

1장에서는 RSI 회복 신호의 20일 평균수익률이 +2.14%였지만 중앙값은 -0.91%, 양수 비율은 47.1%였습니다. 이번 장에서는 왜 “RSI 30 이하 = 매수 기회”라는 설명이 반복해서 실패할 수 있는지, 과매도 수준이 아니라 회복 신호를 기준으로 다시 확인합니다. 강한 하락 추세에서는 RSI가 30 아래에 오래 머물 수 있으므로, 30 아래에서 다시 30을 상향 돌파한 날을 신호로 정의했습니다.

change = df.groupby("code")["close"].diff()
gain = change.clip(lower=0)
loss = -change.clip(upper=0)
avg_gain = gain.groupby(df["code"]).transform(lambda x: x.rolling(14).mean())
avg_loss = loss.groupby(df["code"]).transform(lambda x: x.rolling(14).mean())
df["rsi14"] = avg_gain / (avg_gain + avg_loss) * 100
df["rsi_recovery"] = (
(df.groupby("code")["rsi14"].shift(1) <= 30) &
(df["rsi14"] > 30)
)
df["forward_return_20d"] = (
df.groupby("code")["close"].shift(-20) / df["close"] - 1
)

검증 구간에서 RSI 회복 신호는 1,258회 발생했습니다.

신호발생 횟수20일 양수 비율평균 수익률중앙값
RSI 30 상향 회복1,258회47.1%+2.14%-0.91%

평균 수익률은 양수였지만 중앙값은 -0.91%였고, 양수 비율도 47.1%로 절반에 미치지 못했습니다. 25% 분위수는 -14.56%였습니다. 일부 큰 반등이 평균을 끌어올렸을 뿐, 전형적인 신호가 손실을 피했다고 보기는 어렵습니다. 같은 검증 구간에서 MACD 골든크로스는 양수 비율 55.1%, 중앙값 +2.72%였기 때문에 RSI 회복의 약점이 더 분명해집니다.

이번 결과에서 RSI는 단독 매수 신호라기보다 하락 압력이 완화됐는지 확인하는 보조 지표로 쓰는 편이 낫습니다. RSI 회복만으로는 부족하므로 다음 조건을 추가했을 때 결과가 개선되는지 별도 검증해야 합니다.

  • 종가가 MA20 위에 있는가
  • 20일 수익률이 양수인가
  • 거래량이 평소보다 증가했는가
  • 산업 전체가 같은 방향으로 움직이는가

RSI 30이라는 숫자만 보고 매수하면 하락 추세 중간의 일시적 반등을 잡을 가능성이 큽니다. 따라서 평균수익률이 플러스라는 이유만으로 평균회귀 전략을 채택하기보다, 손절 기준·보유 기간·시장 국면을 함께 정해야 합니다. 다음 장에서는 같은 검증 구간에서 더 높은 양수 비율과 중앙값을 보인 MACD 골든크로스가 실제 추세 전략으로도 이어지는지 확인합니다.

전체 결과는 신호별 결과 CSV, 계산 코드는 technical_analysis.py에서 확인할 수 있습니다.

기술적 분석 4장: MACD 골든크로스의 신호 강도

MACD 골든크로스 분석

2장에서는 MA20과 MA60의 추세 상태를 보유 전략으로 바꿨을 때 누적수익률 +63.55%를 기록했습니다. 1장의 개별 신호 비교에서도 MACD 골든크로스는 RSI 회복보다 양수 비율과 중앙값이 높았습니다. 이번 장에서는 이 관계가 단순한 사건별 통계에 그치지 않고, MACD 상태를 계속 보유하는 전략에서도 이어지는지 확인합니다.

MACD 골든크로스는 MACD 선이 Signal 선을 아래에서 위로 통과하는 현상입니다. 상승 전환을 보여주는 것처럼 보이지만, 이동평균에서 파생된 지표이므로 신호가 발생할 때 이미 주가가 상당히 움직였을 수 있습니다.

g = df.sort_values(["code", "date"]).copy()
g["ema12"] = g.groupby("code")["close"].transform(
lambda x: x.ewm(span=12).mean()
)
g["ema26"] = g.groupby("code")["close"].transform(
lambda x: x.ewm(span=26).mean()
)
g["macd"] = g["ema12"] - g["ema26"]
g["macd_signal"] = g.groupby("code")["macd"].transform(
lambda x: x.ewm(span=9).mean()
)
g["macd_golden_cross"] = (
(g.groupby("code")["macd"].shift(1) <= g.groupby("code")["macd_signal"].shift(1))
& (g["macd"] > g["macd_signal"])
)

검증 구간에서 MACD 골든크로스는 1,868회 발생했습니다.

신호발생 횟수20일 양수 비율평균 수익률중앙값
MACD 골든크로스1,868회55.1%+6.98%+2.72%

RSI 회복보다 양수 비율과 중앙값이 모두 높았습니다. 평균수익률뿐 아니라 양수 비율과 중앙값도 함께 개선됐기 때문에, 최소한 이번 표본과 기간에서는 MACD 골든크로스가 단순 과매도 회복보다 안정적인 결과를 보였습니다.

MACD 상태를 20일 동안 보유하는 추세 전략으로 바꾸면 검증 구간 누적수익률은 +58.15%, 최대낙폭은 -33.52%였습니다. 코스피의 누적수익률 +33.62%보다 높았지만, 손실 구간은 여전히 컸습니다.

MACD 골든크로스의 사건별 결과는 평균 +6.98%, 중앙값 +2.72%, 양수 비율 55.1%였습니다. 이 신호를 상태 기반 전략으로 바꾸자 누적수익률 +58.15%와 Sharpe 근사 2.00이 나왔습니다. 즉 신호가 발생한 순간의 통계적 우위가 포트폴리오 수준에서도 어느 정도 이어졌지만, 최대낙폭 -33.52%가 남아 “수익률이 높으면 위험도 낮다”는 결론으로 확장할 수는 없습니다.

MACD는 “오늘 사면 내일 오른다”는 단기 예측 도구가 아니라 방향이 바뀌었는지 확인하는 추세 신호에 가깝습니다. 따라서 다음 조건을 함께 기록해야 합니다.

  • 신호 이전 20일 수익률
  • 신호일의 거래량 비율
  • MA20과 MA60의 방향
  • 신호 후 최대 하락폭

평균 수익률이 높아도 특정 몇 개 종목의 급등 때문일 수 있습니다. 그래서 평균과 중앙값, 양수 비율을 동시에 공개했습니다.

다음 장에서는 평균회귀 성격이 강한 볼린저 밴드 하단 반등이 RSI와 같은 약점을 보이는지 비교합니다.

결과 원본은 신호별 결과 CSV, 전략 결과 CSV에서 확인할 수 있습니다.

기술적 분석 5장: 볼린저 밴드 하단 돌파의 효과

볼린저 밴드 분석

3장의 RSI 회복과 이번 볼린저 하단 반등은 모두 “많이 하락했으니 되돌아오지 않을까?”라는 평균회귀 가설에서 출발합니다. RSI 회복은 20일 중앙값 -0.91%였고, 이번 장에서는 가격이 밴드 안으로 돌아온 사건도 같은 약점을 보이는지 확인합니다.

볼린저 밴드 하단에 닿으면 주가가 싸졌다고 생각하기 쉽습니다. 그러나 하단 밴드를 따라 내려가는 강한 하락 추세에서는 하단 접촉만으로 반등을 예측할 수 없습니다. 이번 글에서는 전일 종가가 하단 밴드 아래였고 당일 종가가 다시 밴드 안으로 들어온 경우를 반등 신호로 정의했습니다.

g = df.sort_values(["code", "date"]).copy()
g["bb_middle"] = g.groupby("code")["close"].transform(
lambda x: x.rolling(20).mean()
)
std20 = g.groupby("code")["close"].transform(lambda x: x.rolling(20).std())
g["bb_upper"] = g["bb_middle"] + 2 * std20
g["bb_lower"] = g["bb_middle"] - 2 * std20
previous_close = g.groupby("code")["close"].shift(1)
previous_lower = g.groupby("code")["bb_lower"].shift(1)
g["bb_rebound"] = (previous_close <= previous_lower) & (
g["close"] > g["bb_lower"]
)

검증 구간에서 볼린저 하단 반등은 1,015회 발생했습니다.

신호발생 횟수20일 양수 비율평균 수익률중앙값
볼린저 하단 반등1,015회49.4%+4.94%-0.27%

평균은 +4.94%였지만 중앙값은 -0.27%, 양수 비율은 49.4%였습니다. 25% 분위수도 -13.11%였습니다. 일부 큰 반등 사례가 평균을 높였지만, 절반 이상의 전형적인 사례가 안정적인 수익으로 이어졌다고 보기는 어렵습니다. RSI 회복의 평균 +2.14%보다 높아 보이지만, 중앙값과 양수 비율은 모두 약해 평균 차이만으로 우위를 주장할 수 없습니다.

이번 결과에서 볼린저 밴드는 가격의 절대적인 고평가·저평가를 알려주는 지표가 아니라, 최근 20일 가격 분포에서 현재 위치가 어디인지 보여주는 변동성 도구로 해석해야 합니다. 밴드 안으로 복귀했다는 사건만으로는 추세가 끝났다는 증거가 부족합니다.

따라서 하단 반등 신호를 사용할 때는 다음을 추가해야 합니다.

  • 밴드 폭이 줄어들고 있는가
  • 거래량이 동반되었는가
  • 종가가 MA20을 회복했는가
  • 시장과 산업 지수가 상승 중인가

하단 밴드에 닿았다는 이유만으로 매수하면 “싼 가격”이 아니라 “하락 중인 가격”을 매수하게 될 수 있습니다. 위 조건들은 개선 가능성을 제시할 뿐, 이 장에서 추가 검증한 결과는 아닙니다. 다음 장에서는 평균회귀 신호의 손실 폭을 변동성에 맞춰 관리하는 ATR을 확인합니다.

결과는 신호별 결과 CSV에 공개했습니다.

기술적 분석 9장: 복합 기술지표의 포트폴리오 효과

기술적 지표 복합 신호

8장까지의 결과를 보면 거래량 돌파의 20일 평균수익률은 +9.75%, MACD 골든크로스는 +6.98%였습니다. 그렇다면 이동평균, RSI, MACD, 거래량을 동시에 만족시키면 더 강한 신호가 될까요? 여러 지표를 합치는 방식은 직관적이지만, 서로 비슷한 가격 정보를 반복해서 사용하거나 신호가 너무 늦어지는 문제가 생길 수 있습니다.

이번 분석에서는 다섯 조건 중 네 개 이상을 만족하면 복합 신호로 분류했습니다.

conditions = pd.concat(
[
df["close"] > df["ma20"],
df["ma20"] > df["ma60"],
df["rsi14"].between(40, 70),
df["macd"] > df["macd_signal"],
df["volume_ratio20"] > 1,
],
axis=1,
)
df["technical_score"] = conditions.sum(axis=1)
df["composite_state"] = df["technical_score"] >= 4
previous_state = df.groupby("code")["composite_state"].shift(1).fillna(False)
df["composite_entry"] = (
df["composite_state"] &
~previous_state
)

검증 구간에서 복합 신호 진입은 1,601회 발생했습니다.

신호발생 횟수20일 양수 비율평균 수익률중앙값
복합 신호 진입1,601회53.3%+7.03%+2.10%
거래량 돌파2,726회53.4%+9.75%+2.51%
MACD 골든크로스1,868회55.1%+6.98%+2.72%

복합 신호의 평균수익률 +7.03%는 거래량 돌파의 +9.75%보다 낮고, 중앙값 +2.10%도 거래량 돌파 +2.51%와 MACD +2.72%보다 낮았습니다. 양수 비율도 53.3%로 MACD의 55.1%를 넘지 못했습니다. 여러 조건을 요구했기 때문에 신호의 질이 자동으로 높아진 것이 아니라, 진입 시점이 늦어지고 상승 초기를 놓쳤을 가능성이 있습니다.

복합 신호의 장점은 신호의 설명력입니다. “왜 이 종목이 후보인가?”에 대해 추세, 모멘텀, 거래량으로 나눠 설명할 수 있습니다. 반면 조건을 추가할수록 표본 수가 줄고, 과거 기간에 맞춘 과최적화 위험이 커집니다.

따라서 복합 전략은 점수 자체보다 다음을 관리해야 합니다.

  • 조건을 추가하기 전후의 표본 수
  • 학습 구간과 검증 구간의 성과 차이
  • 평균과 중앙값의 차이
  • 산업별 편중
  • 신호 발생 후 최대 손실

이번 결과에서 복합 신호의 장점은 단일 지표보다 높은 수익률이 아니라, “추세·모멘텀·거래량 조건을 동시에 만족한 종목”이라는 설명력입니다. 반대로 성과 측면에서는 단일 거래량·MACD 신호를 압도하지 못했습니다. 복합 신호는 최종 매수 버튼이 아니라 다음 분석으로 넘어갈 종목을 줄이는 스크리닝 언어로 사용하는 것이 적절합니다.

다음 장에서는 이 스크리닝 결과가 산업과 시장 국면에 따라 얼마나 달라지는지 확인합니다.

기술적 분석 11장: 오늘의 후보 종목 스크리닝

기술적 분석 종목 스크리닝

앞 장에서는 복합 신호가 산업과 시장 국면에 따라 다른 결과를 보인다는 점을 확인했습니다. 이번에는 그 신호를 2026년 9월 4일 기준 종목 전체에 적용해 실제 후보군을 추출합니다. 여기서 중요한 질문은 “점수가 높은 종목이 곧 매수 종목인가?”가 아니라 “어떤 조건을 통과한 후보를 다음 분석 대상으로 좁힐 수 있는가?”입니다. 이 결과는 매수 추천 목록이 아니라, 동일한 규칙으로 다시 확인할 수 있는 분석 후보 목록입니다.

다섯 조건 중 네 개 이상을 만족하는 종목을 후보로 분류했습니다.

df["score"] = (
(df["close"] > df["ma20"]).astype(int)
+ (df["ma20"] > df["ma60"]).astype(int)
+ df["rsi14"].between(40, 70).astype(int)
+ (df["macd"] > df["macd_signal"]).astype(int)
+ (df["volume_ratio20"] > 1).astype(int)
)
latest = df[df["date"] == "20260904"]
screen = latest[latest["score"] >= 4].sort_values(
["score", "volume_ratio20"], ascending=False
)
종목시장종가RSI거래량 비율점수
카카오페이KOSPI47,30055.41.335
현대약품KOSPI7,95069.02.885
KCCKOSPI482,00054.71.295
디아이KOSPI31,25067.81.835
한화투자증권KOSPI5,10057.23.285
써니전자KOSPI2,18565.01.665
파인엠텍KOSDAQ9,35055.12.175
신스틸KOSDAQ2,10569.13.205

전체 30개 후보는 latest_screen.csv에서 확인할 수 있습니다. 기준일이 바뀌면 후보도 바뀌므로, 이 목록의 종목명을 고정해 추천처럼 사용해서는 안 됩니다.

이번 기준일 후보는 총 30개였고, 모두 5개 조건을 통과했습니다. 시장별로는 KOSPI 15개, KOSDAQ 15개였습니다. 따라서 이 결과에서 점수 5점과 4점의 우열을 비교할 수는 없고, 거래량 비율이나 산업·시장 구성을 추가 기준으로 사용해야 합니다.

스크리닝의 역할은 분석 대상을 줄이는 것입니다. 점수 5점이라고 해서 바로 매수할 수 있는 것은 아닙니다. 후보가 어떤 산업에 몰렸는지, 실적·현금흐름·수급·밸류에이션이 뒷받침되는지, 그리고 기준일 이후에도 조건이 유지되는지를 확인해야 합니다.

다음 장에서는 후보를 고르는 규칙을 실제 포트폴리오 전략으로 바꿀 때 성과와 낙폭이 어떻게 달라지는지 비교합니다.

LangGraph와 LangSmith 연결하기: AI 에이전트 실행 추적과 디버깅

LangGraph 상태 그래프와 LangSmith 실행 추적을 표현한 이미지

LangGraph로 AI 에이전트를 만들면 단순한 함수 호출보다 복잡한 흐름을 구성할 수 있습니다. 상태(state)를 여러 노드가 읽고 수정하고, 조건에 따라 다른 노드로 이동하거나 사람의 검토를 기다릴 수도 있습니다. 문제는 실행 결과만 봐서는 어느 노드에서 잘못된 판단이 시작됐는지 찾기 어렵다는 점입니다.

이때 LangSmith를 연결하면 에이전트 실행을 단계별 trace로 확인할 수 있습니다. 각 노드의 입력과 출력, 실행 시간, 오류를 한 화면에서 비교할 수 있어 프롬프트와 워크플로를 개선하기가 쉬워집니다.

두 도구는 서로 대체 관계가 아닙니다.

도구담당 영역
LangGraph상태, 노드, 엣지, 조건 분기, 재개 가능한 실행 흐름
LangSmith실행 trace, 프롬프트·응답 확인, 평가, 모니터링

LangGraph가 에이전트의 실행 구조라면 LangSmith는 그 실행을 관찰하는 기록 장치입니다. 특히 여러 번의 LLM 호출이나 도구 호출이 이어지는 에이전트에서는 최종 답변보다 중간 단계의 기록이 더 중요합니다.

Python 환경에서 다음 패키지를 설치합니다.

Terminal window
pip install -U langgraph langsmith

LangSmith 프로젝트에서 발급한 API 키는 소스 코드에 직접 넣지 않고 환경 변수로 관리합니다.

Terminal window
export LANGSMITH_TRACING=true
export LANGSMITH_API_KEY="lsv2_..."
export LANGSMITH_PROJECT="quantylab-agent-dev"

LANGSMITH_PROJECT를 지정하면 실행 결과를 애플리케이션별 프로젝트로 분리할 수 있습니다. 개발·스테이징·운영 환경마다 프로젝트 이름을 나누면 실험 trace와 실제 사용자 요청을 섞지 않을 수 있습니다.

다음 그래프는 입력된 질문을 받아 답변을 만드는 간단한 예제입니다.

from typing import TypedDict
from langgraph.graph import END, START, StateGraph
class State(TypedDict):
question: str
answer: str
def answer_question(state: State) -> dict:
# 실제 애플리케이션에서는 이곳에서 LLM을 호출합니다.
return {"answer": f"질문을 처리했습니다: {state['question']}"}
builder = StateGraph(State)
builder.add_node("answer_question", answer_question)
builder.add_edge(START, "answer_question")
builder.add_edge("answer_question", END)
graph = builder.compile()
result = graph.invoke({"question": "LangGraph란 무엇인가?", "answer": ""})
print(result["answer"])

LangSmith 추적을 활성화한 상태에서 graph.invoke()를 실행하면 그래프 실행이 프로젝트에 기록됩니다. LangGraph와 LangChain 통합을 사용하는 경우에는 노드 안의 모델 호출도 부모 실행의 하위 trace로 나타납니다.

LangGraph 노드가 직접 호출하는 데이터 조회, 문서 검색, 후처리 함수는 @traceable로 감싸면 별도의 실행 단위로 기록할 수 있습니다.

from langsmith import traceable
@traceable(name="load-market-context", run_type="tool")
def load_market_context(symbol: str) -> dict:
# 데이터베이스나 외부 API 조회
return {"symbol": symbol, "context": "시장 데이터"}
def research_node(state: dict) -> dict:
context = load_market_context(state["symbol"])
return {"context": context}

이렇게 하면 research_node 안에서 실행된 데이터 조회를 따로 확인할 수 있습니다. 응답이 이상할 때 모델 프롬프트만 의심하지 않고, 검색 결과와 데이터 변환 결과까지 역추적할 수 있습니다.

첫째, API 키와 비밀번호를 graph state에 넣지 않습니다. state는 체크포인터나 디버깅 출력에 저장될 수 있으므로 인증 정보 대신 식별자와 상태만 전달해야 합니다.

둘째, 개인정보와 원문 데이터의 전송 범위를 확인합니다. LangSmith에 기록되는 입력·출력에는 사용자 질문과 검색 문서가 포함될 수 있으므로 필요한 경우 민감한 필드를 마스킹하거나 선택적 tracing을 사용합니다.

셋째, 프로젝트와 태그를 일관되게 사용합니다. 예를 들어 quantylab-agent-dev, quantylab-agent-prod를 분리하고 모델 버전, 데이터 기준일, 실험 이름을 metadata나 tag로 남기면 실행 결과 비교가 쉬워집니다.

LangGraph는 복잡한 AI 에이전트의 실행 흐름을 명시적으로 만들고, LangSmith는 그 흐름을 관찰하고 개선하게 해줍니다. 먼저 LANGSMITH_TRACING과 프로젝트를 설정한 뒤 그래프 전체를 확인하고, 원인 분석이 필요한 함수에 @traceable을 추가하는 순서가 가장 실용적입니다.

공식 문서도 함께 참고하면 좋습니다.

주식 종목 분석에서 신용 거래 데이터 활용

주식 신용 거래 데이터 분석 대표 이미지

주식 시장에서 신용 거래 데이터는 개인 투자자들의 심리와 레버리지 수준을 파악할 수 있는 핵심 보조 지표입니다. 이번 포스트에서는 신용 거래 데이터의 각 항목이 무엇을 의미하는지, 그리고 이를 종목 분석에 어떻게 활용할 수 있는지 다루겠습니다.

신용 거래는 증권사로부터 자금이나 주식을 빌려서 매매하는 방식으로, 크게 두 가지로 나뉩니다.

구분설명
융자증권사에서 돈을 빌려 주식을 매수 (레버리지 매수)
대주증권사에서 주식을 빌려 매도 (공매도의 일종)

융자 잔고가 늘어난다는 것은 개인 투자자들이 빚을 내서까지 해당 종목을 사고 있다는 뜻이고, 대주 잔고가 늘어난다는 것은 해당 종목의 하락에 베팅하는 수요가 있다는 뜻입니다.

신용 거래 데이터는 일반적으로 증권사 API나 HTS에서 다음과 같은 항목들로 제공됩니다. 아래는 키움증권 API를 통해 수집할 수 있는 항목들입니다.

항목설명
종목코드대상 종목
일자거래 기준일
조회구분융자(1) 또는 대주(2)
현재가해당일 종가
거래량해당일 거래량
신규해당일 새로 발생한 신용 거래 수량
상환해당일 상환(청산)된 신용 거래 수량
잔고현재 미상환 신용 거래 누적 수량
금액잔고의 금액 환산 (잔고 × 현재가)
대비전일 대비 잔고 변화량
공여율증권사가 공여한 비율
잔고율상장주식수 대비 신용 잔고 비율 (%)

데이터를 DB에 저장한다면 다음과 같은 테이블 구조로 설계할 수 있습니다.

stock_credit 테이블
─────────────────────────────────────────────
code (PK) 종목코드 예: '005930'
date (PK) 일자 예: '20260220'
qry_tp (PK) 조회구분 1:융자, 2:대주
close 현재가
volume 거래량
new 신규
repayment 상환
balance 잔고
amount 금액
balance_diff 대비
supply_ratio 공여율
balance_ratio 잔고율
─────────────────────────────────────────────

분석 예시를 위해 가상의 종목 A에 대한 20일간 융자 데이터를 만들어 보겠습니다.

import pandas as pd
# 종목 A의 융자(신용매수) 데이터 예시
df = pd.DataFrame({
"date": [
"20260203", "20260204", "20260205", "20260206", "20260207",
"20260210", "20260211", "20260212", "20260213", "20260214",
"20260217", "20260218", "20260219", "20260220", "20260221",
"20260224", "20260225", "20260226", "20260227", "20260228",
],
"close": [
50000, 50500, 51200, 52000, 53500,
54000, 55000, 54200, 53000, 51500,
50800, 50000, 49500, 48000, 47000,
47500, 48200, 49000, 50500, 51000,
],
"volume": [
1200000, 1350000, 1500000, 1800000, 2200000,
1900000, 2500000, 2100000, 2800000, 3200000,
2600000, 2400000, 2000000, 3500000, 3000000,
1800000, 1600000, 1400000, 1300000, 1200000,
],
"new": [
150, 200, 280, 350, 500,
420, 600, 380, 300, 250,
200, 180, 150, 120, 100,
130, 160, 140, 120, 110,
],
"repayment": [
100, 120, 130, 150, 180,
200, 220, 350, 400, 380,
350, 300, 280, 350, 320,
200, 180, 170, 150, 140,
],
"balance": [
3050, 3130, 3280, 3480, 3800,
4020, 4400, 4430, 4330, 4200,
4050, 3930, 3800, 3570, 3350,
3280, 3260, 3230, 3200, 3170,
],
"amount": [
15250, 15807, 16794, 18096, 20330,
21708, 24200, 24011, 22949, 21630,
20574, 19650, 18810, 17136, 15745,
15580, 15713, 15827, 16160, 16167,
],
"balance_ratio": [
1.02, 1.04, 1.09, 1.16, 1.27,
1.34, 1.47, 1.48, 1.44, 1.40,
1.35, 1.31, 1.27, 1.19, 1.12,
1.09, 1.09, 1.08, 1.07, 1.06,
],
})

위 데이터는 “상승 → 과열 → 하락 → 안정” 의 전형적인 사이클을 보여줍니다.

1. 잔고율(balance_ratio)로 과열 여부 판단

섹션 제목: “1. 잔고율(balance_ratio)로 과열 여부 판단”

잔고율은 상장주식수 대비 신용 잔고의 비율입니다. 이 값이 높을수록 레버리지 매수가 과도하게 쌓여 있다는 뜻입니다.

import matplotlib.pyplot as plt
fig, ax1 = plt.subplots(figsize=(12, 5))
ax2 = ax1.twinx()
ax1.plot(df["date"], df["close"], label="주가", color="black", marker="o", markersize=3)
ax2.bar(df["date"], df["balance_ratio"], alpha=0.3, label="잔고율(%)", color="red")
ax2.axhline(y=1.3, color="red", linestyle="--", alpha=0.5, label="주의 기준선")
ax1.set_ylabel("주가")
ax2.set_ylabel("잔고율(%)")
ax1.set_xticklabels(df["date"], rotation=45, ha="right")
plt.title("주가 vs 융자 잔고율")
fig.tight_layout()
plt.show()

예시 데이터를 보면 잔고율이 1.47%까지 올라간 2월 11일을 정점으로, 이후 주가가 하락하면서 잔고율도 함께 줄어드는 전형적인 패턴을 확인할 수 있습니다.

해석 기준 (종목/업종별로 기준이 다를 수 있음):

  • 잔고율 평소 대비 급등: 신용 매수 과열 → 주의 필요
  • 잔고율 고점 유지 + 주가 하락: 반대매매 리스크 존재
  • 잔고율 급등 후 주가 하락: 반대매매 연쇄로 추가 하락 가능성

2. 신규(new) vs 상환(repayment) 추이로 수급 방향 파악

섹션 제목: “2. 신규(new) vs 상환(repayment) 추이로 수급 방향 파악”

신규가 상환보다 많으면 신용 매수세가 유입되고 있다는 뜻이고, 반대면 청산이 진행 중입니다.

# 신규 - 상환 = 순신규
df["net_new"] = df["new"] - df["repayment"]
# 5일 이동평균
df["net_new_ma5"] = df["net_new"].rolling(5).mean()
fig, ax1 = plt.subplots(figsize=(12, 5))
ax2 = ax1.twinx()
ax1.plot(df["date"], df["close"], label="주가", color="black", marker="o", markersize=3)
colors = ["blue" if v >= 0 else "red" for v in df["net_new"]]
ax2.bar(df["date"], df["net_new"], alpha=0.3, color=colors)
ax2.plot(df["date"], df["net_new_ma5"], label="순신규 MA5", color="orange")
ax2.axhline(y=0, color="gray", linestyle="--")
ax1.set_ylabel("주가")
ax2.set_ylabel("순신규 (신규 - 상환)")
ax1.set_xticklabels(df["date"], rotation=45, ha="right")
plt.title("순신규 융자 추이")
fig.tight_layout()
plt.show()

예시에서 2월 첫째 주에는 순신규가 양수(파란색)로 신용 매수가 활발했지만, 2월 12일부터 순신규가 음수(빨간색)로 전환되면서 청산이 시작되었습니다. 이 시점이 주가 하락과 일치합니다.

해석:

  • 순신규 양수 지속: 개인의 레버리지 매수 증가 → 단기 상승 기대감, 하지만 과열 주의
  • 순신규 음수 전환: 신용 청산 시작 → 매도 압력 증가 가능

3. 잔고 변화와 주가 방향의 다이버전스

섹션 제목: “3. 잔고 변화와 주가 방향의 다이버전스”

주가는 상승하는데 신용 잔고가 급증하는 경우, 또는 주가가 하락하는데 신용 잔고가 줄지 않는 경우는 위험 신호입니다.

# 주가 변화율 vs 잔고 변화율 비교
df["price_change"] = df["close"].pct_change()
df["balance_change"] = df["balance"].pct_change()
# 주가 하락 + 잔고 증가 = 위험 신호
df["danger_signal"] = (df["price_change"] < -0.01) & (df["balance_change"] > 0)
print(df[["date", "close", "price_change", "balance", "balance_change", "danger_signal"]])

예시 데이터에서 2월 12일을 보면, 주가가 54,000→54,200→53,000으로 하락하는데 잔고는 4,020→4,430→4,330으로 여전히 높은 수준을 유지합니다. 이런 구간이 반대매매 리스크가 높은 구간입니다.

시나리오주가신용 잔고해석
건전한 상승↑→ 또는 ↓자기자본 매수 → 안정적
과열 상승↑↑↑레버리지 의존 → 조정 시 급락 위험
위험 하락↓→ 또는 ↑물타기 or 미청산 → 반대매매 리스크
건전한 조정↓↓손절 진행 → 바닥 형성 가능

4. 융자와 대주 데이터 결합 분석

섹션 제목: “4. 융자와 대주 데이터 결합 분석”

융자(조회구분=1)와 대주(조회구분=2)를 함께 보면 시장 참여자들의 방향성에 대한 더 입체적인 분석이 가능합니다.

# 융자 잔고 (위의 df에서 가져옴)
df_loan = df[["date", "balance", "balance_ratio"]].rename(
columns={"balance": "loan_balance", "balance_ratio": "loan_ratio"}
)
# 같은 종목의 대주 잔고 예시
df_borrow = pd.DataFrame({
"date": df["date"],
"borrow_balance": [
200, 210, 220, 250, 280,
300, 350, 400, 450, 500,
520, 530, 510, 480, 450,
420, 390, 370, 350, 330,
],
"borrow_ratio": [
0.07, 0.07, 0.07, 0.08, 0.09,
0.10, 0.12, 0.13, 0.15, 0.17,
0.17, 0.18, 0.17, 0.16, 0.15,
0.14, 0.13, 0.12, 0.12, 0.11,
],
})
df_combined = df_loan.merge(df_borrow, on="date")
df_combined["loan_borrow_ratio"] = df_combined["loan_balance"] / df_combined["borrow_balance"]
fig, ax1 = plt.subplots(figsize=(12, 5))
ax1.plot(df_combined["date"], df_combined["loan_borrow_ratio"], marker="o", markersize=3)
ax1.set_ylabel("융자/대주 비율")
ax1.set_xticklabels(df_combined["date"], rotation=45, ha="right")
plt.title("융자/대주 잔고 비율 추이")
fig.tight_layout()
plt.show()

해석:

  • 융자/대주 비율 상승: 매수 레버리지가 매도보다 우세 → 강세 심리
  • 융자/대주 비율 하락: 매도(대주) 비중 증가 → 약세 심리 또는 헷지 수요

5. 신용 금액(amount)으로 레버리지 규모 파악

섹션 제목: “5. 신용 금액(amount)으로 레버리지 규모 파악”

잔고율과 함께 금액 항목을 보면 실제 레버리지의 절대 규모를 파악할 수 있습니다.

fig, ax1 = plt.subplots(figsize=(12, 5))
ax2 = ax1.twinx()
ax1.plot(df["date"], df["close"], label="주가", color="black", marker="o", markersize=3)
ax2.fill_between(range(len(df)), df["amount"], alpha=0.2, color="green", label="신용 금액")
ax2.plot(df["date"], df["amount"], color="green", alpha=0.7)
ax1.set_ylabel("주가")
ax2.set_ylabel("신용 금액 (백만원)")
ax1.set_xticklabels(df["date"], rotation=45, ha="right")
plt.title("주가 vs 신용 잔고 금액")
fig.tight_layout()
plt.show()

예시에서 신용 금액은 2월 11일 24,200백만원으로 최고치를 기록한 뒤, 주가 하락과 함께 15,745백만원까지 줄어들었습니다. 금액 감소가 잔고 감소보다 빠른 것은 주가 하락 효과가 더해졌기 때문입니다.

  1. 매수 전 체크리스트에 포함: 관심 종목의 잔고율이 급등하고 있다면 진입 시점을 늦추는 것이 안전합니다.

  2. 반대매매 임계점 인식: 잔고율이 높은 상태에서 주가가 5% 이상 하락하면 반대매매가 연쇄적으로 발생할 수 있습니다.

  3. 바닥 확인 신호: 신용 잔고가 충분히 줄어든 후(상환 > 신규 지속) 주가가 반등하면 건전한 바닥 형성의 신호일 수 있습니다.

  4. 섹터 단위 분석: 특정 섹터 전체의 신용 잔고율이 높아지면 해당 섹터의 과열을 의미할 수 있습니다.

  5. 시계열 피처로 활용: 머신러닝 모델의 입력 피처로 잔고율, 순신규 추이, 잔고 변화율 등을 추가하면 예측 성능 향상에 도움이 됩니다.

지표활용주의 사항
잔고율과열 판단, 반대매매 리스크업종별 평균 수준 고려 필요
신규/상환수급 방향 파악단일일 데이터보다 추세 중요
잔고 대비일별 변화 모니터링주가 방향과 함께 분석
금액레버리지 절대 규모시가총액 대비로 비교
공여율증권사 리스크 관리 수준증권사별 차이 존재

신용 거래 데이터는 단독으로 사용하기보다는 주가, 거래량, 투자자별 매매동향 등 다른 지표와 결합하여 분석할 때 훨씬 큰 인사이트를 얻을 수 있습니다. 특히 개인 투자자 중심의 한국 주식 시장에서는 융자 잔고율이 시장 과열과 조정의 선행 지표로 유용하게 활용됩니다.

업비트에서 실시간 가격 및 호가 데이터 받아오기 (코드 포함)

업비트 WebSocket 실시간 데이터 대표 이미지

암호화폐 트레이딩 봇이나 데이터 분석 시스템을 개발할 때 가장 중요한 것 중 하나는 실시간 시장 데이터를 빠르고 안정적으로 수집하는 것입니다. 이번 포스트에서는 업비트(Upbit) 거래소의 WebSocket API를 활용하여 실시간으로 가격과 호가 데이터를 받아오는 방법을 다룹니다.

업비트는 REST API와 WebSocket API 두 가지 방식을 제공합니다. 실시간 데이터 수집에는 WebSocket이 훨씬 효율적입니다.

REST API의 단점:

  • 주기적으로 요청(polling)해야 하므로 네트워크 오버헤드가 큽니다
  • API 호출 제한(rate limit)에 걸리기 쉽습니다
  • 실시간성이 떨어집니다

WebSocket의 장점:

  • 한 번 연결하면 서버가 데이터를 실시간으로 푸시합니다
  • 네트워크 효율성이 높고 지연시간이 적습니다
  • 여러 종목을 동시에 구독 가능합니다
Terminal window
pip install websocket-client keyring keyrings.alt
  • websocket-client: WebSocket 클라이언트 라이브러리
  • keyring: API 키를 안전하게 관리하기 위한 라이브러리
  • keyrings.alt: keyring의 파일 기반 백엔드

이번 예제 코드는 다음과 같은 구조로 설계되었습니다:

  1. WebSocket 기본 클래스: 스레드 기반으로 동작하며 재사용 가능한 WebSocket 연결 관리
  2. TickerWebSocket: 실시간 가격 정보 수신용
  3. OrderbookWebSocket: 실시간 호가 정보 수신용
  4. 비동기 처리: asyncio를 활용한 데이터 처리 루프
class WebSocket(threading.Thread):
def __init__(self, subscribe_type: str, codes: list):
super().__init__(daemon=True) # 데몬 스레드로 설정
self.ws = websocket.WebSocketApp(...)

daemon=True로 설정하면 메인 프로그램이 종료될 때 함께 종료됩니다.

업비트 WebSocket API는 다음 형식의 구독 메시지를 요구합니다:

subscribe_message = [
{"ticket": str(uuid.uuid4())}, # 고유 식별자
{"type": "ticker", "codes": ["KRW-BTC", "KRW-ETH"]}, # 구독 정보
]
  • ticket: 요청을 구분하는 고유 ID (UUID 사용 권장)
  • type: 데이터 타입 (ticker, orderbook, trade 등)
  • codes: 구독할 마켓 코드 리스트
self.ws.run_forever(ping_interval=30, ping_timeout=10, reconnect=2)
  • ping_interval=30: 30초마다 ping 메시지 전송
  • ping_timeout=10: ping 응답 타임아웃 10초
  • reconnect=2: 연결 끊김 시 2초 후 자동 재연결
async def process(self):
count = 0
last_time = 0
while True:
if self.last_data:
self.process_data() # 데이터 처리 로직
count += 1
await asyncio.sleep(1 - (time.time() - last_time))
last_time = time.time()

매 초마다 최신 데이터를 처리하면서도 정확한 시간 간격을 유지합니다.

공개 데이터(가격, 호가)는 API 키 없이도 사용 가능하지만, 개인 거래 정보에는 필요합니다:

import keyring
from keyrings.alt.file import PlaintextKeyring
keyring.set_keyring(PlaintextKeyring())
keyring.set_password("upbit", "access_key", "your_access_key")
keyring.set_password("upbit", "secret_key", "your_secret_key")
Terminal window
python your_script.py

실행하면 다음과 같은 출력을 볼 수 있습니다:

WebSocket created: ticker ['KRW-ETH']
WebSocket created: orderbook ['KRW-ETH']
Starting WebSocket thread: ticker ['KRW-ETH']
Starting WebSocket thread: orderbook ['KRW-ETH']
Inserted ticker data at timestamp 1707393600000 | Count: 1
Inserted orderbook data at timestamp 1707393600000 | Count: 1

이 코드를 기반으로 다음과 같은 기능을 추가할 수 있습니다:

  1. 데이터베이스 저장: process_data() 메서드에서 MongoDB, PostgreSQL 등에 저장
  2. 실시간 알림: 특정 가격 도달 시 알림 전송
  3. 차트 시각화: Plotly, Matplotlib 등으로 실시간 차트 업데이트
  4. 트레이딩 봇: 가격 변동에 따른 자동 매매 로직 구현
  5. ML 모델 학습: 실시간 데이터를 feature로 활용
import asyncio
import uuid
import websocket
import threading
import json
import time
from keyrings.alt.file import PlaintextKeyring
import keyring
keyring.set_keyring(PlaintextKeyring())
# codes
# https://docs.upbit.com/kr/reference/list-trading-pairs
BITCOIN = "KRW-BTC"
ETHEREUM = "KRW-ETH"
access_key = keyring.get_password("upbit", "access_key")
secret_key = keyring.get_password("upbit", "secret_key")
class WebSocket(threading.Thread):
def __init__(self, subscribe_type: str, codes: list):
super().__init__(daemon=True)
self.ws = websocket.WebSocketApp(
"wss://api.upbit.com/websocket/v1",
on_open=self.on_open,
on_message=self.on_message,
on_error=self.on_error,
on_close=self.on_close
)
self.last_data = None
self.subscribe_type = subscribe_type
self.codes = codes
def on_open(self, ws):
assert self.subscribe_type != "", "subscribe_type must be set before running the WebSocket"
assert self.codes, "codes must be set before running the WebSocket"
print(f"WebSocket created: {self.subscribe_type} {self.codes}")
subscribe_message = [
{"ticket": str(uuid.uuid4())},
{"type": self.subscribe_type, "codes": self.codes},
]
ws.send(json.dumps(subscribe_message))
def on_message(self, ws, message):
data = json.loads(message)
self.last_data = data
def on_error(self, ws, err):
print(f"Error in WebSocket {self.subscribe_type} {self.codes}:", err)
def on_close(self):
print(f"WebSocket closed: {self.subscribe_type} {self.codes}")
def run(self):
print(f"Starting WebSocket thread: {self.subscribe_type} {self.codes}")
self.ws.run_forever(ping_interval=30, ping_timeout=10, reconnect=2)
async def process(self):
count = 0
last_time = 0
while True:
if self.last_data:
self.process_data()
count += 1
print(f"\rInserted {self.subscribe_type} data at timestamp {self.last_data['timestamp']} | Count: {count}", end="", flush=True)
await asyncio.sleep(1 - (time.time() - last_time))
last_time = time.time()
def process_data(self):
pass
class TickerWebSocket(WebSocket):
def __init__(self):
super().__init__(subscribe_type="ticker", codes=[ETHEREUM])
def process_data(self):
# do something
pass
class OrderbookWebSocket(WebSocket):
def __init__(self):
super().__init__(subscribe_type="orderbook", codes=[ETHEREUM])
def process_data(self):
# do something
pass
async def main():
ticker_ws = TickerWebSocket()
orderbook_ws = OrderbookWebSocket()
ticker_ws.start()
orderbook_ws.start()
ticker_task = asyncio.create_task(ticker_ws.process())
orderbook_task = asyncio.create_task(orderbook_ws.process())
await asyncio.gather(ticker_task, orderbook_task)
if __name__ == "__main__":
asyncio.run(main())
  1. 연결 안정성: 네트워크 상태에 따라 연결이 끊길 수 있으므로 재연결 로직이 중요합니다.
  2. 메모리 관리: last_data를 계속 덮어쓰므로 메모리 누수는 없지만, 데이터를 저장하는 경우 메모리 관리에 주의해야 합니다.
  3. 에러 처리: 실제 운영 환경에서는 더 상세한 에러 처리와 로깅이 필요합니다.

이번 포스트에서는 업비트 WebSocket API를 활용한 실시간 데이터 수집 방법을 알아보았습니다.

핵심 포인트:

  • WebSocket은 실시간 데이터 수집에 효율적입니다
  • 스레드와 asyncio를 조합하여 안정적인 데이터 처리가 가능합니다
  • 자동 재연결 기능으로 연결 안정성을 확보할 수 있습니다

이 코드를 기반으로 여러분만의 트레이딩 시스템이나 분석 도구를 만들어보세요!