콘텐츠로 이동
25 posts in the category “Finance”

방산주는 왜 장기 성장주로 평가받는가
항공우주 생산시설과 방산 산업의 장기 성장을 표현한 이미지

방산주는 국제 정세가 불안해질 때마다 주목받는 테마주로 소개되곤 합니다. 그러나 방산 기업을 단순히 뉴스에 반응하는 종목으로만 보면 산업의 구조적 변화를 놓칠 수 있습니다. 국방 예산의 장기 계획, 무기체계 교체 주기, 수출 계약, 유지보수 사업이 서로 연결되면서 방산은 긴 시간 동안 매출이 누적되는 산업이기 때문입니다.

이 글에서는 한화에어로스페이스와 한국항공우주를 대표 사례로 삼아, 방산주를 장기 성장주 관점에서 볼 때 확인해야 할 요소를 정리합니다. 특정 종목의 매수·매도를 권유하는 글은 아닙니다.

방산 산업의 매출은 한 번의 계약으로 끝나지 않는다

섹션 제목: “방산 산업의 매출은 한 번의 계약으로 끝나지 않는다”

방산 사업은 일반 소비재처럼 매년 수요가 반복되는 구조와 다릅니다. 먼저 무기체계 도입 계약이 체결되고, 이후 생산·납품·정비·부품 교체·성능 개량이 이어집니다. 하나의 플랫폼이 장기간 운용되기 때문에 초기 수주뿐 아니라 후속 지원 사업도 중요한 매출원이 됩니다.

이 구조를 단순화하면 방산 기업의 매출은 다음과 같이 나눌 수 있습니다.

구분주요 내용투자자가 볼 지표
신규 수주전차, 자주포, 항공기, 엔진 등 신규 계약수주잔고, 계약 기간
생산·납품계약 물량을 실제 매출로 전환매출 인식 속도, 원가율
후속 지원정비, 부품, 개량, 교육·훈련반복 매출, 수익성
수출 확대해외 고객과 추가 국가 진입수출 비중, 환율, 현지 생산

따라서 보도된 계약 금액만 보고 기업가치를 판단하기보다 수주잔고가 몇 년에 걸쳐 매출과 영업현금흐름으로 전환되는지 확인해야 합니다.

수출이 장기 성장의 핵심인 이유

섹션 제목: “수출이 장기 성장의 핵심인 이유”

국내 방산 기업의 성장성은 국내 국방 예산만으로 결정되지 않습니다. 해외 수출이 늘어나면 고객 국가가 다양해지고 생산 규모가 커지면서 단위당 비용과 공급망 효율이 개선될 가능성이 있습니다. 동시에 수출 계약은 환율, 금융 조건, 현지 생산 의무, 기술 이전 조건의 영향을 받습니다.

수출 비중이 커지는 기업을 볼 때는 다음 질문이 필요합니다.

  • 수출 계약이 실제 납품 단계에 진입했나요?
  • 계약의 수익성이 국내 사업과 비교해 어떤가요?
  • 현지 조립·생산 조건이 원가에 어떤 영향을 주나요?
  • 환율 변동과 원자재 가격 상승을 계약이 얼마나 흡수하나요?
  • 한 국가 또는 한 플랫폼에 대한 의존도가 과도하지 않나요?

수출 계약은 성장 동력이 될 수 있지만, 계약 체결과 이익 실현 사이에 시간이 길다는 점도 함께 고려해야 합니다.

한화에어로스페이스(012450)는 지상방산과 항공엔진 등 여러 사업 축을 보유한 기업으로 분류할 수 있습니다. 이 기업을 분석할 때는 지상 무기체계의 수주잔고뿐 아니라 엔진 사업의 장기 공급 구조, 계열사 및 연결 실적, 대규모 계약의 생산 일정까지 함께 봐야 합니다.

한국항공우주(047810)는 항공기 개발·생산과 항공기 정비·훈련 등 항공우주 분야의 사업 구조가 중요한 기업입니다. 완제품 납품만이 아니라 개발비 부담, 양산 전환 시점, 후속 군수지원 매출, 해외 고객 확대 가능성을 구분해 분석해야 합니다.

두 기업은 모두 방산주로 묶이지만 매출이 발생하는 방식과 비용 구조가 다릅니다. 따라서 같은 업종의 주가수익비율만 단순 비교하기보다 사업별 매출 성장률과 영업이익률, 수주잔고의 질을 나누어 보는 것이 적절합니다.

실적보다 현금흐름을 먼저 확인해야 하는 경우

섹션 제목: “실적보다 현금흐름을 먼저 확인해야 하는 경우”

방산 기업은 장기 계약과 선투자가 많기 때문에 회계상 이익과 현금 유입 시점이 다를 수 있습니다. 매출과 영업이익이 증가해도 재고와 매출채권이 빠르게 늘면 현금흐름이 약해질 수 있습니다. 반대로 초기 생산 투자가 마무리되고 선수금이 유입되면 이후 현금 전환이 개선될 수도 있습니다.

분석할 때는 다음 항목을 함께 비교하는 것이 좋습니다.

  • 수주잔고 증가율과 매출 전환 속도
  • 영업이익률과 계약별 원가 변동
  • 영업활동현금흐름과 매출채권 증가폭
  • 재고자산과 설비투자 규모
  • 순차입금과 이자비용

특히 수주잔고가 크다는 이유만으로 높은 이익을 보장할 수는 없습니다. 계약 변경, 납품 지연, 원가 상승, 고객의 예산 집행 일정이 실제 수익성을 바꿀 수 있습니다.

첫째는 기대의 선반영입니다. 대형 수주 뉴스가 발표되면 향후 몇 년의 성장 기대가 단기간에 주가에 반영될 수 있습니다. 둘째는 정책과 외교 위험입니다. 수출 승인은 기업의 기술력만으로 결정되지 않으며 정부 간 협상과 구매국의 예산에 영향을 받습니다.

셋째는 생산능력의 한계입니다. 수주가 급증해도 인력·부품·공장 증설이 따라가지 못하면 납품이 늦어지고 비용이 커질 수 있습니다. 마지막으로 환율과 원자재 가격, 기술 이전 조건은 계약 수익성에 영향을 줍니다.

종목을 비교하는 간단한 프레임

섹션 제목: “종목을 비교하는 간단한 프레임”

방산주를 비교할 때는 다음처럼 네 축으로 정리할 수 있습니다.

성장성 = 신규 수주 + 수출 확대 + 후속지원 매출
수익성 = 사업별 영업이익률 + 원가 관리 + 생산 효율
현금성 = 영업현금흐름 + 선수금 + 운전자본 관리
위험성 = 고객·국가 집중도 + 납품 지연 + 정책·환율 변수

이 네 항목을 분기별로 업데이트하면 주가가 수주 뉴스에만 반응하는지, 실제 실적과 현금흐름이 개선되고 있는지 구분하는 데 도움이 됩니다.

방산주가 장기 성장주로 평가받는 이유는 단기적인 지정학적 이슈 때문만이 아닙니다. 장기 국방 계획, 교체 수요, 수출 확대, 생산·정비·개량으로 이어지는 매출 구조가 성장의 기반이 될 수 있기 때문입니다.

다만 수주잔고가 곧바로 이익이나 현금이 되는 것은 아닙니다. 방산 기업을 분석할 때는 수주 규모보다 매출 전환 속도, 수출 계약의 수익성, 생산능력, 영업현금흐름을 함께 확인해야 합니다. 기대가 큰 산업일수록 계약의 질과 실행력을 점검하는 과정이 중요합니다.

이 글은 방산 산업과 기업 분석 방법을 설명하기 위한 자료이며, 특정 종목의 투자 결과를 보장하지 않습니다.
반도체가 만든 420억 달러 경상수지 흑자, 한국 경제의 체력은 얼마나 강해졌나

반도체가 만든 420억 달러 경상수지 흑자 대표 이미지

2026년 9월 4일 한국 경제에서 가장 주목할 숫자는 420억 8,000만 달러입니다. 한국은행이 발표한 2026년 7월 국제수지 잠정치에 따르면 한국의 경상수지는 420억 8,000만 달러 흑자를 기록했습니다. 월간 기준 역대 두 번째 규모이며, 7월 기준으로는 가장 큰 흑자입니다.

하지만 이 숫자를 곧바로 “한국 경제 전반이 회복됐다”고 해석하기는 어렵습니다. 이번 기록은 반도체와 컴퓨터 관련 수출이 만든 외수의 힘을 보여주는 동시에, 특정 산업 의존도가 높아진 한국 경제의 구조적 과제도 함께 드러냅니다.

경상수지 흑자는 무엇을 의미하나

섹션 제목: “경상수지 흑자는 무엇을 의미하나”

경상수지는 상품과 서비스의 수출입, 해외에서 벌어들인 본원소득, 이전소득을 합산한 국제수지입니다. 간단히 말하면 한국이 해외와 거래하면서 벌어들인 외화가 지출한 외화보다 얼마나 많은지를 보여주는 지표입니다.

흑자가 커지면 외화 유동성과 대외 지급 능력에는 긍정적입니다. 원화와 외환시장에 안정 요인이 될 수 있고, 기업의 수출 대금과 해외 투자자금 흐름에도 영향을 줍니다. 다만 경상수지 흑자는 국민경제의 모든 부문이 좋아졌다는 종합성적표는 아닙니다. 수출이 늘어도 가계 소비와 건설투자, 서비스업 고용이 부진할 수 있기 때문입니다.

CURRENT ACCOUNT · JUL 2026

경상수지 흑자

잠정
420.8 억 달러

월간 기준 역대 두 번째 · 2개월 연속 400억 달러 상회

상품수지+458.2억
서비스수지−24.1억
본원소득수지+3.5억

MONTHLY TREND

2026년 경상수지 추이

억 달러

이번 흑자의 중심에는 반도체가 있습니다

섹션 제목: “이번 흑자의 중심에는 반도체가 있습니다”

이번 발표에서 확인되는 가장 중요한 배경은 반도체 수출 호조입니다. 인공지능 데이터센터 투자와 고성능 컴퓨팅 확산으로 메모리와 관련 컴퓨터 기기 수요가 이어지면서 상품수지가 크게 개선됐습니다. 7월 경상수지가 두 달 연속 400억 달러를 웃돈 것도 상품수지의 강한 흑자 흐름과 연결됩니다.

이 흐름은 한국 제조업의 경쟁력을 다시 확인시켜 줍니다. 삼성전자와 SK하이닉스를 중심으로 한 메모리 공급망은 AI 투자 사이클의 직접적인 수혜를 받고 있으며, 장비·소재·부품 기업으로 수요가 확산될 가능성도 있습니다. 실제로 9월 4일 국내 증시는 미국 금리 부담 완화와 반도체 대형주 강세가 겹치며 코스피와 코스닥이 동반 상승 출발했습니다.

다만 수출 증가를 이익 증가와 동일시해서는 안 됩니다. 반도체 가격, 제품 믹스, 고객사의 재고 조정, 미국의 통상정책과 현지 생산 요구에 따라 수출액과 기업 이익은 달라질 수 있습니다.

기록적인 흑자에도 남는 세 가지 질문

섹션 제목: “기록적인 흑자에도 남는 세 가지 질문”

1. 반도체 의존도가 지나치게 높지 않은가

섹션 제목: “1. 반도체 의존도가 지나치게 높지 않은가”

반도체가 경상수지를 견인하는 것은 강점이지만, 동시에 집중 위험입니다. 글로벌 IT 투자 사이클이 둔화되거나 메모리 가격이 조정되면 상품수지와 기업 실적이 함께 흔들릴 수 있습니다. 자동차, 조선, 방산, 바이오, 콘텐츠와 같은 수출 산업이 안정적으로 성장해 수출 기반을 넓히는지가 중요합니다.

2. 흑자가 내수 회복으로 이어지는가

섹션 제목: “2. 흑자가 내수 회복으로 이어지는가”

경상수지 흑자는 해외에서 벌어들인 외화 흐름을 보여줍니다. 이것이 임금·투자·소비 확대로 이어지는지는 별도로 확인해야 합니다. 수출 대기업의 실적이 개선되더라도 중소기업, 서비스업, 지역경제로 확산되지 않으면 체감경기는 약할 수 있습니다.

3. 서비스수지와 소득수지는 어떤 방향인가

섹션 제목: “3. 서비스수지와 소득수지는 어떤 방향인가”

상품수지가 크게 개선된 달에도 여행·운송·지식서비스 등 서비스수지는 적자를 낼 수 있습니다. 해외 배당과 이자 수입이 늘어나는지, 반대로 외국인 투자자에 대한 배당 지급이 커지는지도 살펴봐야 합니다. 경상수지의 질을 판단하려면 전체 흑자 규모뿐 아니라 구성 항목의 지속성까지 확인해야 합니다.

금융시장과 투자자가 볼 체크포인트

섹션 제목: “금융시장과 투자자가 볼 체크포인트”

첫째, 반도체 수출 증가가 물량 증가인지 가격 상승인지 구분해야 합니다. 물량과 가격이 함께 개선되는 국면이라면 업황의 지속성이 높지만, 가격만 급등한 경우에는 변동성이 커질 수 있습니다.

둘째, 4분기 반도체 장비 발주와 설비투자 계획을 확인해야 합니다. 장비 주문이 실제로 늘면 이번 수출 사이클이 생산능력 확장과 공급망 전반의 실적 개선으로 이어질 가능성이 커집니다.

셋째, 미국의 반도체 통상정책과 현지 투자 요구를 봐야 합니다. 미국 현지 생산 확대는 장기적으로 고객 접근성을 높일 수 있지만, 국내 생산과 수출의 일부가 현지 생산으로 대체되는 효과도 함께 따져야 합니다.

넷째, 반도체를 제외한 수출과 내수 지표가 개선되는지 확인해야 합니다. 한국 경제의 회복이 특정 업종의 슈퍼사이클인지, 아니면 폭넓은 경기 회복인지를 가르는 기준입니다.

결론: 강한 외수, 아직 확인이 필요한 내수

섹션 제목: “결론: 강한 외수, 아직 확인이 필요한 내수”

7월 경상수지 420억 8,000만 달러 흑자는 한국이 AI와 반도체라는 글로벌 투자 흐름에서 상당한 수혜를 받고 있다는 분명한 신호입니다. 외환 안정과 수출기업 실적, 관련 장비·소재 산업에는 긍정적입니다.

그러나 기록적인 경상수지 흑자만으로 경기 전반의 회복을 단정하기는 어렵습니다. 앞으로는 반도체 수출의 지속성, 서비스수지 개선, 내수와 고용으로의 확산 여부를 함께 봐야 합니다. 이번 통계가 보여주는 한국 경제의 모습은 강한 수출 엔진을 다시 가동했지만, 그 동력이 경제 전체로 전달되는지는 아직 확인해야 하는 단계에 가깝습니다.

이 글은 2026년 9월 4일 공개된 한국은행 2026년 7월 국제수지 잠정 통계와 당일 경제 보도를 바탕으로 작성한 경제 해설입니다. 잠정치는 추후 수정될 수 있으며, 특정 금융상품의 매수·매도를 권유하지 않습니다.

  • 한국은행, 2026년 7월 국제수지(잠정)
  • 네이버 뉴스 경제 섹션, 2026-09-04 경제·증권 주요 보도
  • 한국은행 국제수지 통계 해설

AI 반도체 ETF 비교: 국내형과 미국형, 무엇이 다를까?

AI 반도체 ETF 비교 대표 이미지

AI 반도체 ETF를 찾을 때 가장 먼저 보이는 것은 최근 수익률입니다. 그러나 같은 ‘AI 반도체’라는 이름을 사용해도 국내 메모리 공급망에 집중하는 상품과 미국 팹리스·장비 기업을 담는 상품은 움직이는 이유가 다릅니다. 이 글에서는 최신 거래일 기준 데이터를 바탕으로 국내형 RISE AI반도체TOP10(0093A0)과 미국형 KODEX 미국AI반도체TOP3플러스(0151S0)를 비교합니다.

구분RISE AI반도체TOP10KODEX 미국AI반도체TOP3플러스
코드0093A00151S0
투자 지역한국미국
최신 기준일2026-09-032026-09-03
최신 종가30,400원14,345원
2026-06-01 종가39,665원17,887원

가격 수준 자체는 상품 간 비교 기준이 아닙니다. ETF 분할과 설정 시점이 다르기 때문에 수익률, 변동성, 구성종목 중복도를 함께 봐야 합니다.

수익률만 보면 국내형이 더 약했다

섹션 제목: “수익률만 보면 국내형이 더 약했다”

2026년 6월 1일부터 9월 3일까지 단순 가격 수익률은 RISE AI반도체TOP10이 약 -23.3%, KODEX 미국AI반도체TOP3플러스가 약 -19.8%였습니다. 두 상품 모두 조정을 받았지만, 국내형의 하락폭이 조금 더 컸습니다. 반도체 업황이 같아 보여도 원화 환율, 미국 기술주 밸류에이션, 국내 대형주 비중에 따라 결과가 달라질 수 있다는 뜻입니다.

다만 이 수치는 분배금과 거래비용을 반영하지 않은 종가 기준 단순 계산입니다. 실제 투자 성과를 비교할 때는 총수익률과 환헤지 여부를 확인해야 합니다.

국내형 ETF는 삼성전자·SK하이닉스와 국내 소재·장비 기업의 실적에 민감합니다. 메모리 가격과 HBM 출하가 개선되면 이익 레버리지가 커질 수 있지만, 특정 기업과 국내 수출 사이클에 위험이 집중될 수 있습니다.

미국형 TOP3 상품은 소수 종목 비중이 높아 ‘분산 ETF’라는 이름만으로 위험이 낮다고 보기 어렵습니다. 대신 엔비디아와 미국 반도체 설계·장비 기업의 AI 데이터센터 투자, 미국 기술주 흐름, 달러 가치가 함께 반영됩니다. 국내 투자자 입장에서는 주가 변동에 환율 변동까지 더해질 수 있습니다.

  • 한국 메모리와 HBM 사이클을 직접 보고 싶다면 국내형을 검토할 수 있습니다.
  • 미국 AI 인프라와 글로벌 팹리스 생태계에 투자하고 싶다면 미국형이 더 직접적인 선택입니다.
  • 하락장에서 버틸 상품을 찾는다면 이름보다 상위 보유종목 비중, 최근 최대낙폭, 거래대금을 먼저 비교해야 합니다.

첫째, HBM과 DRAM 가격이 물량 증가를 동반하는지 확인해야 합니다. 둘째, ETF의 상위 3~5개 종목 비중이 높아졌는지 살펴봐야 합니다. 셋째, 원·달러 환율과 미국 반도체 지수의 방향을 함께 봐야 합니다. 마지막으로 최근 수익률이 높다는 이유만으로 추격 매수하지 말고, 동일 기간의 최대낙폭과 회복 기간을 비교해야 합니다.

AI 반도체 ETF 비교에서 ‘국내형이냐 미국형이냐’보다 중요한 것은 어떤 위험을 감수할 것인지입니다. 국내형은 메모리와 HBM이라는 명확한 산업 노출을 제공하지만 한국 대형주와 수출 사이클에 집중됩니다. 미국형은 글로벌 AI 투자에 접근하지만 소수 종목과 환율 위험이 커질 수 있습니다. 따라서 수익률 순위 하나가 아니라 구성종목 집중도·환율 민감도·최대낙폭·거래대금을 같은 기간에 비교한 뒤 투자 비중을 결정하는 것이 합리적입니다.

이 글은 특정 ETF의 매수·매도를 권유하지 않으며, 투자 판단과 손익의 책임은 투자자에게 있습니다.

주식 종목 분석에서 신용 거래 데이터 활용

주식 신용 거래 데이터 분석 대표 이미지

주식 시장에서 신용 거래 데이터는 개인 투자자들의 심리와 레버리지 수준을 파악할 수 있는 핵심 보조 지표입니다. 이번 포스트에서는 신용 거래 데이터의 각 항목이 무엇을 의미하는지, 그리고 이를 종목 분석에 어떻게 활용할 수 있는지 다루겠습니다.

신용 거래는 증권사로부터 자금이나 주식을 빌려서 매매하는 방식으로, 크게 두 가지로 나뉩니다.

구분설명
융자증권사에서 돈을 빌려 주식을 매수 (레버리지 매수)
대주증권사에서 주식을 빌려 매도 (공매도의 일종)

융자 잔고가 늘어난다는 것은 개인 투자자들이 빚을 내서까지 해당 종목을 사고 있다는 뜻이고, 대주 잔고가 늘어난다는 것은 해당 종목의 하락에 베팅하는 수요가 있다는 뜻입니다.

신용 거래 데이터는 일반적으로 증권사 API나 HTS에서 다음과 같은 항목들로 제공됩니다. 아래는 키움증권 API를 통해 수집할 수 있는 항목들입니다.

항목설명
종목코드대상 종목
일자거래 기준일
조회구분융자(1) 또는 대주(2)
현재가해당일 종가
거래량해당일 거래량
신규해당일 새로 발생한 신용 거래 수량
상환해당일 상환(청산)된 신용 거래 수량
잔고현재 미상환 신용 거래 누적 수량
금액잔고의 금액 환산 (잔고 × 현재가)
대비전일 대비 잔고 변화량
공여율증권사가 공여한 비율
잔고율상장주식수 대비 신용 잔고 비율 (%)

데이터를 DB에 저장한다면 다음과 같은 테이블 구조로 설계할 수 있습니다.

stock_credit 테이블
─────────────────────────────────────────────
code (PK) 종목코드 예: '005930'
date (PK) 일자 예: '20260220'
qry_tp (PK) 조회구분 1:융자, 2:대주
close 현재가
volume 거래량
new 신규
repayment 상환
balance 잔고
amount 금액
balance_diff 대비
supply_ratio 공여율
balance_ratio 잔고율
─────────────────────────────────────────────

분석 예시를 위해 가상의 종목 A에 대한 20일간 융자 데이터를 만들어 보겠습니다.

import pandas as pd
# 종목 A의 융자(신용매수) 데이터 예시
df = pd.DataFrame({
"date": [
"20260203", "20260204", "20260205", "20260206", "20260207",
"20260210", "20260211", "20260212", "20260213", "20260214",
"20260217", "20260218", "20260219", "20260220", "20260221",
"20260224", "20260225", "20260226", "20260227", "20260228",
],
"close": [
50000, 50500, 51200, 52000, 53500,
54000, 55000, 54200, 53000, 51500,
50800, 50000, 49500, 48000, 47000,
47500, 48200, 49000, 50500, 51000,
],
"volume": [
1200000, 1350000, 1500000, 1800000, 2200000,
1900000, 2500000, 2100000, 2800000, 3200000,
2600000, 2400000, 2000000, 3500000, 3000000,
1800000, 1600000, 1400000, 1300000, 1200000,
],
"new": [
150, 200, 280, 350, 500,
420, 600, 380, 300, 250,
200, 180, 150, 120, 100,
130, 160, 140, 120, 110,
],
"repayment": [
100, 120, 130, 150, 180,
200, 220, 350, 400, 380,
350, 300, 280, 350, 320,
200, 180, 170, 150, 140,
],
"balance": [
3050, 3130, 3280, 3480, 3800,
4020, 4400, 4430, 4330, 4200,
4050, 3930, 3800, 3570, 3350,
3280, 3260, 3230, 3200, 3170,
],
"amount": [
15250, 15807, 16794, 18096, 20330,
21708, 24200, 24011, 22949, 21630,
20574, 19650, 18810, 17136, 15745,
15580, 15713, 15827, 16160, 16167,
],
"balance_ratio": [
1.02, 1.04, 1.09, 1.16, 1.27,
1.34, 1.47, 1.48, 1.44, 1.40,
1.35, 1.31, 1.27, 1.19, 1.12,
1.09, 1.09, 1.08, 1.07, 1.06,
],
})

위 데이터는 “상승 → 과열 → 하락 → 안정” 의 전형적인 사이클을 보여줍니다.

1. 잔고율(balance_ratio)로 과열 여부 판단

섹션 제목: “1. 잔고율(balance_ratio)로 과열 여부 판단”

잔고율은 상장주식수 대비 신용 잔고의 비율입니다. 이 값이 높을수록 레버리지 매수가 과도하게 쌓여 있다는 뜻입니다.

import matplotlib.pyplot as plt
fig, ax1 = plt.subplots(figsize=(12, 5))
ax2 = ax1.twinx()
ax1.plot(df["date"], df["close"], label="주가", color="black", marker="o", markersize=3)
ax2.bar(df["date"], df["balance_ratio"], alpha=0.3, label="잔고율(%)", color="red")
ax2.axhline(y=1.3, color="red", linestyle="--", alpha=0.5, label="주의 기준선")
ax1.set_ylabel("주가")
ax2.set_ylabel("잔고율(%)")
ax1.set_xticklabels(df["date"], rotation=45, ha="right")
plt.title("주가 vs 융자 잔고율")
fig.tight_layout()
plt.show()

예시 데이터를 보면 잔고율이 1.47%까지 올라간 2월 11일을 정점으로, 이후 주가가 하락하면서 잔고율도 함께 줄어드는 전형적인 패턴을 확인할 수 있습니다.

해석 기준 (종목/업종별로 기준이 다를 수 있음):

  • 잔고율 평소 대비 급등: 신용 매수 과열 → 주의 필요
  • 잔고율 고점 유지 + 주가 하락: 반대매매 리스크 존재
  • 잔고율 급등 후 주가 하락: 반대매매 연쇄로 추가 하락 가능성

2. 신규(new) vs 상환(repayment) 추이로 수급 방향 파악

섹션 제목: “2. 신규(new) vs 상환(repayment) 추이로 수급 방향 파악”

신규가 상환보다 많으면 신용 매수세가 유입되고 있다는 뜻이고, 반대면 청산이 진행 중입니다.

# 신규 - 상환 = 순신규
df["net_new"] = df["new"] - df["repayment"]
# 5일 이동평균
df["net_new_ma5"] = df["net_new"].rolling(5).mean()
fig, ax1 = plt.subplots(figsize=(12, 5))
ax2 = ax1.twinx()
ax1.plot(df["date"], df["close"], label="주가", color="black", marker="o", markersize=3)
colors = ["blue" if v >= 0 else "red" for v in df["net_new"]]
ax2.bar(df["date"], df["net_new"], alpha=0.3, color=colors)
ax2.plot(df["date"], df["net_new_ma5"], label="순신규 MA5", color="orange")
ax2.axhline(y=0, color="gray", linestyle="--")
ax1.set_ylabel("주가")
ax2.set_ylabel("순신규 (신규 - 상환)")
ax1.set_xticklabels(df["date"], rotation=45, ha="right")
plt.title("순신규 융자 추이")
fig.tight_layout()
plt.show()

예시에서 2월 첫째 주에는 순신규가 양수(파란색)로 신용 매수가 활발했지만, 2월 12일부터 순신규가 음수(빨간색)로 전환되면서 청산이 시작되었습니다. 이 시점이 주가 하락과 일치합니다.

해석:

  • 순신규 양수 지속: 개인의 레버리지 매수 증가 → 단기 상승 기대감, 하지만 과열 주의
  • 순신규 음수 전환: 신용 청산 시작 → 매도 압력 증가 가능

3. 잔고 변화와 주가 방향의 다이버전스

섹션 제목: “3. 잔고 변화와 주가 방향의 다이버전스”

주가는 상승하는데 신용 잔고가 급증하는 경우, 또는 주가가 하락하는데 신용 잔고가 줄지 않는 경우는 위험 신호입니다.

# 주가 변화율 vs 잔고 변화율 비교
df["price_change"] = df["close"].pct_change()
df["balance_change"] = df["balance"].pct_change()
# 주가 하락 + 잔고 증가 = 위험 신호
df["danger_signal"] = (df["price_change"] < -0.01) & (df["balance_change"] > 0)
print(df[["date", "close", "price_change", "balance", "balance_change", "danger_signal"]])

예시 데이터에서 2월 12일을 보면, 주가가 54,000→54,200→53,000으로 하락하는데 잔고는 4,020→4,430→4,330으로 여전히 높은 수준을 유지합니다. 이런 구간이 반대매매 리스크가 높은 구간입니다.

시나리오주가신용 잔고해석
건전한 상승↑→ 또는 ↓자기자본 매수 → 안정적
과열 상승↑↑↑레버리지 의존 → 조정 시 급락 위험
위험 하락↓→ 또는 ↑물타기 or 미청산 → 반대매매 리스크
건전한 조정↓↓손절 진행 → 바닥 형성 가능

4. 융자와 대주 데이터 결합 분석

섹션 제목: “4. 융자와 대주 데이터 결합 분석”

융자(조회구분=1)와 대주(조회구분=2)를 함께 보면 시장 참여자들의 방향성에 대한 더 입체적인 분석이 가능합니다.

# 융자 잔고 (위의 df에서 가져옴)
df_loan = df[["date", "balance", "balance_ratio"]].rename(
columns={"balance": "loan_balance", "balance_ratio": "loan_ratio"}
)
# 같은 종목의 대주 잔고 예시
df_borrow = pd.DataFrame({
"date": df["date"],
"borrow_balance": [
200, 210, 220, 250, 280,
300, 350, 400, 450, 500,
520, 530, 510, 480, 450,
420, 390, 370, 350, 330,
],
"borrow_ratio": [
0.07, 0.07, 0.07, 0.08, 0.09,
0.10, 0.12, 0.13, 0.15, 0.17,
0.17, 0.18, 0.17, 0.16, 0.15,
0.14, 0.13, 0.12, 0.12, 0.11,
],
})
df_combined = df_loan.merge(df_borrow, on="date")
df_combined["loan_borrow_ratio"] = df_combined["loan_balance"] / df_combined["borrow_balance"]
fig, ax1 = plt.subplots(figsize=(12, 5))
ax1.plot(df_combined["date"], df_combined["loan_borrow_ratio"], marker="o", markersize=3)
ax1.set_ylabel("융자/대주 비율")
ax1.set_xticklabels(df_combined["date"], rotation=45, ha="right")
plt.title("융자/대주 잔고 비율 추이")
fig.tight_layout()
plt.show()

해석:

  • 융자/대주 비율 상승: 매수 레버리지가 매도보다 우세 → 강세 심리
  • 융자/대주 비율 하락: 매도(대주) 비중 증가 → 약세 심리 또는 헷지 수요

5. 신용 금액(amount)으로 레버리지 규모 파악

섹션 제목: “5. 신용 금액(amount)으로 레버리지 규모 파악”

잔고율과 함께 금액 항목을 보면 실제 레버리지의 절대 규모를 파악할 수 있습니다.

fig, ax1 = plt.subplots(figsize=(12, 5))
ax2 = ax1.twinx()
ax1.plot(df["date"], df["close"], label="주가", color="black", marker="o", markersize=3)
ax2.fill_between(range(len(df)), df["amount"], alpha=0.2, color="green", label="신용 금액")
ax2.plot(df["date"], df["amount"], color="green", alpha=0.7)
ax1.set_ylabel("주가")
ax2.set_ylabel("신용 금액 (백만원)")
ax1.set_xticklabels(df["date"], rotation=45, ha="right")
plt.title("주가 vs 신용 잔고 금액")
fig.tight_layout()
plt.show()

예시에서 신용 금액은 2월 11일 24,200백만원으로 최고치를 기록한 뒤, 주가 하락과 함께 15,745백만원까지 줄어들었습니다. 금액 감소가 잔고 감소보다 빠른 것은 주가 하락 효과가 더해졌기 때문입니다.

  1. 매수 전 체크리스트에 포함: 관심 종목의 잔고율이 급등하고 있다면 진입 시점을 늦추는 것이 안전합니다.

  2. 반대매매 임계점 인식: 잔고율이 높은 상태에서 주가가 5% 이상 하락하면 반대매매가 연쇄적으로 발생할 수 있습니다.

  3. 바닥 확인 신호: 신용 잔고가 충분히 줄어든 후(상환 > 신규 지속) 주가가 반등하면 건전한 바닥 형성의 신호일 수 있습니다.

  4. 섹터 단위 분석: 특정 섹터 전체의 신용 잔고율이 높아지면 해당 섹터의 과열을 의미할 수 있습니다.

  5. 시계열 피처로 활용: 머신러닝 모델의 입력 피처로 잔고율, 순신규 추이, 잔고 변화율 등을 추가하면 예측 성능 향상에 도움이 됩니다.

지표활용주의 사항
잔고율과열 판단, 반대매매 리스크업종별 평균 수준 고려 필요
신규/상환수급 방향 파악단일일 데이터보다 추세 중요
잔고 대비일별 변화 모니터링주가 방향과 함께 분석
금액레버리지 절대 규모시가총액 대비로 비교
공여율증권사 리스크 관리 수준증권사별 차이 존재

신용 거래 데이터는 단독으로 사용하기보다는 주가, 거래량, 투자자별 매매동향 등 다른 지표와 결합하여 분석할 때 훨씬 큰 인사이트를 얻을 수 있습니다. 특히 개인 투자자 중심의 한국 주식 시장에서는 융자 잔고율이 시장 과열과 조정의 선행 지표로 유용하게 활용됩니다.

MSCI 지수란 무엇인가? 글로벌 투자의 나침반

MSCI 글로벌 주가지수 대표 이미지

주식 투자를 하다 보면 뉴스나 경제 기사에서 MSCI 지수(MSCI Index)라는 용어를 자주 접하게 됩니다. 특히 “한국 증시의 MSCI 선진국 지수 편입”과 같은 기사는 매년 단골로 등장하는 주제이기도 합니다. 그렇다면 MSCI 지수는 정확히 무엇이며, 왜 전 세계 투자자들이 이 지수에 주목하는 것일까요?

이번 글에서는 MSCI 지수의 개념과 중요성, 그리고 주요 지수들을 확인하는 방법에 대해 알아보겠습니다.

MSCI(Morgan Stanley Capital International) 지수는 미국의 투자은행인 모건스탠리의 자회사인 모건스탠리 캐피털 인터내셔널이 발표하는 글로벌 주가지수입니다.

전 세계 주식 시장을 선진국(Developed Markets), 신흥국(Emerging Markets), 프론티어 시장(Frontier Markets) 등으로 분류하고, 각 국가의 상장 주식들을 조합하여 산출합니다. MSCI 지수는 글로벌 펀드 매니저들이 투자 포트폴리오를 구성하거나 성과를 평가할 때 사용하는 가장 대표적인 벤치마크(기준) 역할을 합니다.

MSCI 지수가 금융 시장에서 막대한 영향력을 가지는 이유는 패시브 자금(Passive Funds) 때문입니다.

최근 몇 년간 특정 지수의 수익률을 그대로 추종하는 ETF(상장지수펀드)나 인덱스 펀드의 규모가 기하급수적으로 커졌습니다. 이러한 펀드들은 MSCI 지수를 추종하는 경우가 많습니다. 따라서 특정 국가나 기업이 MSCI 지수에 새로 편입되거나 비중이 늘어나면, 해당 지수를 추종하는 글로벌 자금이 기계적으로 유입되어 주가 상승을 견인하는 효과가 발생합니다. 반대로 지수에서 제외되거나 비중이 줄어들면 대규모 자금 유출이 일어날 수 있습니다.

MSCI는 전 세계 시장을 경제 발전 수준, 시장 규모, 유동성, 시장 접근성 등을 기준으로 크게 세 가지로 분류합니다.

  1. MSCI 선진국 지수 (World Index)
    • 미국, 일본, 영국, 프랑스, 독일 등 금융 시장이 고도로 발달한 국가들이 포함됩니다. 전 세계 주식 시장 시가총액의 대부분을 차지합니다.
  2. MSCI 신흥국 지수 (Emerging Markets Index, EM)
    • 중국, 인도, 대만, 브라질, 그리고 한국 등이 포함됩니다. 선진국에 비해 변동성은 크지만 높은 성장 잠재력을 가진 시장으로 평가받습니다.
  3. MSCI 프론티어 시장 지수 (Frontier Markets Index)
    • 베트남, 카자흐스탄, 모로코 등 신흥국보다 경제 규모나 금융 시장 발달 정도가 상대적으로 낮은 국가들이 포함됩니다.

한국은 현재 MSCI 신흥국(EM) 지수에 속해 있습니다. 한국 경제의 규모나 위상을 고려할 때 선진국 지수에 편입되어야 한다는 목소리가 꾸준히 나오고 있으며, 정부 차원에서도 외환시장 개방, 영문 공시 확대 등 시장 접근성을 개선하여 선진국 지수로 승격하기 위한 노력을 지속하고 있습니다. 선진국 지수에 편입될 경우, 코리아 디스카운트 해소와 함께 안정적인 글로벌 장기 투자 자금의 유입을 기대할 수 있습니다.

MSCI 지수는 단순한 숫자의 나열이 아니라, 글로벌 자본이 어느 방향으로 흘러가고 있는지를 보여주는 중요한 지표입니다. 성공적인 투자를 위해 MSCI 지수의 흐름을 꾸준히 모니터링해 보시기 바랍니다.

물가 지수와 코스피의 상관관계 분석

이번 포스트에서는 한국의 소비자/생산자 물가 지수와 코스피 사이의 상관관계를 분석합니다. 이 포스트에서 사용하는 데이터는 퀀티랩 네이버 카페의 금융 데이터 게시판에서 다운받을 수 있습니다.

먼저 다운받은 데이터들을 불러옵니다.

import pandas as pd
df_cpi = pd.read_csv('./cpi_20220215.csv', header=0)
df_ppi = pd.read_csv('./ppi_20220215.csv', header=0)
df_kospi = pd.read_csv('./kospi_20220218.csv', header=0)

이 세 데이터를 하나의 DataFrame으로 합치겠습니다. 코스피는 일별이고 CPI 및 PPI 데이터는 월별 데이터 입니다.

df = df_kospi.merge(df_cpi, how='left', on='month').fillna(method='ffill').dropna(subset=['cpi'])
df = df.merge(df_ppi, how='left', on='month').fillna(method='ffill').dropna(subset=['ppi'])
df['dt'] = pd.to_datetime(df['date'], format='%Y%m%d')
df['cpi'] = df['cpi'].astype(float)
df['ppi'] = df['ppi'].astype(float)
df = df.reset_index(drop=True)

월별 데이터를 일별 데이터로 month 열을 기준으로 left join 했습니다. 여기서 cpi, ppi 열의 데이터 형식이 문자열로 되어 있어서 float로 캐스팅 했습니다.

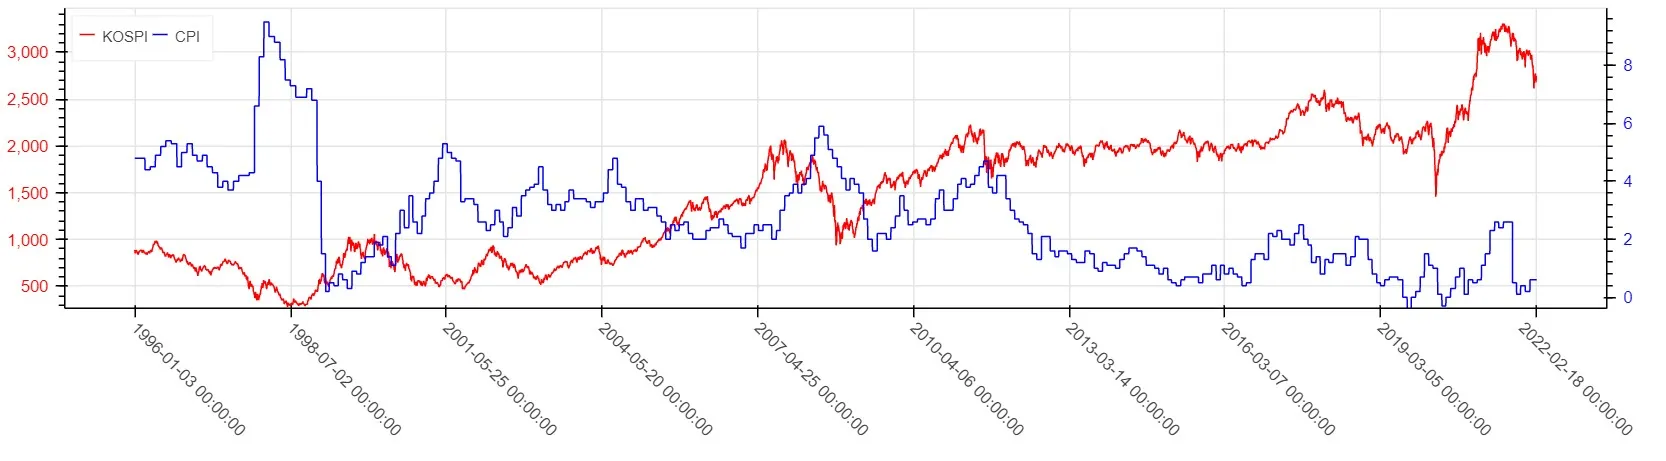
이제 코스피와 CPI, 코스피와 PPI 차트를 출력해 보려고 합니다. 두 데이터의 값의 범위가 크게 차이나기 때문에 y 축을 2개 사용합니다.

다음과 같이 두 시계열을 별도의 y축으로 그리는 함수인 get_multchart()를 작성했습니다.

def get_multchart(xticklabels, y1, y2, label1='', label2='', w=500, h=300, sizing_mode='stretch_width'):
x = np.arange(len(xticklabels))
xticks = np.linspace(0, len(xticklabels)-1, 10, endpoint=True, dtype=int).tolist()
p = figure(plot_width=w, plot_height=h, tools='', y_axis_location='left')
p.xaxis.ticker = xticks
p.xaxis.major_label_overrides = {_x: util.format_date(str(xticklabels[_x])) for _x in xticks}
p.xaxis.major_label_orientation = -np.pi / 4
p.yaxis.major_label_text_color = 'red'
p.yaxis.formatter = NumeralTickFormatter(format='0,0')
p.y_range = Range1d(y1.min() * 0.95, y1.max() * 1.05)
p.extra_y_ranges = {
'y2_range': Range1d(y2.min() * 0.95, y2.max() * 1.05)
}
y2_axis = LinearAxis(y_range_name='y2_range')
y2_axis.major_label_text_color = 'blue'
y2_axis.formatter = NumeralTickFormatter(format='0,0')
p.add_layout(y2_axis, 'right')
p.line(x, y1, line_color='red', legend_label=label1)
p.line(x, y2, line_color='blue', legend_label=label2, y_range_name='y2_range')
configure_legend(p)
grid = gridplot([[p]], toolbar_location=None, sizing_mode=sizing_mode)
return grid

이 함수를 이용해서 두 차트를 그립니다. 먼저 코스피와 CPI, 다음으로 코스피와 PPI를 그립니다.

from bokeh.io import output_notebook, show
output_notebook()
show(get_multchart(df['dt'], df['close'], df['cpi'], label1='KOSPI', label2='CPI'))
show(get_multchart(df['dt'], df['close'], df['ppi'], label1='KOSPI', label2='PPI'))

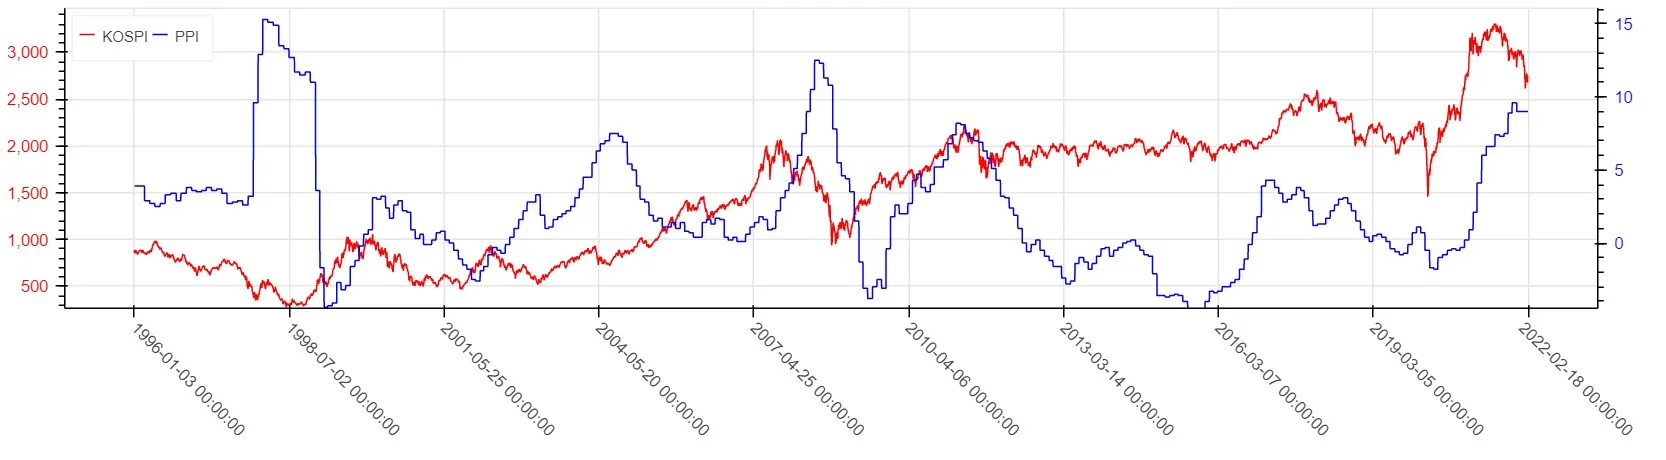
cpi

ppi

여기서 CPI, PPI는 전월 대비 % 값입니다. CPI와 코스피를 봤을 때 2001년 부근에서는 서로 역관계처럼 보이다가 2007년 부근에서는 코스피가 CPI를 선행하는 것처럼도 보입니다. PPI도 구간에 따라서 상관성이 다르게 보입니다. 즉 물가 지수와 코스피만으로 서로가 밀접한 상관성이 있다고 말할 수는 없어 보입니다. 이 부부은 2008년 금융위기로 주식 폭락과 물가

실제로 피어슨 상관계수를 구해 보면 구간에 따라서 매우 큰 차이가 생기는 것을 볼 수 있습니다.

from scipy.stats import pearsonr
_df = df[df['date'] >= '20150101']
print(pearsonr(_df['close'], _df['cpi']))
print(pearsonr(_df['close'], _df['ppi']))
(0.3184625030996628, 1.1693520291646116e-42)
(0.7737092632552787, 0.0)

그렇다고 상관성이 아주 없다고 볼 수도 없습니다. 주식 딥러닝 모델을 구축할 때 학습데이터의 피처로 충분히 활용할 만하다고 보입니다.

구글 검색 트렌드와 코스피 상관관계 분석

이번 포스트에서는 “kospi” 검색어에 대한 구글 검색 트렌드와 실제 코스피 지수를 한 차트에 그려보고 상관관계 분석을 해보겠습니다. 여기서 사용하는 데이터는 퀀티랩 네이버 카페에 올려 놓았습니다. 카페에 가입하시면 다운 받으실 수 있습니다.

위 데이터를 다운 받은 후 먼저 아래와 같이 구글 검색 트렌드 데이터를 불러옵니다. 이 데이터는 주간 단위의 데이터이므로 4년치라도 행의 수는 많지 않습니다.

import pandas as pd
df = pd.read_csv('./google_trend_kospi_2018_2021.csv', header=1)
df.columns = ['date', 'interest']
df['date'] = pd.to_datetime(df['date'], format="%Y-%m-%d")
df
indexdateinterest
02018-01-0726
12018-01-1430
22018-01-2128
32018-01-2829
42018-02-0433
………
2032021-11-2853
2042021-12-0556
2052021-12-1255
2062021-12-1960
2072021-12-2652

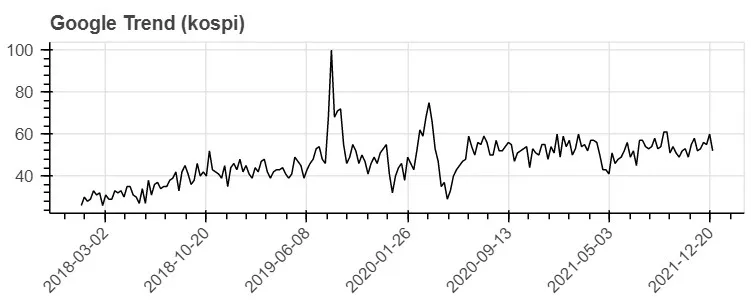
이 데이터를 다음처럼 차트로 그려볼 수 있습니다. 차트를 그릴 때 다양한 라이브러리를 활용할 수 있지만 여기서는 bokeh 라이브러리를 사용했습니다.

from math import pi
from bokeh.io import output_notebook, show
from bokeh.plotting import figure, gridplot
from bokeh.models import DatetimeTickFormatter
output_notebook()
grid = []
p = figure(title='Google Trend (kospi)', plot_width=500, plot_height=200, tools="crosshair")
p.line(df['date'], df['interest'], line_color='black')
p.xaxis.formatter = DatetimeTickFormatter(months=["%Y-%m-%d"])
p.xaxis.major_label_orientation = pi/4
grid.append([p])
p = gridplot(grid, toolbar_location=None)
show(p)

1

이제 코스피 종가 데이터를 불러옵니다. 위 구글 트렌드 데이터와 같은 y축으로 그리기 위해서 종가 값을 0~100 사이로 조정하여 pos 컬럼에 추가했습니다.

df_kospi = pd.read_csv('./kospi_2018_2021.csv', converters={'date': str})
df_kospi['date'] = pd.to_datetime(df_kospi['date'], format="%Y%m%d")
df_kospi['pos'] = ((df_kospi['close'] - df_kospi['close'].min()) / (df_kospi['close'].max() - df_kospi['close'].min())) * 100
df_kospi
indexdateclosepos
02018-01-022479.64990255.316438
12018-01-032486.35009855.679087
22018-01-042466.45996154.602531
32018-01-052497.52002056.283661
42018-01-082513.28002957.136674
…………
9812021-12-243012.42993284.153237
9822021-12-272999.55004983.456111
9832021-12-283020.23999084.575958
9842021-12-292993.29003983.117288
9852021-12-302977.64990282.270763

이제 코스피 종가 데이터도 차트에 추가로 그려봅니다.

from math import pi
from bokeh.plotting import figure, show
from bokeh.models import DatetimeTickFormatter
from bokeh.models import Legend
grid = []
p = figure(title='Google Trend (kospi) and KOSPI Position', plot_width=800, plot_height=200, tools="crosshair")
a1 = p.line(df['date'], df['interest'], line_color='black')
a2 = p.line(df_kospi['date'], df_kospi['pos'], line_color='red')
p.xaxis.formatter = DatetimeTickFormatter(months=["%Y-%m-%d"])
p.xaxis.major_label_orientation = pi/4
legend = Legend(items=[
('G. Trend', [a1]),
('KOSPI Pos.', [a2]),
], location="center")
p.add_layout(legend, 'right')
grid.append([p])
p = gridplot(grid, toolbar_location=None)
show(p)

2

눈으로 보기에는 “kospi” 검색어가 급증할 때 코스피 지수가 폭락한 경우가 많았음이 보입니다. 공포 심리에 의해 뉴스 등을 찾아보기 위해 검색이 급증하고 실제로 코스피 지수도 요동치는 경우가 있습니다. 물론 상관성은 높지 않아 보이지만 검색 급증이 있으면 하나의 작은 위험 신호로 고려하는 것도 나쁘지 않을 것입니다. 조심해서 나쁠 것은 없습니다.

다음과 같이 상관 계수를 뽑아 보면 그렇게 상관성은 높게 나오지 않습니다. 시계열 전체에서의 상관성 보다는 검색 급증 시그널 정도만 잘 포착하는 것이 의미있어 보입니다.

from scipy.stats import pearsonr
_df = df.merge(df_kospi, how='outer', on='date').sort_values(by='date')
_df = _df.ffill()
_df = _df.bfill()
pearsonr(_df['pos'], _df['interest'])
(0.14169129281665557, 8.844934622779502e-07)

원자재 지수와 주가의 상관관계 분석

이번 포스트에서는 대표적인 원자재 지수인 S&P GSCI와 주식 종목 주가와의 상관관계를 분석해봅니다. 다음 코드 블록은 종목코드 데이터, 원자재 지수 데이터를 불러오는 부분입니다. 데이터는 퀀티랩 네이버 카페의 금융데이터 메뉴에서 공유드립니다.

이번 포스트에서는 대표적인 원자재 지수인 S&P GSCI와 주식 종목 주가와의 상관관계를 분석해봅니다. 다음 코드 블록은 종목코드 데이터, 원자재 지수 데이터를 불러오는 부분입니다. 데이터는 퀀티랩 네이버 카페의 금융데이터 메뉴에서 공유드립니다.

# 종목코드 데이터 준비
import json
with open('../../../data/stockcodes_20220128.json', encoding='utf-8') as f:
stockcodes = json.load(f)
stockcodes

[[‘082740’, ‘HSD엔진’], [‘001390’, ‘KG케미칼’], [‘011070’, ‘LG이노텍’], [‘002360’, ‘SH에너지화학’], [‘001740’, ‘SK네트웍스’], [‘071970’, ‘STX중공업’], [‘024070’, ‘WISCOM’], [‘011420’, ‘갤럭시아에스엠’], [‘267290’, ‘경동도시가스’], [‘002240’, ‘고려제강’], [‘001290’, ‘상상인증권’], [‘014530’, ‘극동유화’], [‘214330’, ‘금호에이치티’], [‘013700’, ‘까뮤이앤씨’], [‘090350’, ‘노루페인트’], [‘005250’, ‘녹십자홀딩스’], [‘004440’, ‘삼일씨엔에스’], [‘014160’, ‘대영포장’], [‘003090’, ‘대웅’], [‘003220’, ‘대원제약’], [‘002880’, ‘대유에이텍’], [‘001620’, ‘케이비아이동국실업’], [‘023450’, ‘동남합성’], [‘004140’, ‘동방’], [‘000640’, ‘동아쏘시오홀딩스’], [‘225330’, ‘씨엠에스에듀’], [‘101240’, ‘씨큐브’], [‘047920’, ‘HLB제약’], [‘013990’, ‘아가방컴퍼니’], [‘052710’, ‘아모텍’], …]

# 원자재 데이터 준비
import pandas as pd
df_gsci = pd.read_csv('../../../data/gsci_20220128.csv', converters={'date': str})
df_gsci
dateclosediffdiffratiohighlowopenvolume
20150102414.9583-3.177835-0.0076421.5643412.5496418.12250
20150105404.6091-10.332034-0.0249414.9583403.7641414.95830
20150106397.9523-6.676373-0.0165406.4719396.1576404.60910
20150107396.6795-1.273449-0.0032400.6534392.2534397.95230
20150108397.10100.4363310.0011399.5170393.1882397.22570
……………………
20220121608.8819-2.568090-0.0042611.4234599.3347611.42340
20220124601.5777-7.306612-0.0120612.6561595.1512608.88190
20220125611.03789.4450070.0157611.3097601.1267601.57770
20220126619.54848.4936610.0139621.5063608.4988611.03780
20220127616.7431-2.787889-0.0045623.2471613.9215619.54840

다음은 종목 일봉 차트와 원자재 지수의 상관관계를 구합니다. 여기서 사용한 상관분석 방법은 피어슨 상관분석 입니다. 피어슨은 상관계수가 -1에서 1 사이의 값으로, 1에 가까울수록 정관계, -1에 가까울수록 역관계임을 의미합니다.

# 종목 데이터 준비
# 종목과 원자재 상관관계 저장
from scipy.stats import pearsonr
from tqdm import tqdm
df_corr = pd.DataFrame()
for code, name in tqdm(stockcodes):
data = {'code': code, 'name': name}
df_stockcandles_day = pd.read_csv(
f'../../../data/stockcandles_day_20220128/stockcandles_day_{code}_{name}_20220128.csv',
converters={'date': str}
)
start_date = df_stockcandles_day.iloc[0]['date']
end_date = df_stockcandles_day.iloc[-1]['date']
_df_gsci = df_gsci[(df_gsci['date'] >= start_date) & (df_gsci['date'] <= end_date)]
_df = pd.merge(df_stockcandles_day, _df_gsci, how='left', on='date', suffixes=['_stock', '_commodity'])
_df = _df.dropna()
if len(_df) < 20:
continue
corr, p = pearsonr(_df['close_stock'], _df['close_commodity'])
if p <= 0.05:
data['gsci'] = corr
else:
data['gsci'] = 0
df_corr = df_corr.append(data, ignore_index=True)
columns = df_corr.columns.tolist()
columns.remove('code')
columns.remove('name')
columns = ['code', 'name'] + columns
df_corr = df_corr[columns]
df_corr
codenamegsci
082740HSD엔진0.697773
001390KG케미칼0.771450
011070LG이노텍0.650439
002360SH에너지화학-0.084560
001740SK네트웍스-0.138996
………
298870케이티비네트워크-0.954783
400840하이제7호스팩0.000000
397880교보11호스팩0.000000
396770엔에이치스팩22호-0.438219
400560하나금융20호스팩0.000000

이렇게 종목 일봉 차트와 GSCI의 상관계수를 구하고 다음과 같이 후처리합니다.

# NaN 제거
df_corr2 = df_corr.dropna().copy()
# 데이터 저장
df_corr2.to_csv('data/corr.csv', index=False)
# 데이터 불러오기
str_columns = ['code', 'name']
df_corr2 = pd.read_csv('data/corr.csv', converters={k: lambda x: str(x) for k in str_columns})

먼저 NaN을 제거하고 데이터를 저장합니다. 이 데이터도 퀀티랩 네이버 카페에 올려 놓겠습니다.

다음과 같이 스팩과 리츠 종목은 제거하고 상관관계가 높은 종목을 확인합니다.

# 스팩, 리츠 제외
df_corr3 = df_corr2[~(df_corr2['name'].str.endswith('스팩') | df_corr2['name'].str.endswith('리츠'))]

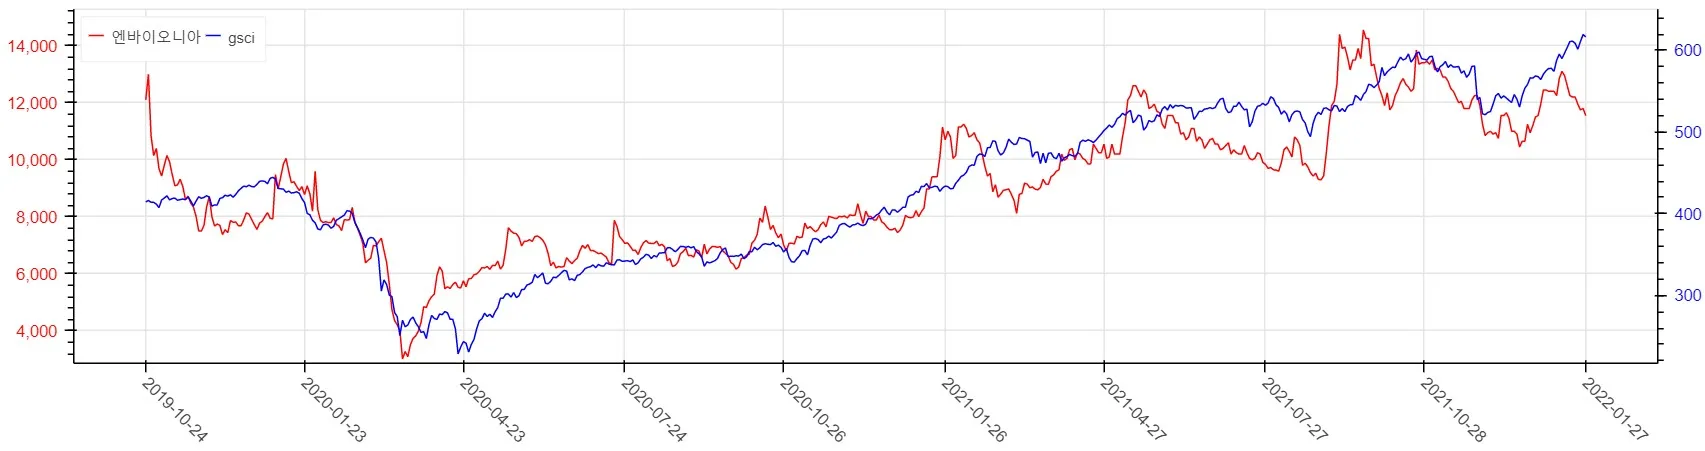
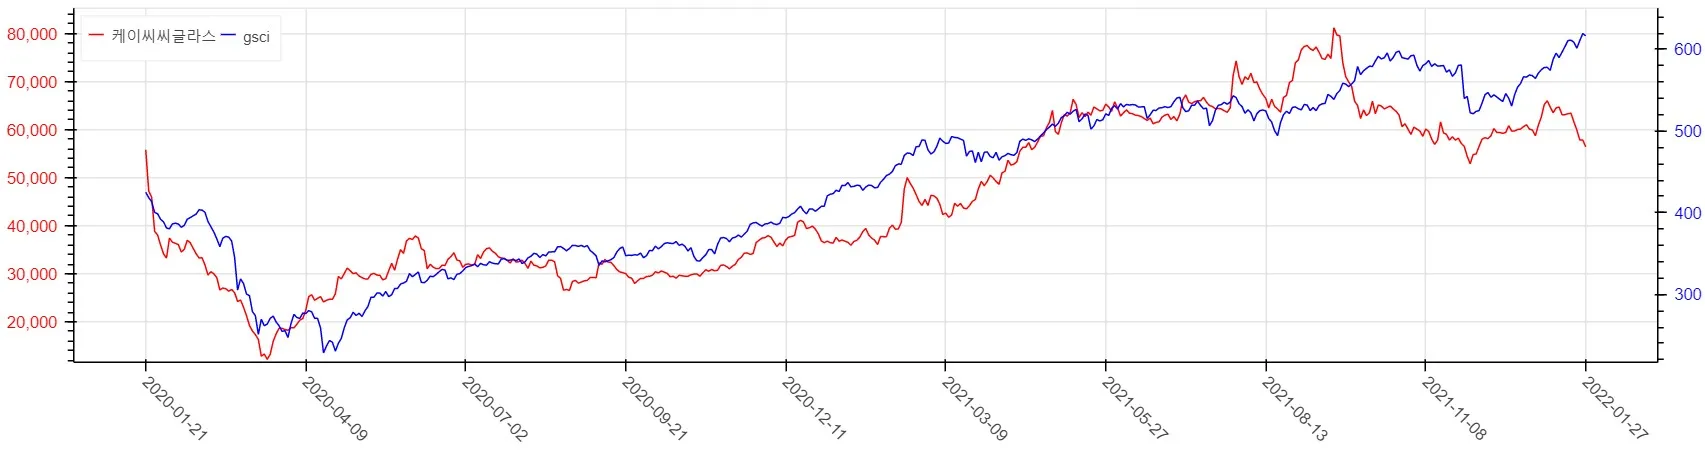
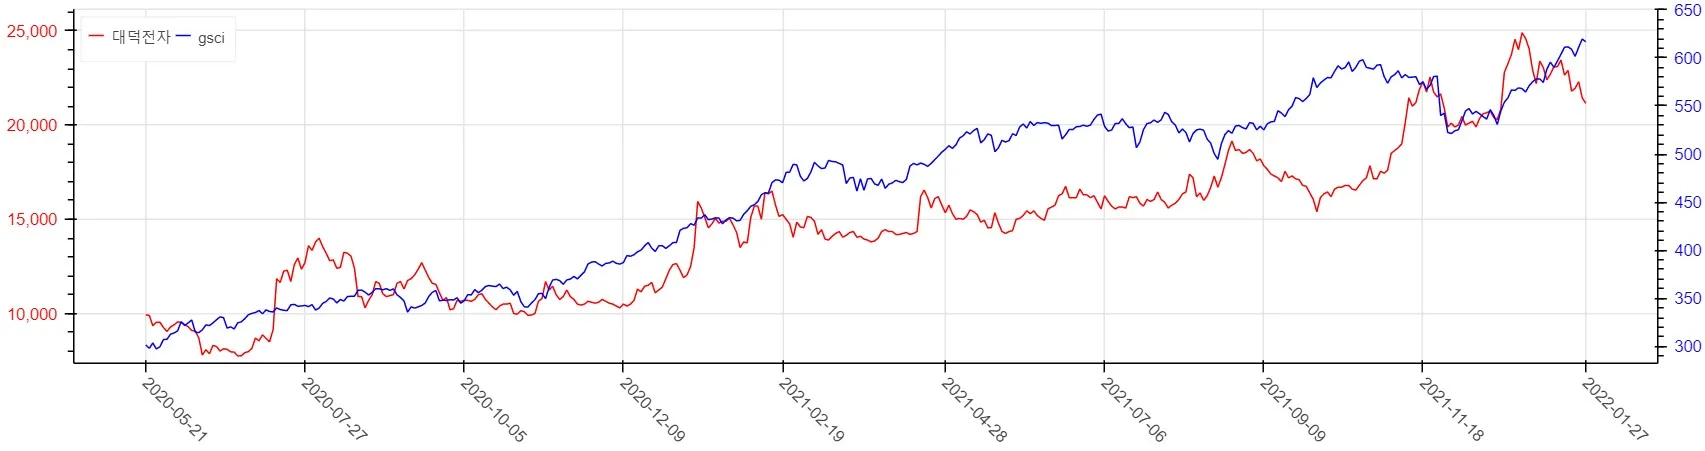
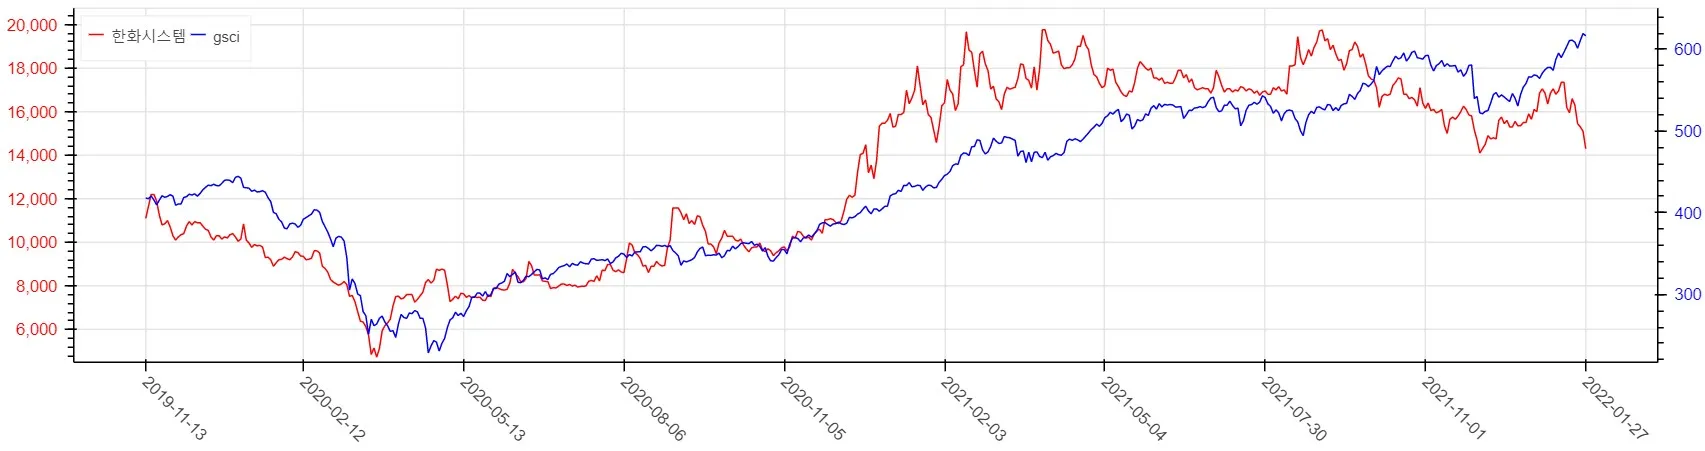
먼저 정관계로 상관관계가 높은 종목을 랭킹하여 가시화합니다.

# 상관관계 높은 종목 가시화
from quantylab.common import viz
for idx, row in df_corr3.sort_values(by='gsci', ascending=False).head(n=5).iterrows():
df_stockcandles_day = pd.read_csv(
'../../../data/stockcandles_day_20220128/stockcandles_day_{}_{}_20220128.csv'.format(row['code'], row['name']),
converters={'date': str}
)
start_date = df_stockcandles_day.iloc[0]['date']
end_date = df_stockcandles_day.iloc[-1]['date']
_df_gsci = df_gsci[(df_gsci['date'] >= start_date) & (df_gsci['date'] <= end_date)]
_df = pd.merge(df_stockcandles_day, _df_gsci, how='left', on='date', suffixes=['_stock', '_commodity'])
_df = _df.dropna().copy().reset_index(drop=True)
print('{} {} {}'.format(row['name'], row['max_commodity'], row['max_corr']))
viz.show_notebook(viz.get_multchart(_df['date'], _df['close_stock'], _df['close_commodity'], label1=row['name'], label2=row['max_commodity']))

1 2 3 4 5

주로 소형 제조업 위주로 랭킹되는 것을 볼 수 있습니다.

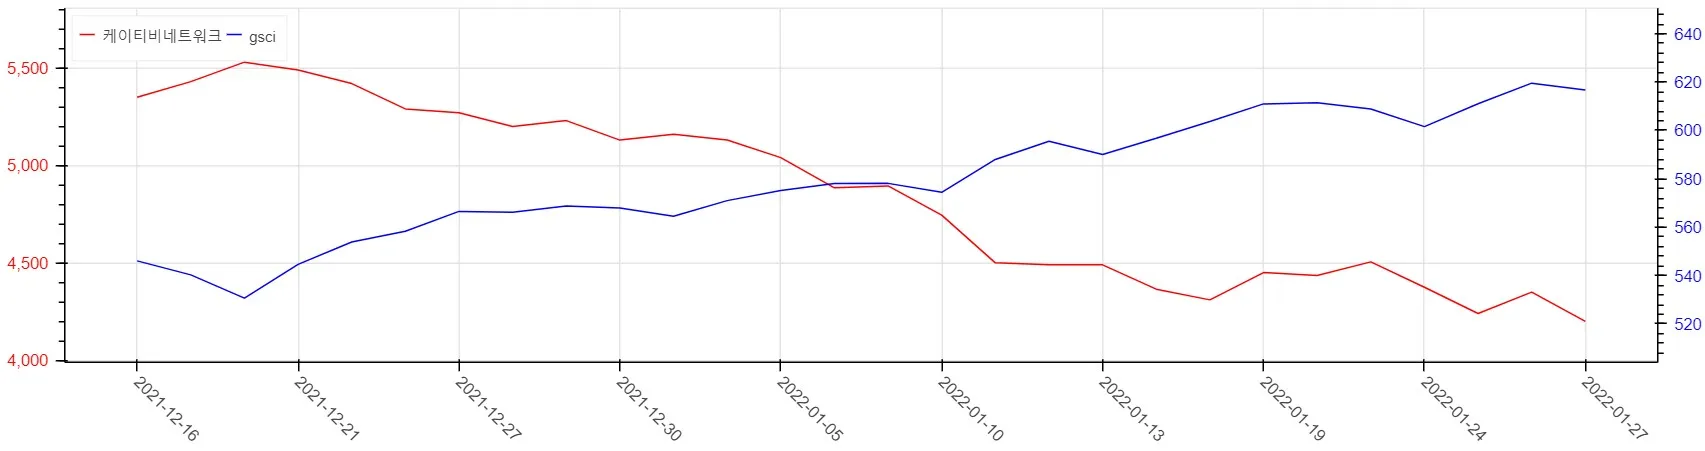
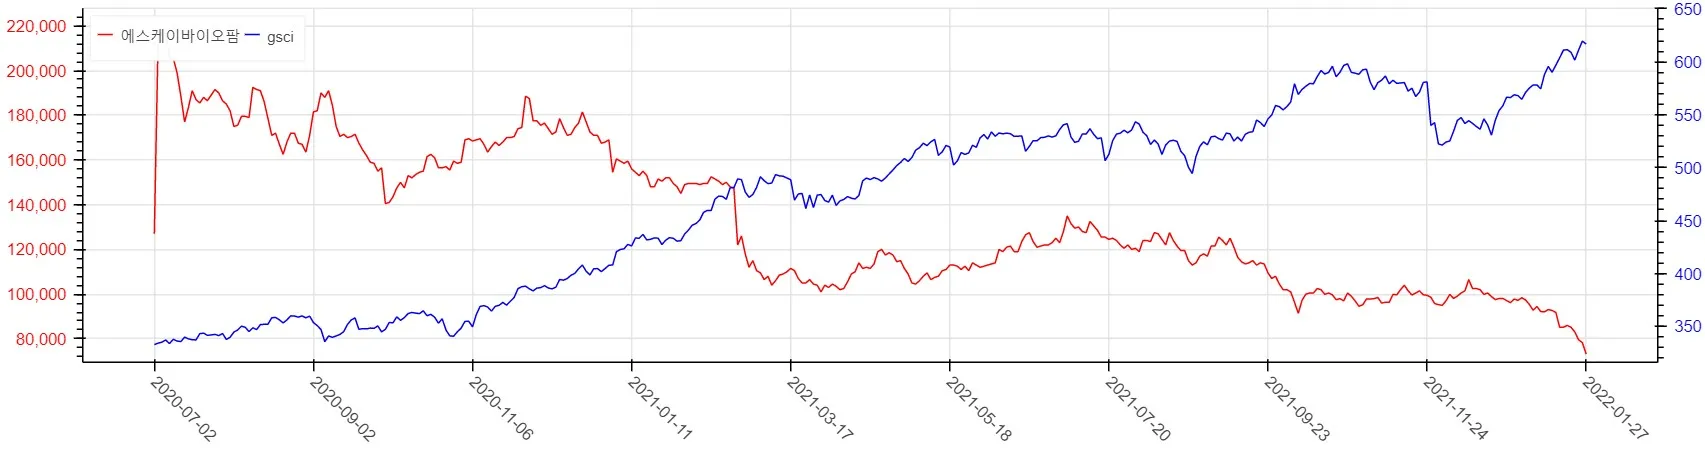
다음으로 역관계로 상관관계가 높은 종목을 랭킹하여 가시화합니다.

# 역 상관관계 높은 종목 가시화
from quantylab.common import viz
for idx, row in df_corr3.sort_values(by='gsci', ascending=True).head(n=5).iterrows():
df_stockcandles_day = pd.read_csv(
'../../../data/stockcandles_day_20220128/stockcandles_day_{}_{}_20220128.csv'.format(row['code'], row['name']),
converters={'date': str}
)
start_date = df_stockcandles_day.iloc[0]['date']
end_date = df_stockcandles_day.iloc[-1]['date']
_df_gsci = df_gsci[(df_gsci['date'] >= start_date) & (df_gsci['date'] <= end_date)]
_df = pd.merge(df_stockcandles_day, _df_gsci, how='left', on='date', suffixes=['_stock', '_commodity'])
_df = _df.dropna().copy().reset_index(drop=True)
print('{} {} {}'.format(row['name'], row['max_commodity'], row['max_corr']))
viz.show_notebook(viz.get_multchart(_df['date'], _df['close_stock'], _df['close_commodity'], label1=row['name'], label2=row['max_commodity']))

6 7 8 9 10

주로 연구 위주의 중소형주가 상위랭킹되는 것을 볼 수 있습니다.

데이터 받아가셔서 다양하게 분석해 보시기 바랍니다.

공매도 데이터 분석하기

이번 포스트에서는 파이썬으로 공매도 데이터를 분석해 봅니다. 공매도 데이터 수집에 대해서는 이 포스트를 확인해 주세요.

공매도 거래, 공매도 잔고, 종목 정보 데이터를 가져옵니다. 이 부분은 개인적으로 사용하는 데이터베이스를 활용하므로 퀀티랩 카페에서 CSV 파일을 다운받아 사용하시기 바랍니다.

import pandas as pd
from quantylab.common.db.mongodb import MongoDBClient
coll = MongoDBClient.get_coll('short')
cursor = coll.find({'date': {'$gte': '20210601', '$lte': '20220114'}}, {'_id': 0, 'dt_update': 0, 'date_update': 0}, sort=[('date', -1)])
df_short = pd.DataFrame(list(cursor))
coll = MongoDBClient.get_coll('shortbalance')
cursor = coll.find({'date': {'$gte': '20210601', '$lte': '20220114'}}, {'_id': 0, 'dt_update': 0, 'date_update': 0}, sort=[('date', -1)])
df_shortbalance = pd.DataFrame(list(cursor))
coll = MongoDBClient.get_coll('stockcodes')
cursor = coll.find({}, {'_id': 0, 'code': 1, 'name': 1})
df_stockcodes = pd.DataFrame(list(cursor))

위에서 준비한 세 DataFrame을 합칩니다. 이 합친 데이터를 CSV 파일로 저장해 둡니다. 이 CSV 데이터를 카페에 올려 놓았습니다. 카페 가입하셔서 다운받으시고 질문도 해주시면 감사하겠습니다.

df = pd.merge(df_short, df_shortbalance[['code', 'date', 'bal_rto', 'bal_amt', 'bal_qty']], on=['code', 'date'], how='left')
df = pd.merge(df, df_stockcodes, on='code', how='left')
df = df[['name'] + df.columns.tolisZt()[:-1]]
df.to_csv('20220113_analysis_short.csv', index=False)

CSV 파일을 다운받으셨다면 다음 부분부터 직접 해보실 수 있습니다. 다음 코드는 CSV 파일을 불러오는 부분입니다.

import pandas as pd
str_columns = ['code', 'date']
df = pd.read_csv('20220113_analysis_short.csv', converters={k: lambda x: str(x) for k in str_columns})

code, date를 숫자로 읽는 것을 방지하기 위해서 converters 인자를 넣어줍니다. 그리고 다음 코드에서처럼 date로 정렬하고 % 단위를 떼고 NaN 값이 포함된 행을 버립니다.

df = df.sort_values(by='date')
# % 단위 떼기
df['short_ratio'] /= 100
df['bal_rto'] /= 100
df = df.dropna().copy()
namecodedateavg_priceavg_price_ratioclosediffdiffratioshort_amountshort_ratioshort_volumevolumebal_rtobal_amtbal_qty
LX홀딩스3838002021060111078-7811000500.46262140.0125910000000000012366218792880.034639000.03149.0
DB금융투자01661020210601721557220500.74120.0031695711801730.00.00.0
CJ제일제당097950202106014843271173485500-3000-0.611225350.04372530578950.002921517360000.044320.0
CJ씨푸드011150202106014819148201052.23223.8e-054511881320.00831435482760.0297818.0
BGF리테일28233020210601183995518400025001.38649500.0898383530392930.00070000000000000012272032000.012348.0
………………………………………
엠씨넥스0975202022011456312-125630038007.241411.9e-052513217200.00292909752900.051683.0
더블유게임즈192080202201145396623454200-400-0.73478510.104212000000000018867850860.013913883763600.0256158.0
PI첨단소재17892020220114527343665310010001.92345560.04419500000000000565531482750.008613446300600.0253226.0
포스코케미칼00367020220114129380620130000-2000-1.52940330.04343672681673250.0235236509260000.01819302.0
LG이노텍011070202201143810223478384500320009.0835523490.053839323217319870.00560000000000000150517917000.0131386.0

이 데이터에서 종목별로 상환 규모를 확인하고 공매도 거래량, 공매도 잔고, 상환 규모의 5일 이동평균을 구합니다. 이 과정은 몇 분 정도 걸릴 수 있습니다. 그래서 tqdm으로 진행율을 확인합니다.

from tqdm import tqdm
for k, g in tqdm(df.groupby('code')):
# 상환 규모 확인
# 당일 short_volume - (당일 bal_qty - 전일 bal_qty)
df.loc[df['code'] == k, 'bal_qty_diff'] = g['bal_qty'].diff()
df.loc[df['code'] == k, 'repay_volume'] = (df.loc[df['code'] == k, 'short_volume'] - df.loc[df['code'] == k, 'bal_qty_diff']).clip(0)
df.loc[df['code'] == k, 'repay_ratio'] = df.loc[df['code'] == k, 'repay_volume'] / df.loc[df['code'] == k, 'volume']
# 이동평균
df.loc[df['code'] == k, 'short_ratio_ma5'] = g['short_ratio'].fillna(0).rolling(5).mean()
df.loc[df['code'] == k, 'bal_rto_ma5'] = g['bal_rto'].fillna(0).rolling(5).mean()
df.loc[df['code'] == k, 'repay_ratio_ma5'] = df.loc[df['code'] == k, 'repay_ratio'] .fillna(0).rolling(5).mean()

이렇게 구한 repay_ratio_ma5로 내림차순 정렬을 해보면 다음과 같은 결과를 얻을 수 있습니다.

_df = df[df['date'] == '20220114'].sort_values(by='repay_ratio_ma5', ascending=False)
_df
namecodedateavg_priceavg_price_ratioclosediffdiffratioshort_amountshort_ratioshort_volumevolumebal_rtobal_amtbal_qtybal_qty_diffrepay_volumerepay_ratioshort_ratio_ma5bal_rto_ma5repay_ratio_ma5
BGF리테일28233020220114145501-1501144000-2000-1.371887430.3144512972412530.00133342384000.023211.04353.08619.00.208930259617482380.242506399999999980.00130000000000000020.2374309360178176
세방전지0044902022011469346-14669200-1800-2.54223220.0946353219340150.019118506225200.0267431.0-6377.09596.00.28211083345582830.10481040.020260.22422523200232863
호텔신라00877020220114773049677400-1100-1.45945430.222531769103456150.0717217719311400.02812911.083286.00.00.00.2711130.069780000000000010.2142213088295697
금호석유화학01178020220114174115-11517400025001.462938540.075005168772250110.05263459838000.01514137.0-44184.061061.00.27136895529551890.07733960.05190.20765174156183894
효성첨단소재29805020220114532588412533000-8000-1.483140670.1590775897370700.014735143888000.065936.015093.00.00.00.15405920.013160.18448044554531187
………………………………………………………
콤텍시스템031820202201149570957-16-1.6419e-0689371840.0011123620475.0129175.00.08.08.536210605388056e-064.259999999999999e-050.00109999999999999984.258825517099485e-05
TCC스틸00271020220114129500129508006.5830.0250848320.00.00.00.02.03.933266625131371e-073.48e-050.03.473958840739652e-05
미래산업025560202201141365010013750-350-2.4812.5e-051397060.00.00.00.01.02.518511056263537e-052.46e-050.02.4705969543888606e-05
이스타코01502020220114310503105-110-3.4215.999999999999999e-0647216860.00.00.00.04.05.542576688476706e-062.3000000000000024e-050.02.2816870909533658e-05
오리엔트바이오00263020220114131551320201.5400.0124794550.0013198262680.0150199.00.01.04.033144380519106e-075.200000000000005e-060.00135.125393445035716e-06

이 종목들 중에서 공매도 상환율이 높은 상위 5개 종목을 살펴보겠습니다.

1

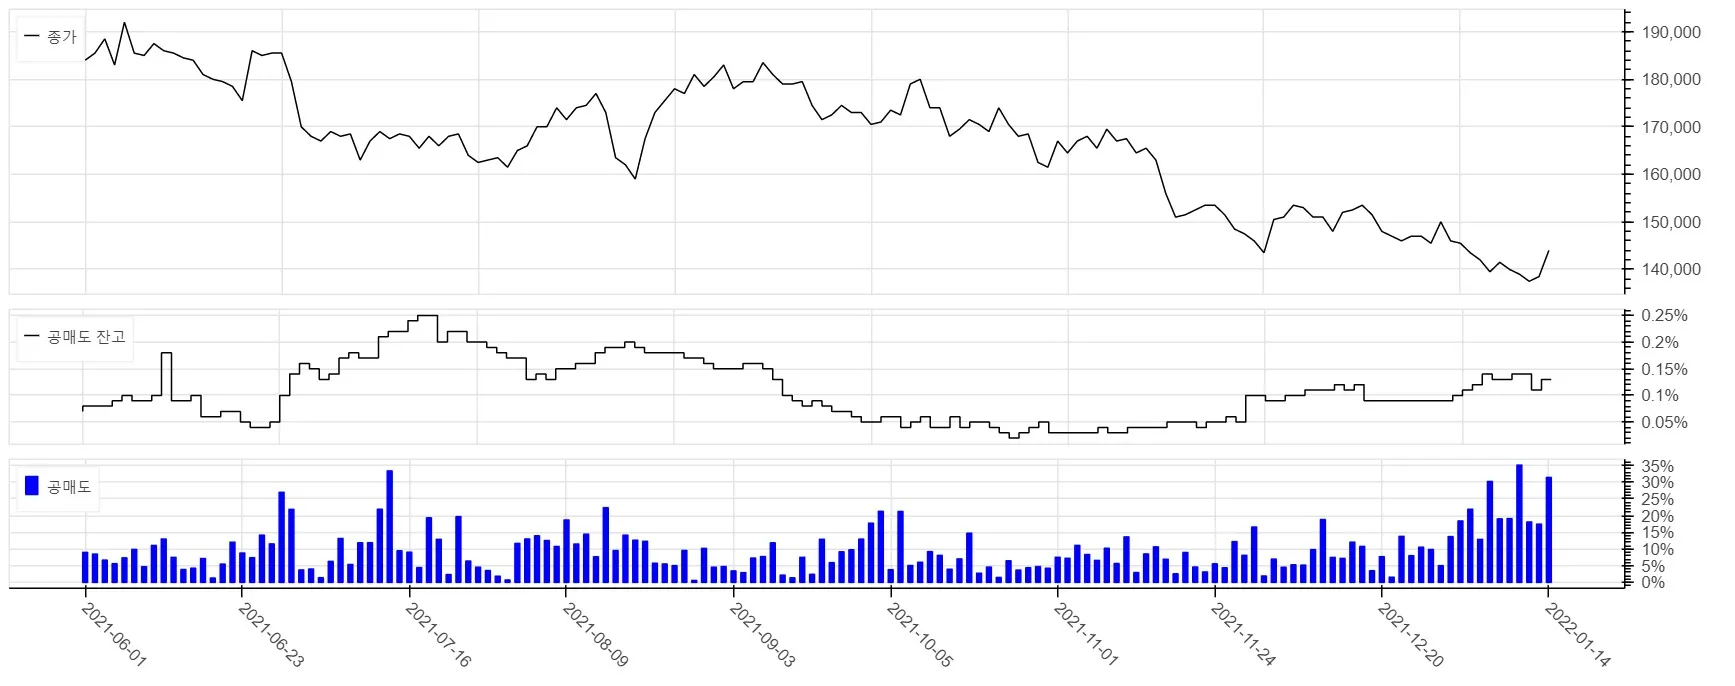
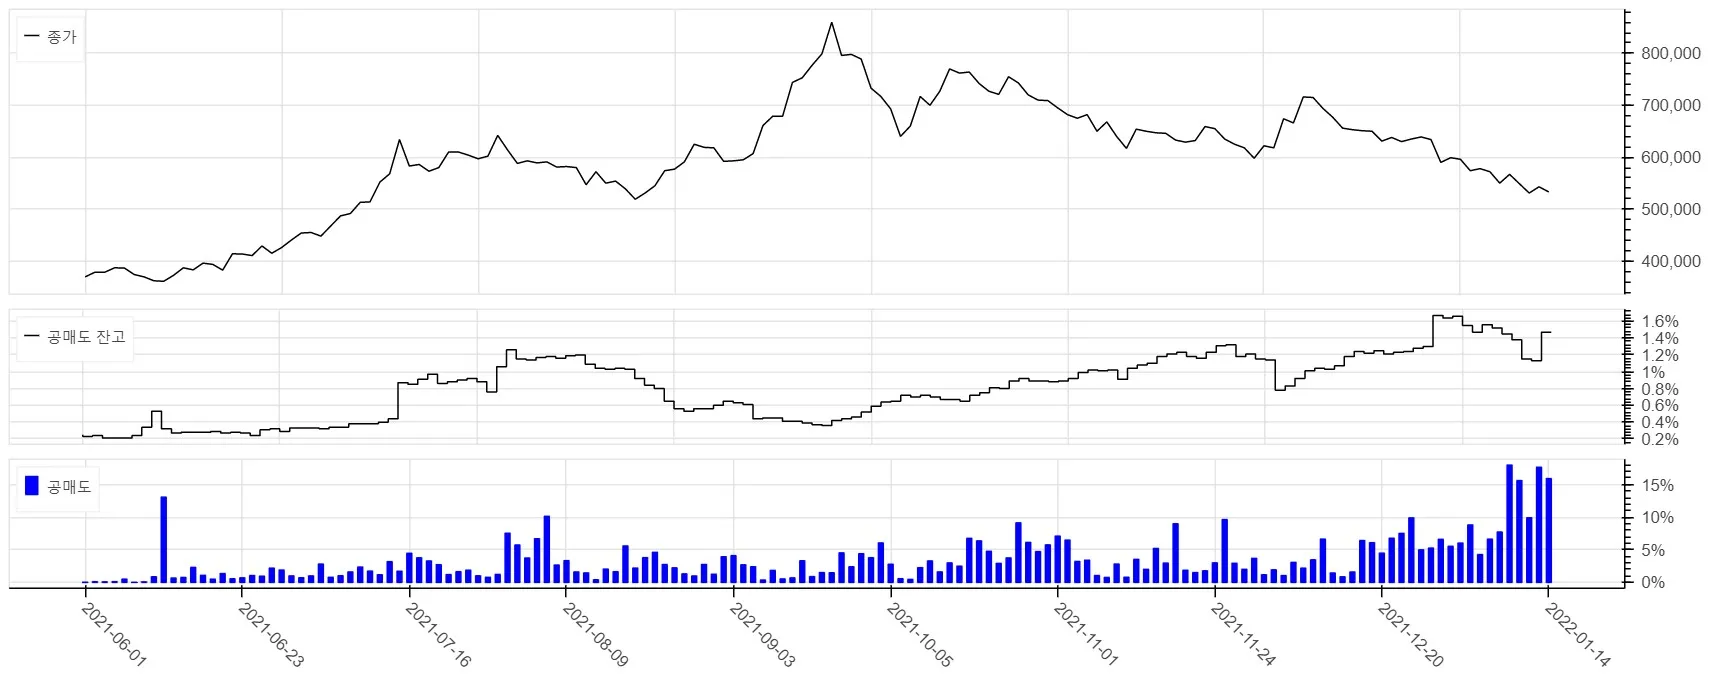
최근 공매도 거래가 높은데 공매도 잔고는 크게 늘지 않고 유지되고 있습니다. 즉, 공매도 상환율도 높은 상황입니다. 공매도자들의 판단이 엇갈리고 있다고 보이는 지점입니다.

2

공매도 거래는 꾸준히 있는데 공매도 잔고가 떨어지고 있습니다.

3

11월에 어닝쇼크로 공매도 잔고가 급격하게 늘었습니다. 이후 공매도 거래는 많은데 공매도 잔고는 조금씩 오르는 모습입니다.

4

공매도 잔고가 꾸준히 늘다가 최근 하락 전환하는 모습입니다.

5

최근 공매도 거래가 상당한 상황입니다.

[2021-08-13] 공매도 상위 종목 살펴보기

공매도는 주식을 빌려서 파는 행위를 말합니다. 주가가 하락한다는 쪽에 베팅하는 것입니다. 이러한 베팅을 숏(Short) 포지션 취한다고 합니다. 주가가 하락할 것이라고 예상하고 주식을 빌려서 현재 가격에 매도하고 주가가 떨어졌을 때 다시 매수해서 빌린 주식을 갚는 것입니다.

공매도는 2020년 3월에 주가 급락을 막기 위해 금지됐었습니다. 그렇게 1년 2개월간 금지된 공매도가 2021년 5월에 재개됐습니다. 공매도는 개인투자자들이 하기 어렵고 그만큼 개인투자자들의 공매도에 대한 부정적인 인식이 강합니다.

공매도가 많다고 해서 주가가 꼭 하락한다는 보장은 없지만 공매도의 현황을 파악해 놓는 것은 중요하다고 생각합니다. 공매도의 추세가 증가하면 가급적 매수를 자제하는 것이 좋다고 생각합니다. 다만 공매도가 많다가 줄어드는 추세이고 대차잔고가 많은 상태면 주가가 바닥권이라는 예측을 해볼 수도 있습니다. 대차잔고는 주식을 빌리고 아직 갚지 않은 주식 수를 의미합니다. 즉, 대차잔고만큼 앞으로 매수가 이뤄질 것이란 의미입니다.

퀀티랩 종목지표/공매도 메뉴에서 종목별 공매도 현황을 표로 확인할 수 있습니다.

이 포스트에서는 2021-08-13 기준으로 공매도율, 대차잔고율, 대차잔고액 순위를 살펴보겠습니다.

종목명주가등락율(%)공매도액(만원)공매도율(%)대차잔고액(만원)대차잔고율(%)
티씨케이173,400-1.64137,55625.57  
넷마블127,000-3.791,398,73025.519,808,5330.85
하림지주9,580-1.5465,51022.83  
SK머티리얼즈432,000-1.5508,95921.26  
휴온스61,400-1.7676,52719.85  
금호석유화학192,500-2.531,408,19318.8814,948,0292.48
엔씨소프트786,000-2.481,563,72318.77,751,7090.43
리노공업172,4000.17151,01818.69  
CJ대한통운165,500-2.07189,09718.43845,5910.22
GS리테일33,200-1.92443,43218.12711,7630.2
고영23,450-2.0984,65917.43  
주성엔지니어링13,050-1.14326,58817.19  
SK텔레콤306,000-2.081,344,42217.128,681,7190.4
동국제약24,700-1.7971,29817.11  
팬오션7,410-4.391,044,21716.944,016,5251.03
하나투어75,600-2.45265,63316.831,204,7801.09
S-Oil93,800-1.37360,71916.512,908,9250.28
제일기획23,200-0.22108,40615.71429,8280.16
이오테크닉스112,700-3.1153,84315.5  
한화솔루션38,700-2.27564,86715.4112,955,9341.7
종목명주가등락율(%)공매도액(만원)공매도율(%)대차잔고액(만원)대차잔고율(%)
롯데관광개발18,900-2.0756,8846.669,874,8717.25
LG디스플레이20,800-3.48971,07811.9750,027,6426.31
신풍제약66,800-6.96867,6693.5914,668,3194.31
HMM39,150-3.69100,3460.4564,919,6674.13
엠씨넥스45,500-1.62270.003,234,9843.81
삼성중공업6,170-2.68179,1775.7315,810,5893.73
OCI107,000-3.60178,2872.698,522,1113.18
셀트리온275,500-2.13960,1994.45112,924,1253.03
부광약품20,400-2.8665,7163.804,234,1882.84
일양약품34,150-1.7331,3177.041,721,0902.58
호텔신라90,000-2.39313,5536.939,290,9012.57
금호석유화학192,500-2.531,408,19318.8814,948,0292.48
두산퓨얼셀48,400-2.2238,5711.538,021,7492.43
한전기술48,150-3.8942,4562.393,857,6091.99
GKL15,700-1.2643,6218.021,931,8801.93
삼양식품87,800-0.7919,8586.281,279,7201.90
인스코비4,32514.578800.01686,1711.79
씨에스윈드80,100-2.44300,5558.815,912,2981.77
CJ CGV28,750-2.8746,4652.571,942,7591.72
한화솔루션38,700-2.27564,86715.4112,955,9341.70
종목명주가등락율(%)공매도액(만원)공매도율(%)대차잔고액(만원)대차잔고율(%)
셀트리온275,500-2.13960,1994.45112,924,1253.03
HMM39,150-3.69100,3460.4564,919,6674.13
LG디스플레이20,800-3.48971,07811.9750,027,6426.31
현대자동차217,000-0.91654,3723.5132,678,4790.70
삼성바이오로직스983,0001.13683,4054.8120,547,0590.33
아모레퍼시픽220,500-1.78388,53610.8317,527,9871.32
삼성중공업6,170-2.68179,1775.7315,810,5893.73
금호석유화학192,500-2.531,408,19318.8814,948,0292.48
LG생활건강1,444,0001.62498,0127.0614,773,6560.66
신풍제약66,800-6.96867,6693.5914,668,3194.31
SK이노베이션248,5002.691,440,1985.3214,506,4950.65
LG화학896,0002.051,345,0333.7914,318,3710.24
한화솔루션38,700-2.27564,86715.4112,955,9341.70
카카오146,000-1.022,591,3428.2912,739,6100.20
포스코케미칼155,0001.311,070,66114.5512,592,2281.05
한국조선해양119,000-0.8393,6402.2510,713,9721.22
롯데관광개발18,900-2.0756,8846.669,874,8717.25
두산중공업20,800-4.15215,1781.679,809,8390.89
넷마블127,000-3.791,398,73025.519,808,5330.85
삼성전자74,400-3.3813,590,0493.009,771,2790.02

여기서 대차잔고액은 높은데 공매도율은 낮은 종목으로는 HMM이 있습니다. HMM의 공매도 흐름을 살펴보면 다음과 같습니다.

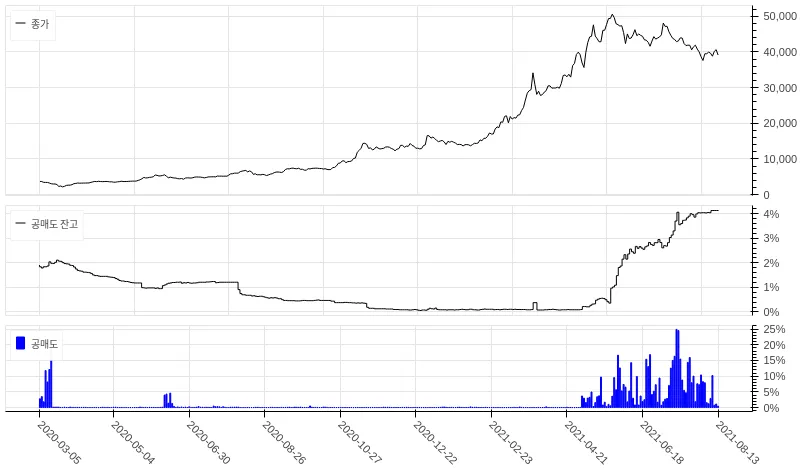
HMM 공매도

7월달을 보면 공매도율이 무려 25% 가까이 있었다는 것을 알 수 있습니다. 이 공매도 물량을 언제 상환할 지는 모르겠지만 최근 공매도율은 낮아진 것으로 보입니다.

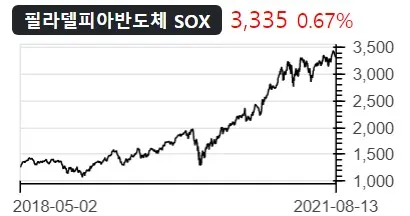
여기에 BDI 역시 높은 상황이라 HMM이 다시 올라갈 여지도 있어 보입니다.

BDI