
이번 글에서는 파이썬을 사용하여 IMF(국제통화기금)에서 WEO(World Economic Outlook) 데이터베이스를 통해 세계 경제 데이터를 수집하고 GDP(국내총생산) 데이터를 조회하고 시각화하는 방법을 소개합니다.
WEO 데이터베이스에는 각국의 GDP, 인플레이션, 실업률 등 다양한 경제 지표가 포함되어 있습니다. 여기서는 GDP 데이터를 중심으로 다룹니다.
다음 내용을 다룹니다:
- WEO 데이터를 SDMX 3.0 API를 통해 수집하는 방법
- GDP 데이터 조회 및 시각화 방법
필요한 라이브러리 설치
섹션 제목: “필요한 라이브러리 설치”먼저 필요한 파이썬 라이브러리를 설치합니다. pandas, requests, matplotlib 라이브러리가 필요합니다.
pip install pandas requests matplotlibWEO 데이터 수집
섹션 제목: “WEO 데이터 수집”IMF의 WEO 데이터는 SDMX 3.0 API를 통해 접근할 수 있습니다. 다음은 파이썬을 사용하여 GDP 데이터를 수집하는 예제 코드입니다.
import jsonimport requests
def get_weo_data():    # Dataset    # - Dataset name: World Economic Outlook (WEO)    # - ID: WEO    # - Agency: IMF.RES    # - Version: 9.0.0    "IMF.RES,WEO"
    # Data Query    # https://api.imf.org/external/sdmx/3.0/data/{context}/{agencyID}/{resourceID}/{version}/{key}[?c][&updatedAfter][&firstNObservations][&lastNObservations][&dimensionAtObservation][&attributes][&measures][&includeHistory][&asOf]    url = "https://api.imf.org/external/sdmx/3.0/data/dataflow/IMF.RES/WEO/9.0.0/*"
    res = requests.get(url)    data = json.loads(res.text)
    return data
get_weo_data 함수를 호출하여 WEO 데이터를 수집할 수 있습니다.
import json
with open("weo_data.json", "w") as fout:    data = get_weo_data()    json.dump(data, fout)
수집한 데이터는 SDMX 3.0 형식으로 제공되서 파싱이 필요합니다.
GDP 데이터 조회 및 시각화
섹션 제목: “GDP 데이터 조회 및 시각화”데이터를 살펴보면 dataSets 키 아래에 여러 국가와 지표가 포함되어 있습니다. 그런데 키 값이 복잡하므로, 이를 해석하기 위해서는 structures 키 아래의 정보를 참고해야 합니다.
다음은 데이터를 파싱하여 판다스 데이터프레임으로 변환하는 예제 코드입니다.
output = []
for data_set in data_sets:    structure = structures[data_set["structure"]]    series_dims = structure["dimensions"]["series"]    obs_dims = structure["dimensions"]["observation"]
    for series_key, series_content in data_set["series"].items():        # series dimensions 파싱        dim_indices = series_key.split(":")        series_info = {}
        for i, dim_index in enumerate(dim_indices):            dim_id = series_dims[i]["id"]            dim_value_id = series_dims[i]["values"][int(dim_index)]["id"]            series_info[dim_id] = dim_value_id
        # series attributes 파싱        attributes_info = {}        for attr_value, struct_attr in zip(series_content.get("attributes", []),                                           structure["attributes"]["series"]):            attr_id = struct_attr["id"]
            # coded attribute는 index로 제공 => value id로 변환            if isinstance(attr_value, int):                attr_id_value = struct_attr["values"][attr_value]["id"]            else:                attr_id_value = attr_value  # uncoded string
            attributes_info[attr_id] = attr_id_value
        # observations 처리        if "observations" not in series_content:            continue
        for obs_key, obs_value in series_content["observations"].items():            obs_idx = int(obs_key)            obs_dim_value = obs_dims[0]["values"][obs_idx]["value"]            value = obs_value[0]
            row = {                **series_info,                **attributes_info,                "TIME_PERIOD": obs_dim_value,                "VALUE": value            }            output.append(row)
# pandas DF 생성import pandas as pddf = pd.DataFrame(output)df
.dataframe tbody tr th { vertical-align: top;}
.dataframe thead th { text-align: right;}| COUNTRY | INDICATOR | FREQUENCY | SCALE | DECIMALS_DISPLAYED | OVERLAP | COUNTRY_UPDATE_DATE | TIME_PERIOD | VALUE | |
|---|---|---|---|---|---|---|---|---|---|
| 0 | ABW | BCA | A | 9 | 3 | OL | 9/19/2025 | 1999 | -435000000 |
| 1 | ABW | BCA | A | 9 | 3 | OL | 9/19/2025 | 2000 | 213000000 |
| 2 | ABW | BCA | A | 9 | 3 | OL | 9/19/2025 | 2001 | 310000000 |
| 3 | ABW | BCA | A | 9 | 3 | OL | 9/19/2025 | 2002 | -333000000 |
| 4 | ABW | BCA | A | 9 | 3 | OL | 9/19/2025 | 2003 | -167000000 |
| ... | ... | ... | ... | ... | ... | ... | ... | ... | ... |
| 354235 | ZWE | TXG_RPCH | A | 0 | 3 | OL | 9/5/2025 | 2026 | -0.814 |
| 354236 | ZWE | TXG_RPCH | A | 0 | 3 | OL | 9/5/2025 | 2027 | 4.939 |
| 354237 | ZWE | TXG_RPCH | A | 0 | 3 | OL | 9/5/2025 | 2028 | 4.226 |
| 354238 | ZWE | TXG_RPCH | A | 0 | 3 | OL | 9/5/2025 | 2029 | 3.698 |
| 354239 | ZWE | TXG_RPCH | A | 0 | 3 | OL | 9/5/2025 | 2030 | 3.604 |
354240 rows × 9 columns
위 코드에서는 다음과 같은 작업을 수행합니다:
- data_sets와 structures를 추출하여 각각의 시리즈와 관측치를 파싱합니다.
- series_key를 ”:“로 분리하여 각 차원의 값을 추출합니다.
- series_content의 attributes를 구조체의 attributes와 매핑하여 속성 값을 추출합니다.
- observations를 순회하며 각 관측치의 시간과 값을 추출하여 최종적으로 판다스 데이터프레임으로 변환합니다.
이제 df 데이터프레임에는 각국의 GDP 데이터가 포함되어 있습니다. 이를 활용하여 다양한 분석과 시각화를 수행할 수 있습니다.
특정 데이터를 조회하기 위해서 국가 코드, 지표 코드 등을 알아야 합니다. 예를 들어, 미국은 “USA”, 한국은 “KOR”입니다. 주요 GDP 지표는 다음과 같습니다:
- 실질 GDP (현재 가격): NGDP_R
- 실질 GDP (전년 대비 증감률): NGDP_RPCH
- GDP 갭 (실질 GDP - 잠재 GDP): NGAP_NPGDP
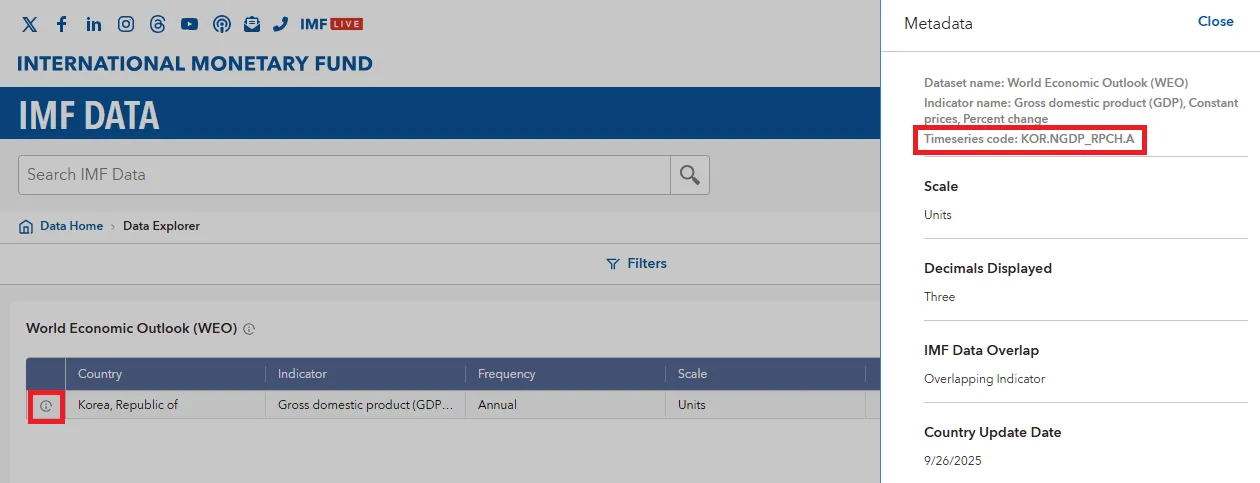
다음 링크에서 각국의 GDP 데이터를 직접 조회할 수도 있습니다: https://data.imf.org/en/Data-Explorer?datasetUrn=IMF.RES:WEO(9.0.0)
조회한 테이블 좌측의 ℹ️ 아이콘을 클릭하면 Timeseries code를 확인할 수 있는데, 여기서 국가 코드와 지표 코드를 알 수 있습니다. 예를 들어, Timeseries code: KOR.NGDP_RPCH.A는 한국(KOR)의 실질 GDP 성장률(NGDP_RPCH)을 의미합니다. A는 연간 데이터를 나타냅니다.
다음은 미국과 한국의 실질 GDP와 실질 GDP 성장률을 시각화하는 예제 코드입니다.
import matplotlib.pyplot as plt
# NGDP_R: 실질 GDP (현재 가격)# NGDP_RPCH: 실질 GDP (전년 대비 증감률)# NGAP_NPGDP: GDP 갭 (실질 GDP - 잠재 GDP)
fig, axes = plt.subplots(nrows=2, ncols=3, figsize=(12, 6))
# 미국us_data = df[(df["COUNTRY"] == "USA") & (df["INDICATOR"] == "NGDP_R")].copy()us_data["VALUE"] = pd.to_numeric(us_data["VALUE"])us_data.plot(x="TIME_PERIOD", y="VALUE", title="US Real GDP Over Time", kind="line", ax=axes[0, 0])us_data = df[(df["COUNTRY"] == "USA") & (df["INDICATOR"] == "NGDP_RPCH")].copy()us_data["VALUE"] = pd.to_numeric(us_data["VALUE"])us_data.plot(x="TIME_PERIOD", y="VALUE", title="US Real GDP Growth Rate Over Time", kind="line", ax=axes[0, 1])us_data = df[(df["COUNTRY"] == "USA") & (df["INDICATOR"] == "NGAP_NPGDP")].copy()us_data["VALUE"] = pd.to_numeric(us_data["VALUE"])us_data.plot(x="TIME_PERIOD", y="VALUE", title="US GDP Gap Over Time", kind="line", ax=axes[0, 2])
# 한국kr_data = df[(df["COUNTRY"] == "KOR") & (df["INDICATOR"] == "NGDP_R")].copy()kr_data["VALUE"] = pd.to_numeric(kr_data["VALUE"])kr_data.plot(x="TIME_PERIOD", y="VALUE", title="Korea Real GDP Over Time", kind="line", ax=axes[1, 0])kr_data = df[(df["COUNTRY"] == "KOR") & (df["INDICATOR"] == "NGDP_RPCH")].copy()kr_data["VALUE"] = pd.to_numeric(kr_data["VALUE"])kr_data.plot(x="TIME_PERIOD", y="VALUE", title="Korea Real GDP Growth Rate Over Time", kind="line", ax=axes[1, 1])kr_data = df[(df["COUNTRY"] == "KOR") & (df["INDICATOR"] == "NGAP_NPGDP")].copy()kr_data["VALUE"] = pd.to_numeric(kr_data["VALUE"])kr_data.plot(x="TIME_PERIOD", y="VALUE", title="Korea GDP Gap Over Time", kind="line", ax=axes[1, 2])
plt.tight_layout()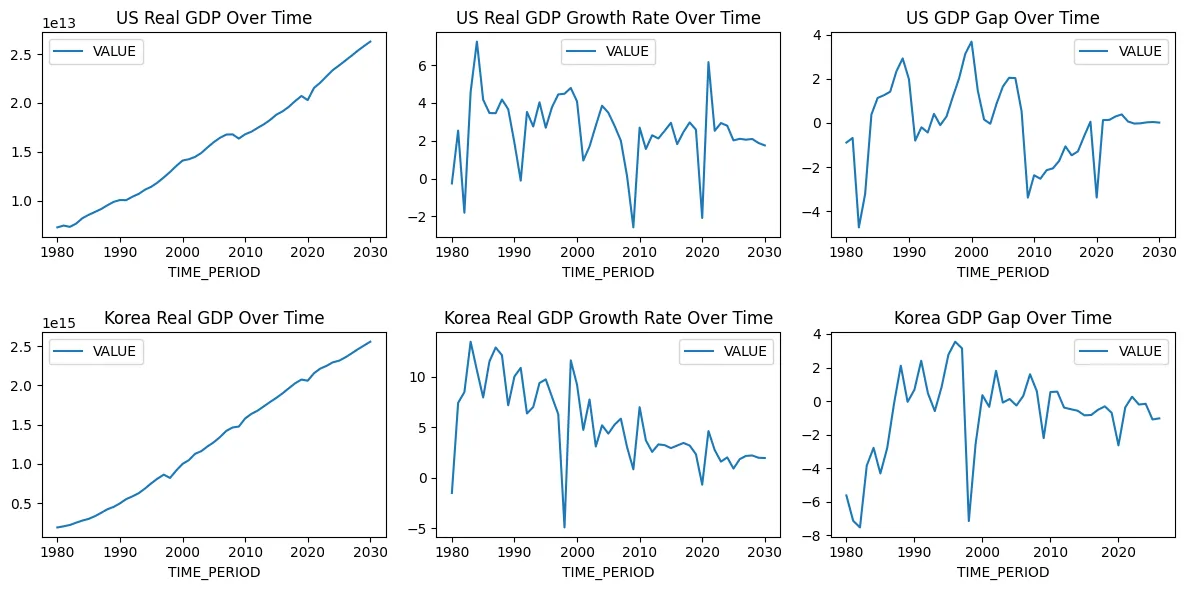
양국의 실질 GDP는 꾸준히 증가하는 추세를 보이며, 실질 GDP 성장률은 경기 변동에 따라 등락을 반복하는 모습을 확인할 수 있습니다.
GDP 갭 역시 경제 상황에 따라 변화하는 모습을 시각적으로 파악할 수 있습니다. 잠재 GDP는 경제가 완전 고용 상태에서 생산할 수 있는 최대 생산량을 나타내는데, GDP 갭이 양수일 경우 실제 GDP가 잠재 GDP를 초과하는 상태를 의미하며, 음수일 경우 그 반대를 의미합니다. GDP 갭이 양수로 크면 인플레이션 압력이 증가할 수 있고, 음수로 크면 경기 침체의 신호일 수 있습니다.
이와 같이 파이썬을 활용하여 IMF WEO 데이터베이스에서 각국의 GDP 데이터를 수집하고 분석할 수 있습니다. 미국, 한국 외에도 다양한 국가의 GDP 데이터를 동일한 방법으로 수집하여 비교 분석할 수 있습니다.