콘텐츠로 이동
7 posts with the tag “상관관계”

ETF 상관계수만으로 분산효과를 판단하면 안 되는 이유

서로 다른 자산의 움직임과 상관관계를 표현한 연구 공간

ETF를 여러 개 담으면 포트폴리오가 자동으로 안전해질까요? 흔히 ETF 사이의 상관계수가 낮으면 분산효과가 크다고 설명합니다. 방향은 맞지만, 상관계수 하나만으로 실제 위험을 판단하기에는 부족합니다. 평소에는 서로 다르게 움직이던 자산도 시장 충격이 발생하면 함께 하락할 수 있기 때문입니다.

이 글에서는 상관계수의 의미와 한계를 살펴보고, ETF 포트폴리오를 구성할 때 함께 확인해야 할 지표를 정리합니다.

두 ETF의 수익률을 , 라고 할 때 피어슨 상관계수는 다음과 같이 계산합니다.

값이 1에 가까우면 같은 방향으로, -1에 가까우면 반대 방향으로 움직이는 경향이 있다는 뜻입니다. 0에 가까우면 선형적인 동조화가 뚜렷하지 않습니다.

문제는 이 값이 어떤 기간과 수익률 간격을 사용했는지에 따라 달라진다는 점입니다. 일간 수익률로 계산한 상관계수와 월간 수익률로 계산한 상관계수는 서로 다를 수 있습니다. 상승장, 하락장, 금리 변동기처럼 시장 국면을 나누면 결과가 더 크게 달라질 수 있습니다.

낮은 상관계수가 항상 낮은 위험은 아니다

섹션 제목: “낮은 상관계수가 항상 낮은 위험은 아니다”

포트폴리오의 분산은 각 자산의 변동성과 자산 사이의 공분산에 의해 결정됩니다.

따라서 상관계수는 중요한 요소이지만 전체가 아닙니다. 상관계수가 낮아도 한 자산의 변동성이 매우 크면 포트폴리오 위험이 커질 수 있습니다. 반대로 상관계수가 다소 높더라도 변동성이 낮고 비중이 적절하면 전체 변동성을 완화할 수 있습니다.

예를 들어 주식 ETF와 원자재 ETF를 섞었다고 해도, 두 상품의 가격 변동폭과 환율 민감도가 크게 다르면 단순 상관계수만으로 체감 위험을 설명하기 어렵습니다. ETF의 기초자산뿐 아니라 환헤지 여부, 선물 롤오버, 분배금 정책도 함께 봐야 합니다.

위기 때 상관관계가 높아지는 현상

섹션 제목: “위기 때 상관관계가 높아지는 현상”

평상시에는 서로 다른 자산군으로 보이던 상품이 급락장에서 동시에 하락하는 현상을 흔히 관찰할 수 있습니다. 투자자가 위험자산을 한꺼번에 줄이거나, 유동성이 낮은 자산부터 매도하기 때문입니다.

이런 현상을 확인하려면 전체 기간의 상관계수 하나보다 다음 결과를 나누어 보는 편이 낫습니다.

  • 전체 기간의 상관계수
  • 하락한 날만 추린 하방 상관계수
  • 최근 60일 또는 120일 이동 상관계수
  • 두 ETF가 같은 날 손실을 기록한 비율
  • 포트폴리오의 최대낙폭과 회복 기간

특히 하방 상관계수가 전체 상관계수보다 높다면, 평소에는 분산되어 보여도 손실이 커지는 시점에 함께 움직일 가능성을 경계해야 합니다.

ETF 분산효과를 확인하는 실전 순서

섹션 제목: “ETF 분산효과를 확인하는 실전 순서”

먼저 비교할 ETF의 총수익률 기준을 통일해야 합니다. 분배금을 제외한 가격 수익률만 비교하면 실제 투자자가 경험하는 결과와 차이가 생길 수 있습니다. 그다음 동일한 기간과 빈도의 수익률로 상관계수와 변동성을 계산합니다.

returns = prices.pct_change().dropna()
summary = returns[['etf_a', 'etf_b', 'etf_c']].agg(['mean', 'std'])
correlation = returns[['etf_a', 'etf_b', 'etf_c']].corr()
downside_correlation = returns[returns[['etf_a', 'etf_b', 'etf_c']].min(axis=1) < 0].corr()

마지막으로 동일한 비중을 가정한 포트폴리오 수익률을 계산하고, 월별 또는 분기별 리밸런싱을 적용해 결과가 어떻게 바뀌는지 확인합니다. 상관계수가 낮더라도 한 상품이 계속 상승해 비중이 커지면, 시간이 지나면서 포트폴리오의 위험 구조가 달라질 수 있습니다.

상관계수 외에 확인할 체크리스트

섹션 제목: “상관계수 외에 확인할 체크리스트”
  • 기초자산과 지역이 실제로 얼마나 겹치는가
  • 상위 보유종목의 중복 비중은 얼마인가
  • 환율과 환헤지 여부가 성과에 어떤 영향을 주는가
  • 하락장에서 동시 손실 빈도는 어느 정도인가
  • 최대낙폭과 회복 기간이 감당 가능한 수준인가
  • 거래량과 스프레드가 리밸런싱 비용을 키우지 않는가

ETF 이름이 다르거나 운용사가 달라도 상위 보유종목이 비슷하면 실질적인 분산효과는 작을 수 있습니다. 반대로 상관계수가 낮아 보이는 상품도 구조가 복잡하거나 거래비용이 크면 장기 보유에 적합하지 않을 수 있습니다.

상관계수는 ETF 포트폴리오를 분석하는 좋은 출발점이지만, 분산효과의 최종 답은 아닙니다. 기간과 수익률 빈도를 바꾸어도 결과가 유지되는지 확인하고, 하락장 상관관계·변동성·최대낙폭·보유종목 중복도를 함께 살펴야 합니다.

좋은 분산 포트폴리오는 단순히 서로 다른 이름의 ETF를 모은 포트폴리오가 아닙니다. 손실이 커지는 국면에서 위험이 어떻게 겹치는지 설명할 수 있는 포트폴리오에 가깝습니다.

이 글은 ETF와 포트폴리오 분석 방법을 설명하기 위한 자료이며, 특정 상품의 매수·매도를 권유하지 않습니다.

물가 지수와 코스피의 상관관계 분석

이번 포스트에서는 한국의 소비자/생산자 물가 지수와 코스피 사이의 상관관계를 분석합니다. 이 포스트에서 사용하는 데이터는 퀀티랩 네이버 카페의 금융 데이터 게시판에서 다운받을 수 있습니다.

먼저 다운받은 데이터들을 불러옵니다.

import pandas as pd
df_cpi = pd.read_csv('./cpi_20220215.csv', header=0)
df_ppi = pd.read_csv('./ppi_20220215.csv', header=0)
df_kospi = pd.read_csv('./kospi_20220218.csv', header=0)

이 세 데이터를 하나의 DataFrame으로 합치겠습니다. 코스피는 일별이고 CPI 및 PPI 데이터는 월별 데이터 입니다.

df = df_kospi.merge(df_cpi, how='left', on='month').fillna(method='ffill').dropna(subset=['cpi'])
df = df.merge(df_ppi, how='left', on='month').fillna(method='ffill').dropna(subset=['ppi'])
df['dt'] = pd.to_datetime(df['date'], format='%Y%m%d')
df['cpi'] = df['cpi'].astype(float)
df['ppi'] = df['ppi'].astype(float)
df = df.reset_index(drop=True)

월별 데이터를 일별 데이터로 month 열을 기준으로 left join 했습니다. 여기서 cpi, ppi 열의 데이터 형식이 문자열로 되어 있어서 float로 캐스팅 했습니다.

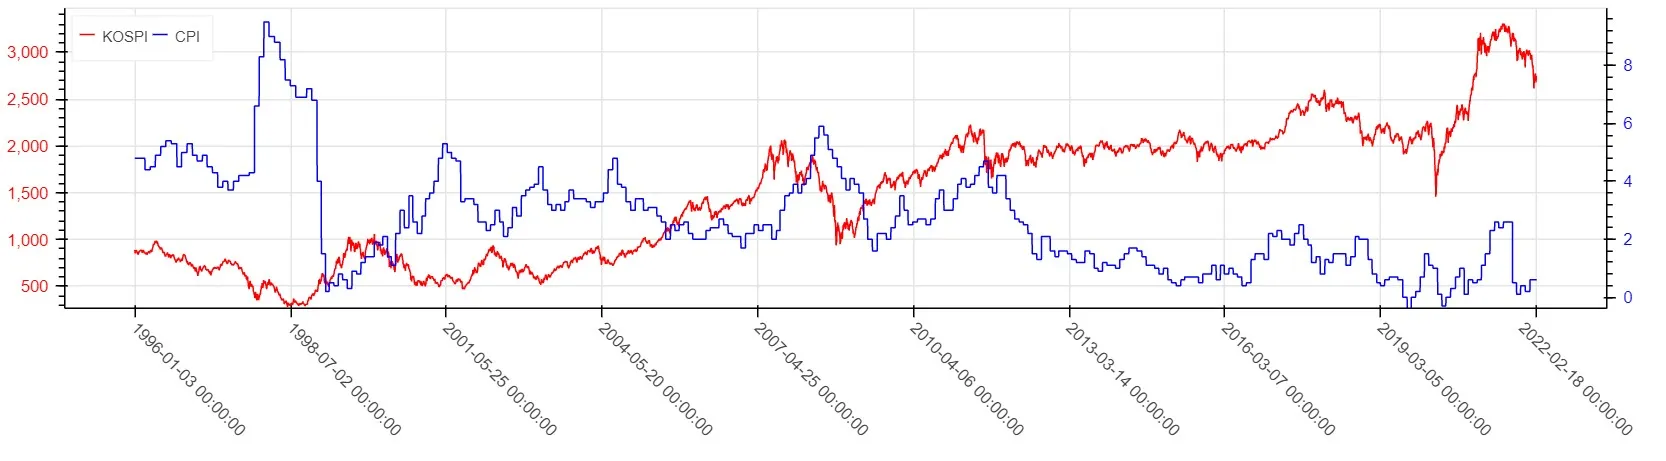
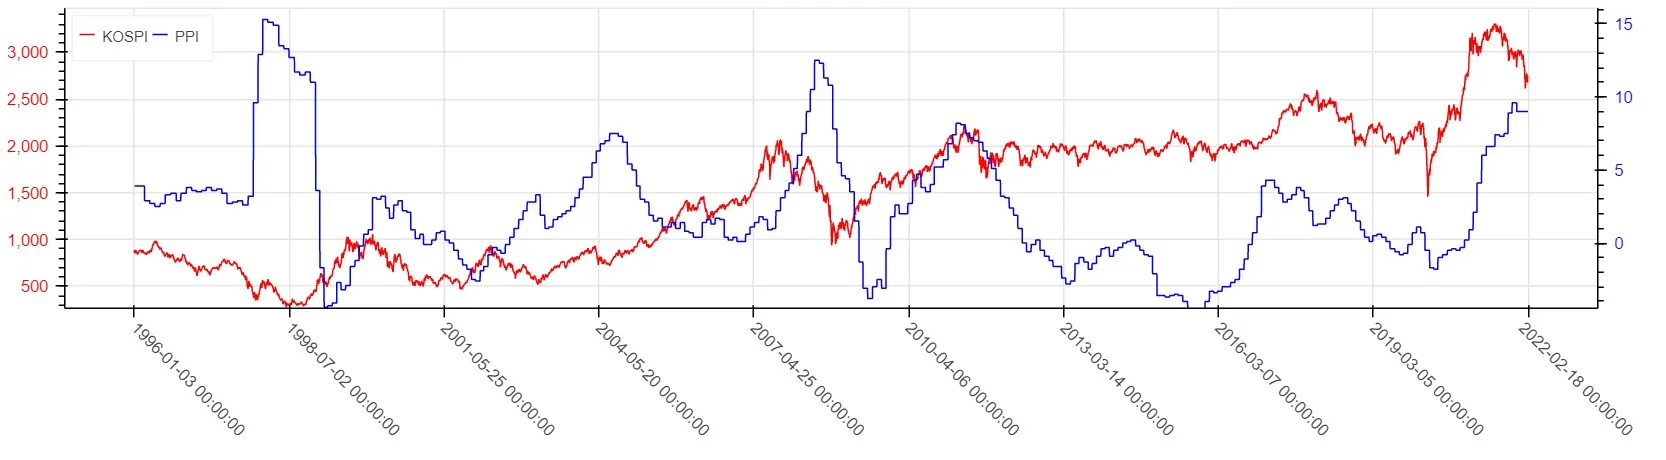
이제 코스피와 CPI, 코스피와 PPI 차트를 출력해 보려고 합니다. 두 데이터의 값의 범위가 크게 차이나기 때문에 y 축을 2개 사용합니다.

다음과 같이 두 시계열을 별도의 y축으로 그리는 함수인 get_multchart()를 작성했습니다.

def get_multchart(xticklabels, y1, y2, label1='', label2='', w=500, h=300, sizing_mode='stretch_width'):
x = np.arange(len(xticklabels))
xticks = np.linspace(0, len(xticklabels)-1, 10, endpoint=True, dtype=int).tolist()
p = figure(plot_width=w, plot_height=h, tools='', y_axis_location='left')
p.xaxis.ticker = xticks
p.xaxis.major_label_overrides = {_x: util.format_date(str(xticklabels[_x])) for _x in xticks}
p.xaxis.major_label_orientation = -np.pi / 4
p.yaxis.major_label_text_color = 'red'
p.yaxis.formatter = NumeralTickFormatter(format='0,0')
p.y_range = Range1d(y1.min() * 0.95, y1.max() * 1.05)
p.extra_y_ranges = {
'y2_range': Range1d(y2.min() * 0.95, y2.max() * 1.05)
}
y2_axis = LinearAxis(y_range_name='y2_range')
y2_axis.major_label_text_color = 'blue'
y2_axis.formatter = NumeralTickFormatter(format='0,0')
p.add_layout(y2_axis, 'right')
p.line(x, y1, line_color='red', legend_label=label1)
p.line(x, y2, line_color='blue', legend_label=label2, y_range_name='y2_range')
configure_legend(p)
grid = gridplot([[p]], toolbar_location=None, sizing_mode=sizing_mode)
return grid

이 함수를 이용해서 두 차트를 그립니다. 먼저 코스피와 CPI, 다음으로 코스피와 PPI를 그립니다.

from bokeh.io import output_notebook, show
output_notebook()
show(get_multchart(df['dt'], df['close'], df['cpi'], label1='KOSPI', label2='CPI'))
show(get_multchart(df['dt'], df['close'], df['ppi'], label1='KOSPI', label2='PPI'))

cpi

ppi

여기서 CPI, PPI는 전월 대비 % 값입니다. CPI와 코스피를 봤을 때 2001년 부근에서는 서로 역관계처럼 보이다가 2007년 부근에서는 코스피가 CPI를 선행하는 것처럼도 보입니다. PPI도 구간에 따라서 상관성이 다르게 보입니다. 즉 물가 지수와 코스피만으로 서로가 밀접한 상관성이 있다고 말할 수는 없어 보입니다. 이 부부은 2008년 금융위기로 주식 폭락과 물가

실제로 피어슨 상관계수를 구해 보면 구간에 따라서 매우 큰 차이가 생기는 것을 볼 수 있습니다.

from scipy.stats import pearsonr
_df = df[df['date'] >= '20150101']
print(pearsonr(_df['close'], _df['cpi']))
print(pearsonr(_df['close'], _df['ppi']))
(0.3184625030996628, 1.1693520291646116e-42)
(0.7737092632552787, 0.0)

그렇다고 상관성이 아주 없다고 볼 수도 없습니다. 주식 딥러닝 모델을 구축할 때 학습데이터의 피처로 충분히 활용할 만하다고 보입니다.

구글 검색 트렌드와 코스피 상관관계 분석

이번 포스트에서는 “kospi” 검색어에 대한 구글 검색 트렌드와 실제 코스피 지수를 한 차트에 그려보고 상관관계 분석을 해보겠습니다. 여기서 사용하는 데이터는 퀀티랩 네이버 카페에 올려 놓았습니다. 카페에 가입하시면 다운 받으실 수 있습니다.

위 데이터를 다운 받은 후 먼저 아래와 같이 구글 검색 트렌드 데이터를 불러옵니다. 이 데이터는 주간 단위의 데이터이므로 4년치라도 행의 수는 많지 않습니다.

import pandas as pd
df = pd.read_csv('./google_trend_kospi_2018_2021.csv', header=1)
df.columns = ['date', 'interest']
df['date'] = pd.to_datetime(df['date'], format="%Y-%m-%d")
df
indexdateinterest
02018-01-0726
12018-01-1430
22018-01-2128
32018-01-2829
42018-02-0433
………
2032021-11-2853
2042021-12-0556
2052021-12-1255
2062021-12-1960
2072021-12-2652

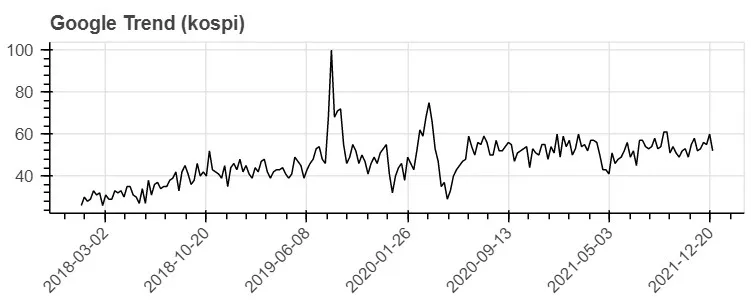
이 데이터를 다음처럼 차트로 그려볼 수 있습니다. 차트를 그릴 때 다양한 라이브러리를 활용할 수 있지만 여기서는 bokeh 라이브러리를 사용했습니다.

from math import pi
from bokeh.io import output_notebook, show
from bokeh.plotting import figure, gridplot
from bokeh.models import DatetimeTickFormatter
output_notebook()
grid = []
p = figure(title='Google Trend (kospi)', plot_width=500, plot_height=200, tools="crosshair")
p.line(df['date'], df['interest'], line_color='black')
p.xaxis.formatter = DatetimeTickFormatter(months=["%Y-%m-%d"])
p.xaxis.major_label_orientation = pi/4
grid.append([p])
p = gridplot(grid, toolbar_location=None)
show(p)

1

이제 코스피 종가 데이터를 불러옵니다. 위 구글 트렌드 데이터와 같은 y축으로 그리기 위해서 종가 값을 0~100 사이로 조정하여 pos 컬럼에 추가했습니다.

df_kospi = pd.read_csv('./kospi_2018_2021.csv', converters={'date': str})
df_kospi['date'] = pd.to_datetime(df_kospi['date'], format="%Y%m%d")
df_kospi['pos'] = ((df_kospi['close'] - df_kospi['close'].min()) / (df_kospi['close'].max() - df_kospi['close'].min())) * 100
df_kospi
indexdateclosepos
02018-01-022479.64990255.316438
12018-01-032486.35009855.679087
22018-01-042466.45996154.602531
32018-01-052497.52002056.283661
42018-01-082513.28002957.136674
…………
9812021-12-243012.42993284.153237
9822021-12-272999.55004983.456111
9832021-12-283020.23999084.575958
9842021-12-292993.29003983.117288
9852021-12-302977.64990282.270763

이제 코스피 종가 데이터도 차트에 추가로 그려봅니다.

from math import pi
from bokeh.plotting import figure, show
from bokeh.models import DatetimeTickFormatter
from bokeh.models import Legend
grid = []
p = figure(title='Google Trend (kospi) and KOSPI Position', plot_width=800, plot_height=200, tools="crosshair")
a1 = p.line(df['date'], df['interest'], line_color='black')
a2 = p.line(df_kospi['date'], df_kospi['pos'], line_color='red')
p.xaxis.formatter = DatetimeTickFormatter(months=["%Y-%m-%d"])
p.xaxis.major_label_orientation = pi/4
legend = Legend(items=[
('G. Trend', [a1]),
('KOSPI Pos.', [a2]),
], location="center")
p.add_layout(legend, 'right')
grid.append([p])
p = gridplot(grid, toolbar_location=None)
show(p)

2

눈으로 보기에는 “kospi” 검색어가 급증할 때 코스피 지수가 폭락한 경우가 많았음이 보입니다. 공포 심리에 의해 뉴스 등을 찾아보기 위해 검색이 급증하고 실제로 코스피 지수도 요동치는 경우가 있습니다. 물론 상관성은 높지 않아 보이지만 검색 급증이 있으면 하나의 작은 위험 신호로 고려하는 것도 나쁘지 않을 것입니다. 조심해서 나쁠 것은 없습니다.

다음과 같이 상관 계수를 뽑아 보면 그렇게 상관성은 높게 나오지 않습니다. 시계열 전체에서의 상관성 보다는 검색 급증 시그널 정도만 잘 포착하는 것이 의미있어 보입니다.

from scipy.stats import pearsonr
_df = df.merge(df_kospi, how='outer', on='date').sort_values(by='date')
_df = _df.ffill()
_df = _df.bfill()
pearsonr(_df['pos'], _df['interest'])
(0.14169129281665557, 8.844934622779502e-07)

원자재 지수와 주가의 상관관계 분석

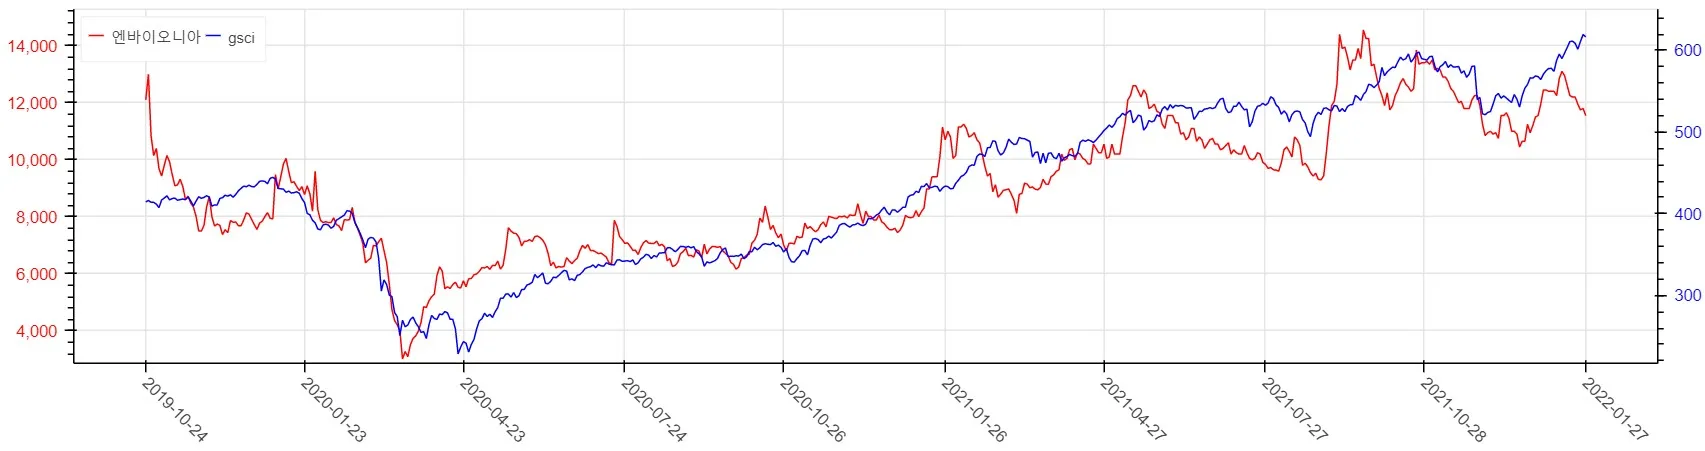
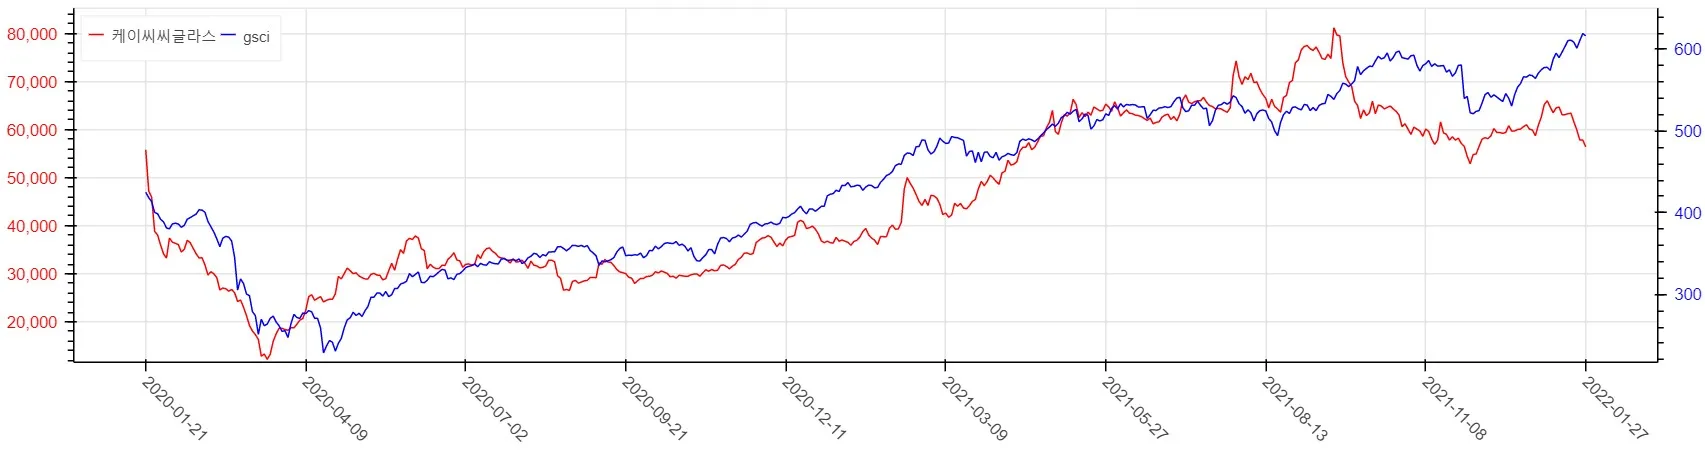
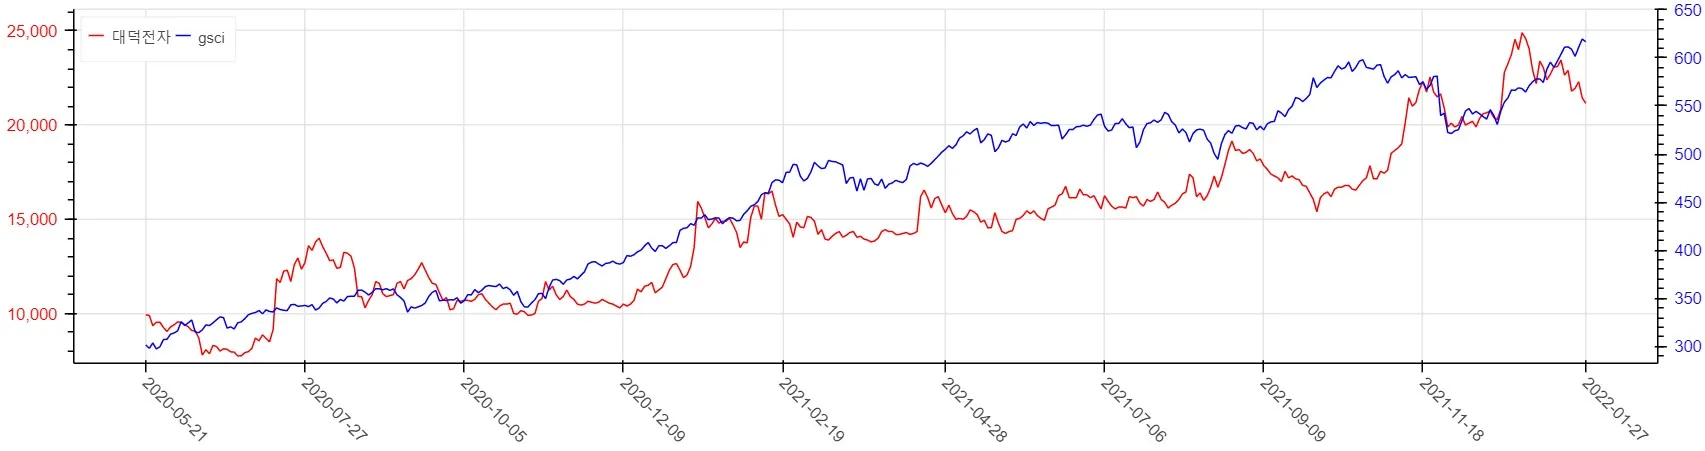
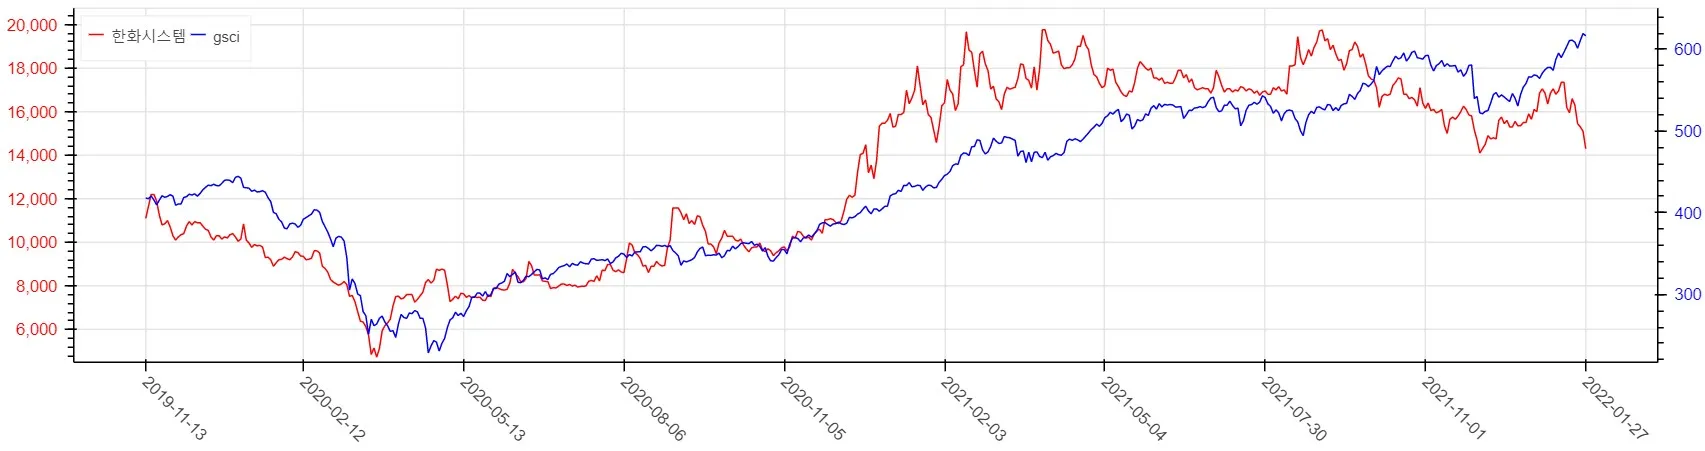
이번 포스트에서는 대표적인 원자재 지수인 S&P GSCI와 주식 종목 주가와의 상관관계를 분석해봅니다. 다음 코드 블록은 종목코드 데이터, 원자재 지수 데이터를 불러오는 부분입니다. 데이터는 퀀티랩 네이버 카페의 금융데이터 메뉴에서 공유드립니다.

이번 포스트에서는 대표적인 원자재 지수인 S&P GSCI와 주식 종목 주가와의 상관관계를 분석해봅니다. 다음 코드 블록은 종목코드 데이터, 원자재 지수 데이터를 불러오는 부분입니다. 데이터는 퀀티랩 네이버 카페의 금융데이터 메뉴에서 공유드립니다.

# 종목코드 데이터 준비
import json
with open('../../../data/stockcodes_20220128.json', encoding='utf-8') as f:
stockcodes = json.load(f)
stockcodes

[[‘082740’, ‘HSD엔진’], [‘001390’, ‘KG케미칼’], [‘011070’, ‘LG이노텍’], [‘002360’, ‘SH에너지화학’], [‘001740’, ‘SK네트웍스’], [‘071970’, ‘STX중공업’], [‘024070’, ‘WISCOM’], [‘011420’, ‘갤럭시아에스엠’], [‘267290’, ‘경동도시가스’], [‘002240’, ‘고려제강’], [‘001290’, ‘상상인증권’], [‘014530’, ‘극동유화’], [‘214330’, ‘금호에이치티’], [‘013700’, ‘까뮤이앤씨’], [‘090350’, ‘노루페인트’], [‘005250’, ‘녹십자홀딩스’], [‘004440’, ‘삼일씨엔에스’], [‘014160’, ‘대영포장’], [‘003090’, ‘대웅’], [‘003220’, ‘대원제약’], [‘002880’, ‘대유에이텍’], [‘001620’, ‘케이비아이동국실업’], [‘023450’, ‘동남합성’], [‘004140’, ‘동방’], [‘000640’, ‘동아쏘시오홀딩스’], [‘225330’, ‘씨엠에스에듀’], [‘101240’, ‘씨큐브’], [‘047920’, ‘HLB제약’], [‘013990’, ‘아가방컴퍼니’], [‘052710’, ‘아모텍’], …]

# 원자재 데이터 준비
import pandas as pd
df_gsci = pd.read_csv('../../../data/gsci_20220128.csv', converters={'date': str})
df_gsci
dateclosediffdiffratiohighlowopenvolume
20150102414.9583-3.177835-0.0076421.5643412.5496418.12250
20150105404.6091-10.332034-0.0249414.9583403.7641414.95830
20150106397.9523-6.676373-0.0165406.4719396.1576404.60910
20150107396.6795-1.273449-0.0032400.6534392.2534397.95230
20150108397.10100.4363310.0011399.5170393.1882397.22570
……………………
20220121608.8819-2.568090-0.0042611.4234599.3347611.42340
20220124601.5777-7.306612-0.0120612.6561595.1512608.88190
20220125611.03789.4450070.0157611.3097601.1267601.57770
20220126619.54848.4936610.0139621.5063608.4988611.03780
20220127616.7431-2.787889-0.0045623.2471613.9215619.54840

다음은 종목 일봉 차트와 원자재 지수의 상관관계를 구합니다. 여기서 사용한 상관분석 방법은 피어슨 상관분석 입니다. 피어슨은 상관계수가 -1에서 1 사이의 값으로, 1에 가까울수록 정관계, -1에 가까울수록 역관계임을 의미합니다.

# 종목 데이터 준비
# 종목과 원자재 상관관계 저장
from scipy.stats import pearsonr
from tqdm import tqdm
df_corr = pd.DataFrame()
for code, name in tqdm(stockcodes):
data = {'code': code, 'name': name}
df_stockcandles_day = pd.read_csv(
f'../../../data/stockcandles_day_20220128/stockcandles_day_{code}_{name}_20220128.csv',
converters={'date': str}
)
start_date = df_stockcandles_day.iloc[0]['date']
end_date = df_stockcandles_day.iloc[-1]['date']
_df_gsci = df_gsci[(df_gsci['date'] >= start_date) & (df_gsci['date'] <= end_date)]
_df = pd.merge(df_stockcandles_day, _df_gsci, how='left', on='date', suffixes=['_stock', '_commodity'])
_df = _df.dropna()
if len(_df) < 20:
continue
corr, p = pearsonr(_df['close_stock'], _df['close_commodity'])
if p <= 0.05:
data['gsci'] = corr
else:
data['gsci'] = 0
df_corr = df_corr.append(data, ignore_index=True)
columns = df_corr.columns.tolist()
columns.remove('code')
columns.remove('name')
columns = ['code', 'name'] + columns
df_corr = df_corr[columns]
df_corr
codenamegsci
082740HSD엔진0.697773
001390KG케미칼0.771450
011070LG이노텍0.650439
002360SH에너지화학-0.084560
001740SK네트웍스-0.138996
………
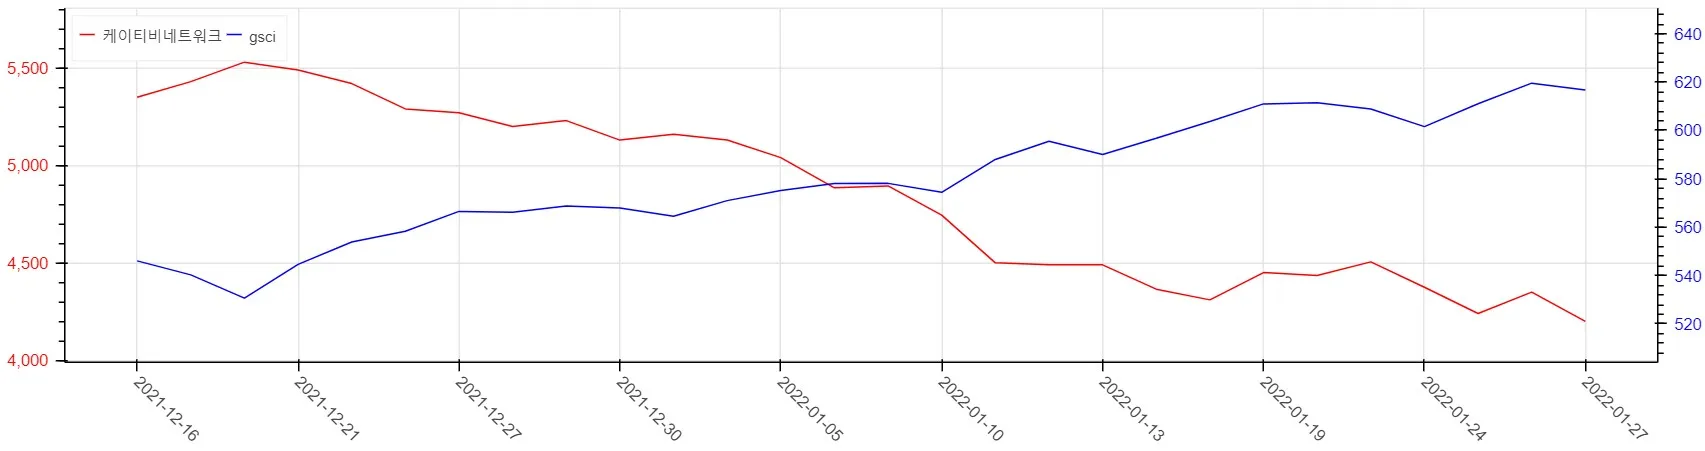
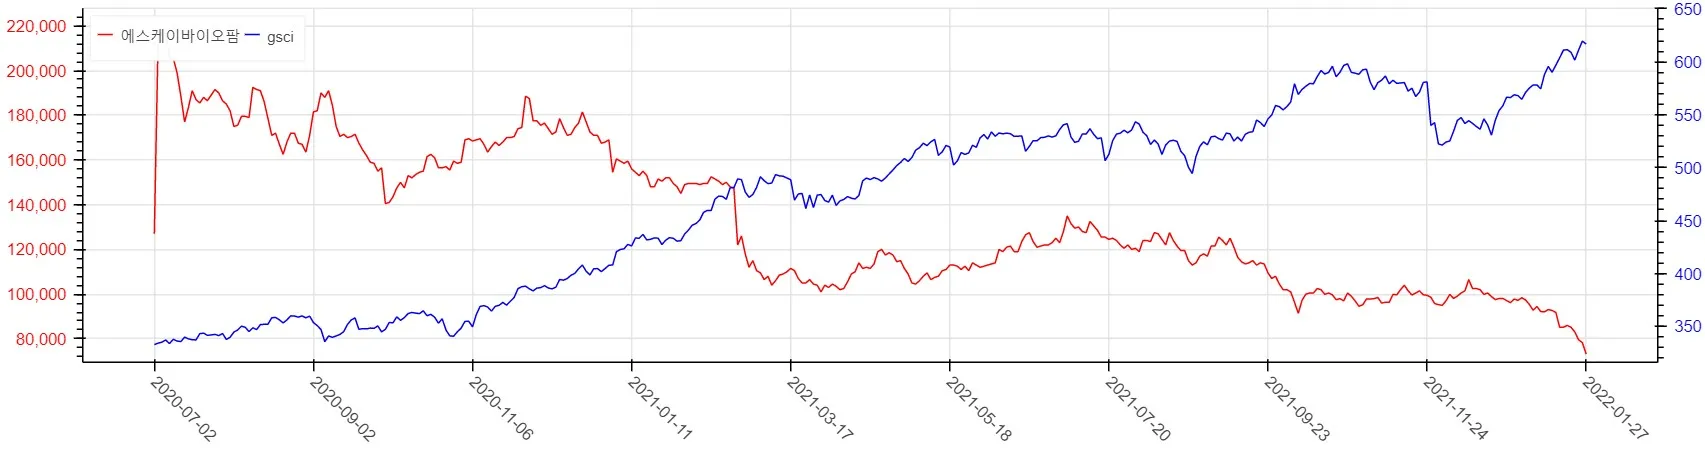
298870케이티비네트워크-0.954783
400840하이제7호스팩0.000000
397880교보11호스팩0.000000
396770엔에이치스팩22호-0.438219
400560하나금융20호스팩0.000000

이렇게 종목 일봉 차트와 GSCI의 상관계수를 구하고 다음과 같이 후처리합니다.

# NaN 제거
df_corr2 = df_corr.dropna().copy()
# 데이터 저장
df_corr2.to_csv('data/corr.csv', index=False)
# 데이터 불러오기
str_columns = ['code', 'name']
df_corr2 = pd.read_csv('data/corr.csv', converters={k: lambda x: str(x) for k in str_columns})

먼저 NaN을 제거하고 데이터를 저장합니다. 이 데이터도 퀀티랩 네이버 카페에 올려 놓겠습니다.

다음과 같이 스팩과 리츠 종목은 제거하고 상관관계가 높은 종목을 확인합니다.

# 스팩, 리츠 제외
df_corr3 = df_corr2[~(df_corr2['name'].str.endswith('스팩') | df_corr2['name'].str.endswith('리츠'))]

먼저 정관계로 상관관계가 높은 종목을 랭킹하여 가시화합니다.

# 상관관계 높은 종목 가시화
from quantylab.common import viz
for idx, row in df_corr3.sort_values(by='gsci', ascending=False).head(n=5).iterrows():
df_stockcandles_day = pd.read_csv(
'../../../data/stockcandles_day_20220128/stockcandles_day_{}_{}_20220128.csv'.format(row['code'], row['name']),
converters={'date': str}
)
start_date = df_stockcandles_day.iloc[0]['date']
end_date = df_stockcandles_day.iloc[-1]['date']
_df_gsci = df_gsci[(df_gsci['date'] >= start_date) & (df_gsci['date'] <= end_date)]
_df = pd.merge(df_stockcandles_day, _df_gsci, how='left', on='date', suffixes=['_stock', '_commodity'])
_df = _df.dropna().copy().reset_index(drop=True)
print('{} {} {}'.format(row['name'], row['max_commodity'], row['max_corr']))
viz.show_notebook(viz.get_multchart(_df['date'], _df['close_stock'], _df['close_commodity'], label1=row['name'], label2=row['max_commodity']))

1 2 3 4 5

주로 소형 제조업 위주로 랭킹되는 것을 볼 수 있습니다.

다음으로 역관계로 상관관계가 높은 종목을 랭킹하여 가시화합니다.

# 역 상관관계 높은 종목 가시화
from quantylab.common import viz
for idx, row in df_corr3.sort_values(by='gsci', ascending=True).head(n=5).iterrows():
df_stockcandles_day = pd.read_csv(
'../../../data/stockcandles_day_20220128/stockcandles_day_{}_{}_20220128.csv'.format(row['code'], row['name']),
converters={'date': str}
)
start_date = df_stockcandles_day.iloc[0]['date']
end_date = df_stockcandles_day.iloc[-1]['date']
_df_gsci = df_gsci[(df_gsci['date'] >= start_date) & (df_gsci['date'] <= end_date)]
_df = pd.merge(df_stockcandles_day, _df_gsci, how='left', on='date', suffixes=['_stock', '_commodity'])
_df = _df.dropna().copy().reset_index(drop=True)
print('{} {} {}'.format(row['name'], row['max_commodity'], row['max_corr']))
viz.show_notebook(viz.get_multchart(_df['date'], _df['close_stock'], _df['close_commodity'], label1=row['name'], label2=row['max_commodity']))

6 7 8 9 10

주로 연구 위주의 중소형주가 상위랭킹되는 것을 볼 수 있습니다.

데이터 받아가셔서 다양하게 분석해 보시기 바랍니다.

코스피200 선물과 현물

이번 포스트에서는 코스피200 현물과 선물의 상관관계 분석 결과를 다룹니다.

코스피200 선물은 코스피200 현물 지수가 앞으로 어떻게 될지 예상하여 거래하는 가격입니다. 앞으로 코스피200이 상승할 것 같다고 판단한 투자자가 우세하면 선물 가격은 상승하고 코스피200이 하락할 것 같다고 판단한 투자자가 우세하면 선물 가격은 하락합니다.

즉, 선물 가격이 현물 가격을 선행한다고 할 수 있는데 정말 그런지 확인해보고자 합니다. 그렇다면 선물의 움직임을 보고 현물 투자에 참고하면 될테니 말입니다.

코스피200 선물과 현물의 상관관계

섹션 제목: “코스피200 선물과 현물의 상관관계”

다음 관계가 통계적으로 만족하는지 확인하고자 합니다.

  • 선물 가격 상승 -> 현물 가격 상승
  • 선물 가격 하락 -> 현물 가격 하락

선물과 현물의 증감을 시계열로 구한 뒤 상관관계(correlation)을 확인해봅니다.

코스피200 선물과 현물 값의 차이(basis)

섹션 제목: “코스피200 선물과 현물 값의 차이(basis)”

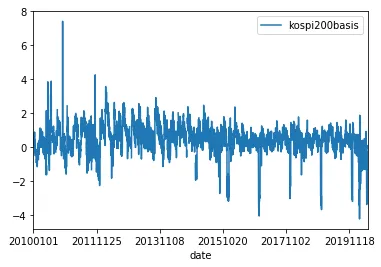
선물과 현물의 가격 차이를 베이시스(basis)라고 합니다. 코스피200의 베이시스를 구해보면 다음과 같습니다.

BASIS = KOSPI200F – KOSPI200
  • KOSPI200F: 코스피200선물 가격
  • KOSPI200: 코스피200현물 가격

1

베이시스가 양수일 때는 현물보다 선물의 가격이 높다는 뜻으로 현물이 앞으로 상승할 것 같다는 의견이 우세한 것입니다. 반대로 베이시스가 음수이면 현물이 떨어질 것 같다는 의견이 우세한 것입니다.

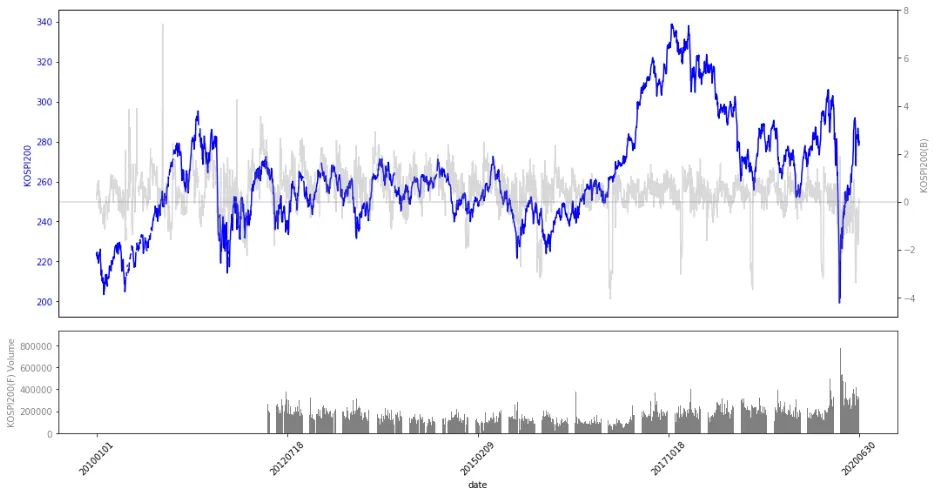
코스피200 현물 지표와 코스피200의 베이시스를 그려보면 다음과 같습니다.

2

대체적으로 베이시스는 양수인 경우가 많은 것을 알 수 있습니다.

종종 큰 값의 베이시스가 발생하는 부분을 살펴보며 현물의 움직임을 보면 그다지 밀접한 상관성이 보이지는 않습니다.

코스피200 현물과 베이시스의 상관관계 분석

섹션 제목: “코스피200 현물과 베이시스의 상관관계 분석”

다양한 해석이 가능하므로 참고만 하시기 바랍니다.

이견이 있으시면 자유롭게 댓글이나 메일 주시면 감사하겠습니다.

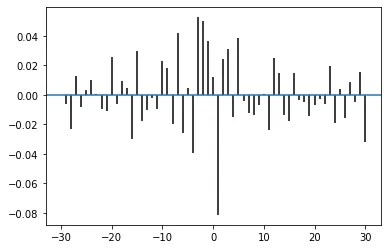
Correlation 분석 결과를 그려보면 다음과 같습니다.

3

이 결과를 다음과 같이 해석해 볼 수 있습니다.

  • 3일 뒤의 선물이 현재 현물과 가장 비슷하다.
  • 선물 가격 변화 다음날은 오히려 현물이 반대로 움직인 경우가 많다.
  • 확률적으로 선물 가격 변화 방향으로 2, 3일 뒤 현물 가격이 따라 가는 경우가 많다.

코로나19 사태에서의 코스피와 해외주식시장, 금, 원유, 환율 상관관계

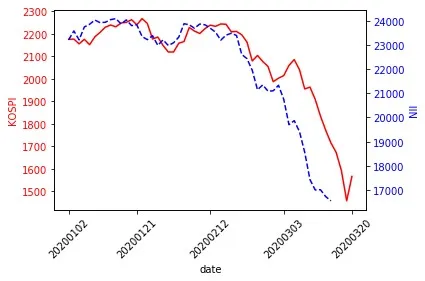
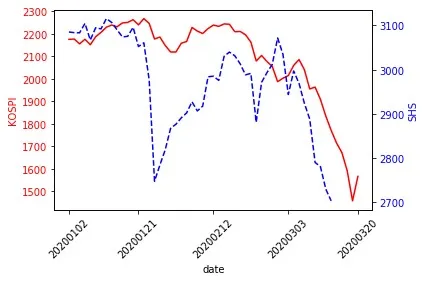
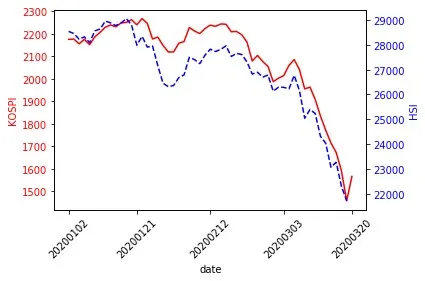
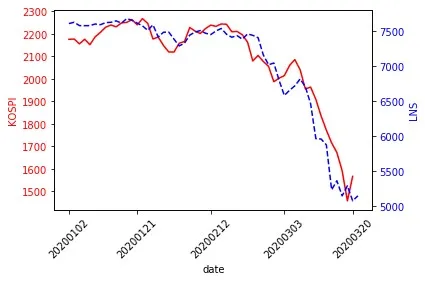
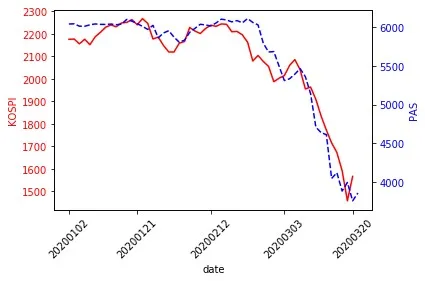
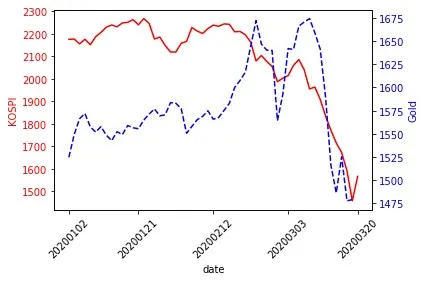
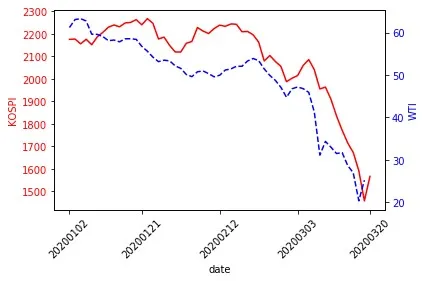
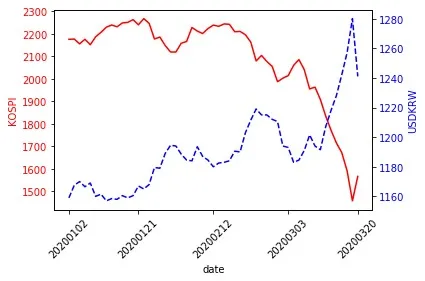
코로나19 사태에서 코스피 지수와 주요 해외 주식 시장 및 금, 원유, 원달러 환율의 상관관계를 살펴보겠습니다. 코로나19 사태로 주요국 증시가 엄청난 하락폭을 보이고 있습니다.

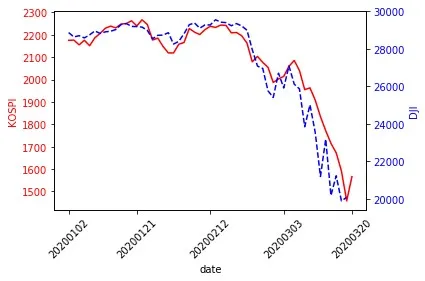
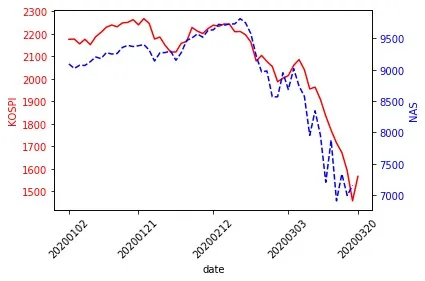
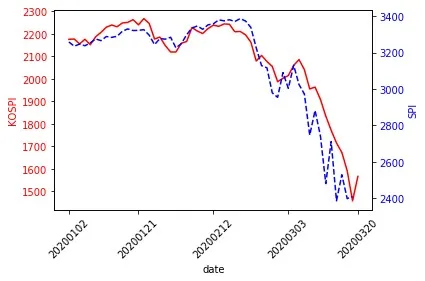
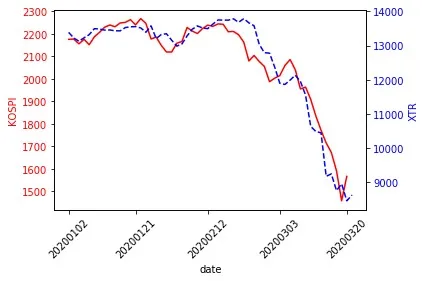
다음은 코스피와 주요 해외 주식 시장의 종가를 같이 그린 모습입니다.

kospi_dji kospi_nas kospi_spi kospi_nii kospi_shs kospi_hsi kospi_lns kospi_pas kospi_xtr

가장 먼저 상황이 심각했던 중국의 상해종합 지수는 1월말에 급락하는 모습을 보입니다. 항셍 지수도 다른 해외 지수들보다도 더 많이 하락하는 모습입니다.

그 외의 대부분의 지수들은 코스피와 그 모습이 크게 다르지 않습니다. 미국의 경우 3월 중반에 급등과 급락을 반복하지만 결국 추세는 하락하는 모양세입니다.

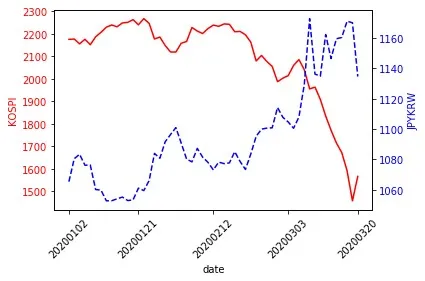
다음은 코스피와 금, 원유, 달러, 일본 엔 환율을 같이 그린 모습입니다.

kospi_gold kospi_wti kospi_usdkrw kospi_jpykrw

안전자산이라 여겨지는 금이 크게 빠졌습니다. 위기일 때 보통 금 지수는 올라가기 마련인데 이번 코로나19 사태에서는 통하지 않았습니다. 금보다는 달러를 더 선호하여 달러가 급등하는 모습입니다.

상관관계 순으로 보면 다음과 같습니다.

TargetCorrelation
NII@NI2250.9709107854451309
DJI@DJI0.9698340438431805
XTR@DAX300.969026490653162
PAS@CAC400.9688738794309948
LNS@FTSE1000.9642702121797924
SPI@SPX0.9605159313835816
HSI@HSI0.9403151549240741
NAS@IXIC0.9396642438028351
WTI0.9072223139452107
SHS@0000010.5638300683413756
Gold0.15738037237527366
USDKWR-0.8553774707185525
JPYKRW-0.9009982462185702

일본 니케이와 미국 다우 지수와 매우 높은 상관관계를 보입니다. 물론 일본과는 시차가 없어서 특별히 높은 상관관계를 가질 수 있습니다. 그에 비하면 미국 시장과 상관관계가 매우 높다고 볼 수 있습니다. 그리고 전체적으로 주가가 급락하면서 달러와 엔의 가치가 높아진 것을 확인할 수 있습니다.
금은 이미 가격이 너무 많이 올라가 있었던 터라 조정을 받은게 아닐까 싶습니다.

국내 주식시장과 해외 주식시장의 상관관계

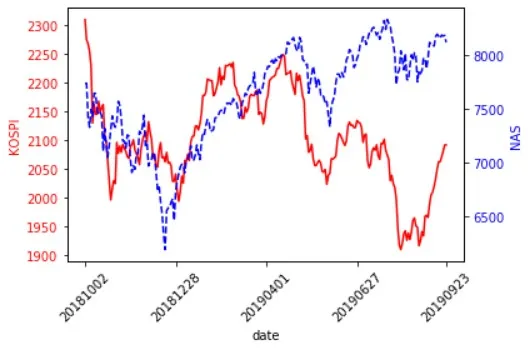
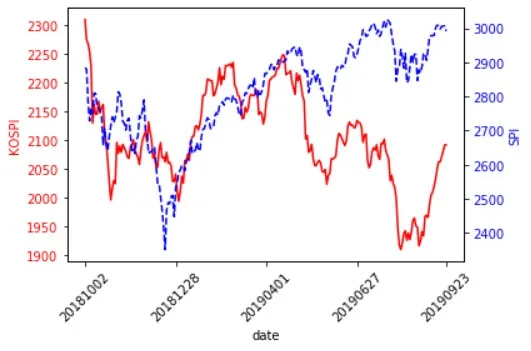
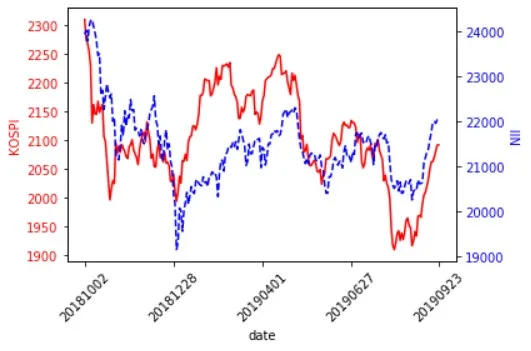
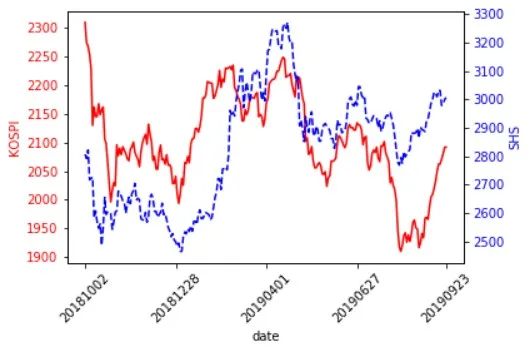
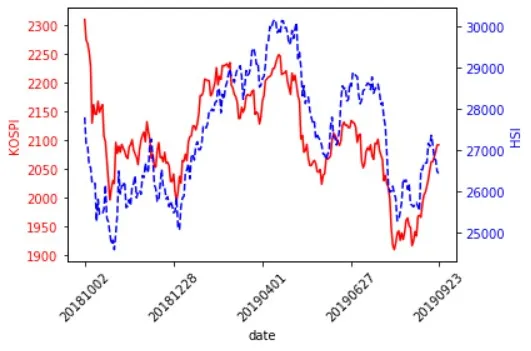
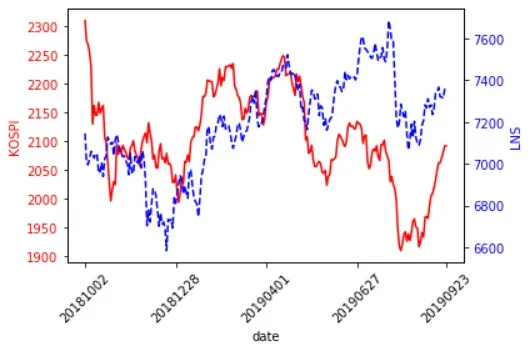
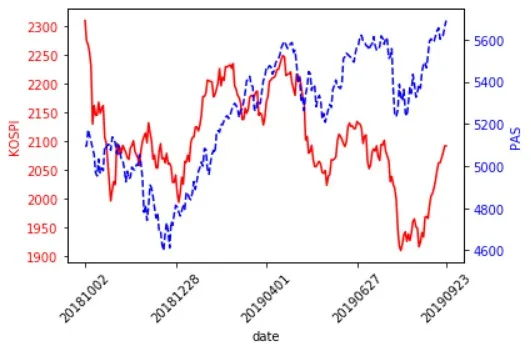
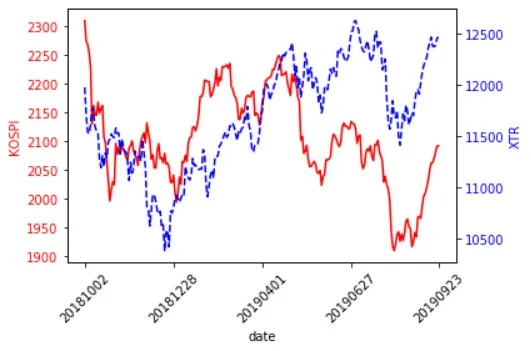
주식시장은 국내 사정 뿐만 아니라 해외 주요 국가들의 상황에 영향을 받습니다. 많은 투자자들이 특히 미국 주식시장 상황을 관심있게 지켜보는 이유가 미국 주식시장 상황에 우리나라 주식시장이 큰 영향을 받는다고 생각해서일 것입니다. 이번 포스트에서는 우리나라 주식시장과 주요국 주식시장들 간의 상관관계를 살펴보겠습니다.

주요 주식시장으로 한국의 KOSPI, 미국의 Dow Jones (DJI), Nasdaq (NAS), S&P 500 (SPI), 일본의 니케이 225 (NII), 중국의 상해종합 (SHS), 홍콩의 항셍 (HSI), 영국의 FTSE 100 (LNS), 프랑스의 CAC 40 (PAS), 독일의 DAX30 (XTR)를 들 수 있습니다. 괄호 안의 코드명은 네이버 금융을 참고했습니다. 각 해외 주식시장 지수들과 한국의 KOSPI 사이의 상관관계는 다음과 같습니다.
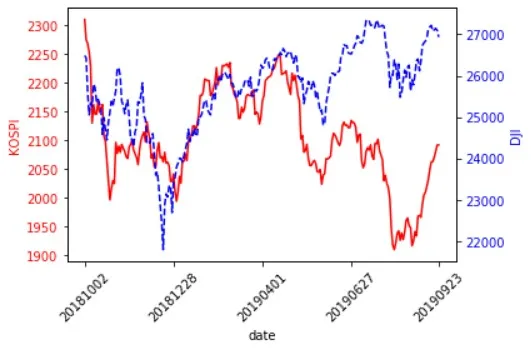
kospi_dji kospi_nas kospi_spi kospi_nii kospi_shs kospi_hsi kospi_lns kospi_pas kospi_xtr

상관관계가 높은 순으로 정렬해 보면 다음과 같습니다.

IndexCorrelation
HSI@HSI0.6646677893714394
NII@NI2250.39574631268446814
SHS@0000010.26712766899597473
LNS@FTSE1000.12171746103767508
DJI@DJI0.09225215796116076
PAS@CAC400.047920317117435045
XTR@DAX300.03127491770767439
NAS@IXIC0.019002467506360643
SPI@SPX-0.011244728898221503

이렇게 일일이 상관관계를 살펴보기 전에는 코스피가 미국 증시와 가장 비슷한 흐름을 보일 것으로 생각했으나, 실제로는 홍콩 증시와 더 비슷한 것을 알 수 있습니다. 그리고 확실히 코스피는 홍콩, 일본, 중국 등의 증시와 관계가 깊다고 볼 수 있습니다.