콘텐츠로 이동
20 posts in the category “Dev”

Django 서버 시작할 때 실행할 코드 설정하기

Django는 파이썬 계열에서 대표적인 웹 프레임워크 입니다. 많지는 않지만 서버를 실행함과 동시에 특정 코드를 실행할 일이 생깁니다. 예를 들어서, 서버를 시작하면서 파일을 읽거나, 객체를 생성해 놓거나, 다른 서버에 메시지를 전송하는 등이 될 수 있습니다.

이 때, AppConfig를 사용하면 됩니다. 먼저 AppConfig를 상속하는 클래스를 정의합니다.

app/broker.py
from django.apps import AppConfig
class MyAppConfig(AppConfig):
name = 'my_app'
verbose_name = "My App"
def ready(self):
# TODO: Write your codes to run on startup
pass

이렇게 정의한 클래스를 __init__.py에 명시해 주면 끝입니다.

app/__init__.py
default_app_config = 'app.broker.MyAppConfig'

그런데 한가지 주의할 점이 있습니다. 이 부분을 간과하면 곤란한 상황이 생길 수 있습니다. Django가 기본적으로 코드 검증 과정에서 한번, 코드 실행 과정에서 한번, 총 2번 MyAppConfig를 실행합니다.

두번 실행되는 일을 피하기 위해서 Django 서버를 실행할 때 다음과 같이 --noreload 옵션을 넣어줍니다.

Terminal window
python manage.py runserver 0.0.0.0:8000 --noreload
자바스크립트 (JavaScript)에서 객체지향 프로그래밍 (OOP) 하기

자바스크립트에서는 명시적으로 지원되는 객체지향 프로그래밍 방법이 부족합니다. 객체지향 프로그래밍의 철학을 철저하게 따르는 자바 (Java)와는 이름은 비슷하지만 차이가 많습니다.

이번 포스트에서는 자바스크립트에서 OOP를 흉내낼 수 있는 팁을 소개합니다.

OOP 꽃은 클래스 입니다. 클래스는 상태 (State)과 행동 (Behavior)을 캡슐화 (Encapsulation)하는 단위입니다. 상태는 속성 (Attribute)로, 행동은 메소드 (Method)로 구현됩니다. 물론 자바스크립트에서는 메소드를 함수 (Function)라고 명명하는 것이 더 자연스러울 것입니다.

그럼 자바스크립트에서 클래스를 만들어 보겠습니다.

function MyClass() {
}

사실 자바스크립트는 class 키워드를 완전히 지원하고 있지 않습니다. 클래스 역할을 function 키워드가 대신합니다. function 키워드로 클래스도, 함수도 선언하는 것입니다.

여기서 MyClass의 객체를 생성하려면 var myClassInstance = new MyClass();와 같이 하면 됩니다.

그럼 MyClass에 상태와 행동을 넣어 보겠습니다.

function MyClass() {
var myPrivateAttr1 = 1;
var myPrivateAttr2 = 2;
function myPrivateFnc1 () {
return myPrivateAttr1;
}
function myPrivateFnc2 () {
return myPrivateAttr2;
}
}

변수 2개와 함수 2개를 넣었는데, 모두 MyClass 외부에서는 사용할 수 없습니다. 즉 이들은 Private 속성과 함수 입니다. 그럼 Public 속성과 함수를 추가하는 방법을 보겠습니다.

function MyClass() {
var myPrivateAttr1 = 1;
var myPrivateAttr2 = 2;
function myPrivateFnc1 () {
return myPrivateAttr1;
}
function myPrivateFnc2 () {
return myPrivateAttr2;
}
var self = {
myPublicAttr1: 1,
myPublicAttr2: 2,
myPublicFnc1: function () {
return myPrivateFnc1();
},
myPublicFnc2: function () {
return myPrivateFnc2();
}
};
return self;
}

이렇게 하면 외부에서 self 변수 안에 들어 있는 속성과 함수들을 접근할 수 있게 됩니다. 즉 이들은 Public 속성과 함수들 입니다.

var myClassInstance = new MyClass();
console.log(myClassInstance.myPublicFnc1());

이렇게 하면 브라우저 콘솔에 1이 출력될 것입니다.

Github Pages와 Jekyll로 무료로 블로그 만들기

저는 Markdown으로 글을 작성하는 것을 선호합니다. 여러 이유가 있지만 크게 다음 3가지 이유 때문입니다.

  • 헤더, 리스트, 테이블, 링크, 이미지 등을 키보드만으로 쉽게 작성할 수 있습니다. 대다수의 WYSWYG 에디터에서는 마우스를 많이 쓰게 되서 불편했습니다.
  • 스타일을 신경쓰지 않아도 됩니다. Markdown을 HTML로 변환해 주는 엔진에서 알아서 스타일을 맞춰줍니다.
  • 소스코드를 언어에 맞게 하이라이팅하기가 쉽습니다. 프로그래밍 관련 글을 많이 쓰는 저로서는 중요한 사항 입니다.

Markdown으로 작성한 글을 웹 상에 올리는데 Jekyll을 최근 많이 사용하는 것 같습니다. Jekyll은 정적 (Static) 웹사이트를 만들어 주는 도구이고 Markdown을 HTML로 변환해 줍니다.

이제 Jekyll로 만든 블로그를 어디에 올려서 운영하느냐의 문제가 남았습니다. 호스팅 업체에서 유료로 할 수도 있지만 돈을 쓰고 싶지가 않습니다. 가입, 신청, 관리 등의 번거로움도 달갑지 않습니다.

그래서 Github Pages로 블로그를 만들기로 한 것입니다. Github Pages는 무료로 웹페이지를 호스팅해 줍니다. {사용자이름}.github.io와 같이 도메인까지 무료로 제공해 줍니다. 게다가 Github Pages는 Jekyll을 내장하고 있어서 파일만 올리면 알아서 사이트를 빌드해 줍니다.

먼저 Github에서 리파지토리를 하나 만듭니다. 리파지토리 이름을 {사용자이름}.github.io로 정해 주세요.

이제 블로그 파일을 준비합니다. Jekyll을 설치하여 빈 (Empty) 블로그를 만들고 하나하나 만들어갈 수도 있지만 Jekyll도 설치하기가 싫어서 저는 템플릿을 다운받아서 수정하여 사용했습니다. Jekyll의 기본 템플릿은 minima 입니다.

주로 수정해야 하는 파일들은 _config.yml과 _posts 내의 파일들 입니다. _config.yml파일에서는 title, author, email, description, url 등을 수정해 주어야 합니다.

이렇게 준비한 파일을 전에 만든 리파지토리에 올려줍니다. 준비한 블로그 폴더로 이동하고 다음과 같이 파일들을 올려줍니다.

$ git init
$ git remote add origin https://github.com/{사용자이름}/{사용자이름}.github.io
$ git add *
$ git commit -m "first commit"
$ git push -u origin master

이제 Github Pages가 사이트를 빌드하기를 조금 기다리고 브라우저에서 https://{사용자이름}.github.io로 접속하면 블로그가 나타납니다.

파이썬으로 URL 파싱하기

파이썬에서 URL을 파싱할 때 주로 파이썬 자체 모듈인 urllib을 사용합니다.

LG전자 채용 사이트인 http://apply.lg.com/main/Intro.rpi을 파싱 해보겠습니다.

from urllib import parse
parse.urlparse('http://apply.lg.com/main/Intro.rpi')
ParseResult(scheme='http', netloc='apply.lg.com', path='/main/Intro.rpi', params='', query='', fragment='')

출력을 보니까 netloc (hostname)이 apply.lg.com 입니다.

이는 sub-domain, domain, top-level domain (TLD)를 모두 포함하고 있습니다.

여기서 domain과 TLD만 가져오려면 어떻게 하면 될까요? 간단하지 않습니다. sub-domain의 개수도 여러개가 될 수 있고, TLD도 여러 요소로 구성될 수 있기 때문입니다.

예를 들어서, TLD는 com, co.kr, edu, ac.kr 등 다양합니다.

그래서 TLD 목록을 가지고 있어야 정확한 파싱이 가능할 것 같습니다.

tldextract을 사용하면 sub-domain, domain, TLD를 구분할 수 있습니다.

먼저 tldextract을 설치 합니다.

pip install tldextract
import tldextract
tldextract.extract('http://apply.lg.com/main/Intro.rpi')
ExtractResult(subdomain='apply', domain='lg', suffix='com')

이제 doamin + TLD를 쉽게 만들 수 있습니다.

url_comps = tldextract.extract('http://apply.lg.com/main/Intro.rpi')
"{}.{}".format(url_comps.domain, url_comps.suffix)
'lg.com'

파이썬으로 BM25와 BM25F 구현하기

이 포스트에서는 정보 검색 (Information Retrieval) 분야에서 빼 놓을 수 없는 BM25, BM25Simple, BM25F를 파이썬으로 구현해 봅니다. 검색 엔진을 구현해보고자 하는 것이 아니라 BM25, BM25FSimple, BM25F에 대해 코드레벨에서 이해해 보고자 하는 것입니다. 이론은 Okapi BM25에서 확인하세요.

먼저 문서를 준비합니다. 여기서는 몇몇 뉴스기사를 직접 긁어왔습니다. 글이 너무 길어지기 때문에 별도의 파일로 참조합니다.

몇몇 뉴스 기사로 정의한 문서

BM25F의 경우 섹션을 나눠줘야 하는데, 여기서는 간단하게 title, body로 두 개의 섹션을 고려합니다. 다음 코드는 정규식으로 특수문자를 제거하고 BM25를 위한 문서와 BM25F를 적용하기 위한 문서 데이터를 준비합니다.

import re
docs_bm25 = [re.sub('([^a-zA-Z0-9ㄱ-ㅣ가-힣\s])+',' ', doc).split() for doc in docs_bm25_raw]
docs_bm25f = [re.sub('([^a-zA-Z0-9ㄱ-ㅣ가-힣\s])+',' ', doc).split('\n') for doc in docs_bm25_raw]
docs_bm25f = [[title.split(), body.split()] for title, body in docs_bm25f]

다음 코드는 BM25 클래스 입니다.

from functools import reduce
from collections import defaultdict
import numpy as np
import pandas as pd
class BM25:
def __init__(self, docs):
self.docs = docs # array of term vectors
self.N = 10000 # len(self.docs)
self.avdl = reduce(lambda dl1, dl2: dl1 + dl2, map(lambda d: len(d), self.docs)) / len(self.docs)
def rank(self, q, b=0.5, k=2):
# initialize
B_d = [] # B constant for docs
tf_q = [[] for _ in range(len(q))] # term frequency vector of docs for query terms
n_q = [0] * len(q) # doc frequency vectors for query terms
for idx_d, d in enumerate(self.docs):
# provision
d = np.array(d)
# document length and B
dl = len(d)
B_d.append((1-b) / (b * (dl / self.avdl)))
# term frequency
for idx_q, queryterm in enumerate(q):
d_query_included = np.core.defchararray.find(d, queryterm)
tf_queryterm = len(d_query_included[d_query_included != -1])
tf_q[idx_q].append(tf_queryterm)
# updating n
if tf_queryterm > 0:
n_q[idx_q] += 1
# tf normalization
tf_q = np.array(tf_q)
B_d = np.array(B_d)
tf_q_norm = tf_q / B_d.reshape((1,len(B_d))).repeat(len(q), axis=0)
# inverse document frequency
n_q = np.array(n_q)
idf_q = np.log((self.N - n_q + .5) / (n_q + .5))
# weight
w_q = (tf_q_norm / (k + tf_q_norm)) * idf_q.reshape((len(q), 1)).repeat(len(self.docs), axis=1)
w = w_q.sum(axis=0)
docidx_ranked = w.argsort(axis=0)
# result as data frame
df_result = pd.DataFrame(columns=['docid', 'w', 'doc'], data={
'docid': list(range(1, len(self.docs)+1)),
'w': w,
'doc': self.docs
})
return df_result.sort_values(by='w')[::-1].reset_index(drop=True)

다음은 BM25FSimple 클래스 코드 입니다.

from functools import reduce
from collections import defaultdict
import numpy as np
import pandas as pd
class BM25FSimple:
def __init__(self, docs, v):
self.docs = docs # array of field term vectors
self.v = v # stream weight
self.N = 10000 # len(self.docs)
# calculate avdl after flattening self.docs
self.avdl = reduce(lambda dl1, dl2: dl1 + dl2, map(lambda d: len(d), np.array(self.docs).flatten())) / len(self.docs)
def rank(self, q, b=0.5, k=2):
# initialize
B_d = [] # B constant for docs
tf_q = [[] for _ in range(len(q))] # term frequency vector of docs for query terms
n_q = [0] * len(q) # doc frequency vectors for query terms
for idx_d, d in enumerate(self.docs):
dl = 0
tf_queryterm = 0
for stream, stream_weight in zip(d, self.v):
# provision
stream = np.array(stream)
# document length
dl += len(stream) * stream_weight
# term frequency
for idx_q, queryterm in enumerate(q):
tf_queryterm = 0
for stream, stream_weight in zip(d, self.v):
stream_query_included = np.core.defchararray.find(stream, queryterm)
tf_queryterm += len(stream_query_included[stream_query_included != -1]) * stream_weight
tf_q[idx_q].append(tf_queryterm)
# updating n
if tf_queryterm > 0:
n_q[idx_q] += 1
# B; sum of length of streams
B_d.append((1-b) / (b * (dl / self.avdl)))
# tf normalization
tf_q = np.array(tf_q)
B_d = np.array(B_d)
tf_q_norm = tf_q / B_d.reshape((1,len(B_d)))
# inverse document frequency
n_q = np.array(n_q)
idf_q = np.log((self.N - n_q + .5) / (n_q + .5))
# weight
w_q = (tf_q_norm / (k + tf_q_norm)) * idf_q.reshape((len(q), 1))
w = w_q.sum(axis=0)
docidx_ranked = w.argsort(axis=0)
# result as data frame
df_result = pd.DataFrame(columns=['docid', 'w', 'doc'], data={
'docid': list(range(1, len(self.docs)+1)),
'w': w,
'doc': self.docs
})
return df_result.sort_values(by='w')[::-1].reset_index(drop=True)

다음 코드는 BM25F 클래스 코드 입니다.

from functools import reduce
from collections import defaultdict
import numpy as np
import pandas as pd
class BM25F:
def __init__(self, docs, v):
if len(docs) == 0:
print("Error. Empty document list.")
return
self.docs = docs # array of field term vectors
self.v = v # stream weight
self.N = 10000 # len(self.docs)
arr_docs = np.array(self.docs)
self.avsl = []
for stream_idx in range(arr_docs.shape[1]):
self.avsl.append(reduce(lambda sl1, sl2: sl1 + sl2, map(lambda s: len(s), arr_docs[:, stream_idx])) / len(self.docs))
def rank(self, q, b=.5, k=2):
if type(b) is not list:
b = [b] * len(self.docs[0])
# initialize
B_d = [] # B constant for docs
tf_q = [[] for _ in range(len(q))] # term frequency vector of docs for query terms
n_q = [0] * len(q) # doc frequency vectors for query terms
for idx_d, d in enumerate(self.docs):
B_s = []
tf_queryterm = 0
tf_stream = []
# initialize tf
for idx_q in range(len(q)):
tf_q[idx_q].append(0)
for stream, stream_weight, avsl, b_s in zip(d, self.v, self.avsl, b):
# provision
stream = np.array(stream)
# document length
sl = len(stream)
# B
B = (1-b_s) / (b_s * (sl / avsl))
# term frequency per stream
for idx_q, queryterm in enumerate(q):
stream_query_included = np.core.defchararray.find(stream, queryterm)
tf_queryterm_stream = len(stream_query_included[stream_query_included != -1]) * stream_weight / B
tf_q[idx_q][-1] += tf_queryterm_stream # add tf of the stream
# update document frequency
for idx_q, queryterm in enumerate(q):
if tf_q[idx_q][-1] > 0:
n_q[idx_q] += 1
# tf normalization
tf_q = np.array(tf_q)
# inverse document frequency
n_q = np.array(n_q)
idf_q = np.log((self.N - n_q + .5) / (n_q + .5))
# weight
w_q = (tf_q / (k + tf_q)) * idf_q.reshape((len(q), 1))
w = w_q.sum(axis=0)
docidx_ranked = w.argsort(axis=0)
# result as data frame
df_result = pd.DataFrame(columns=['docid', 'w', 'doc'], data={
'docid': list(range(1, len(self.docs)+1)),
'w': w,
'doc': self.docs
})
return df_result.sort_values(by='w')[::-1].reset_index(drop=True)

이제 몇몇 질의에 대한 랭킹을 해봅니다.

bm25 = BM25(docs_bm25)
bm25f_simple = BM25FSimple(docs_bm25f, [3, 1])
bm25f = BM25F(docs_bm25f, [3, 1])
q_list = [
['네이버'],
['네이버', '웹툰'],
['네이버', '후원'],
['네이버', '웹툰', '후원'],
['대통령'],
['총리'],
['대통령', '총리'],
['네이버', '문재인', '대통령']
]
df_result_list = []
for q in q_list:
df_result_list.append([bm25.rank(q), bm25f_simple.rank(q), bm25f.rank(q)])

이제 Term Frequency (TF)를 계산해 봅니다.

df_result_combined_list = []
for df_result in df_result_list:
df_result_combined_list.append(
pd.DataFrame(columns=['docid', 'w_bm25', 'w_bm25f_simple', 'w_bm25f'], data={
'docid': df_result[0].sort_values(by='docid').set_index('docid').index.values,
'w_bm25': df_result[0].sort_values(by='docid').set_index('docid')['w'],
'w_bm25f_simple': df_result[1].sort_values(by='docid').set_index('docid')['w'],
'w_bm25f': df_result[2].sort_values(by='docid').set_index('docid')['w']
})
)

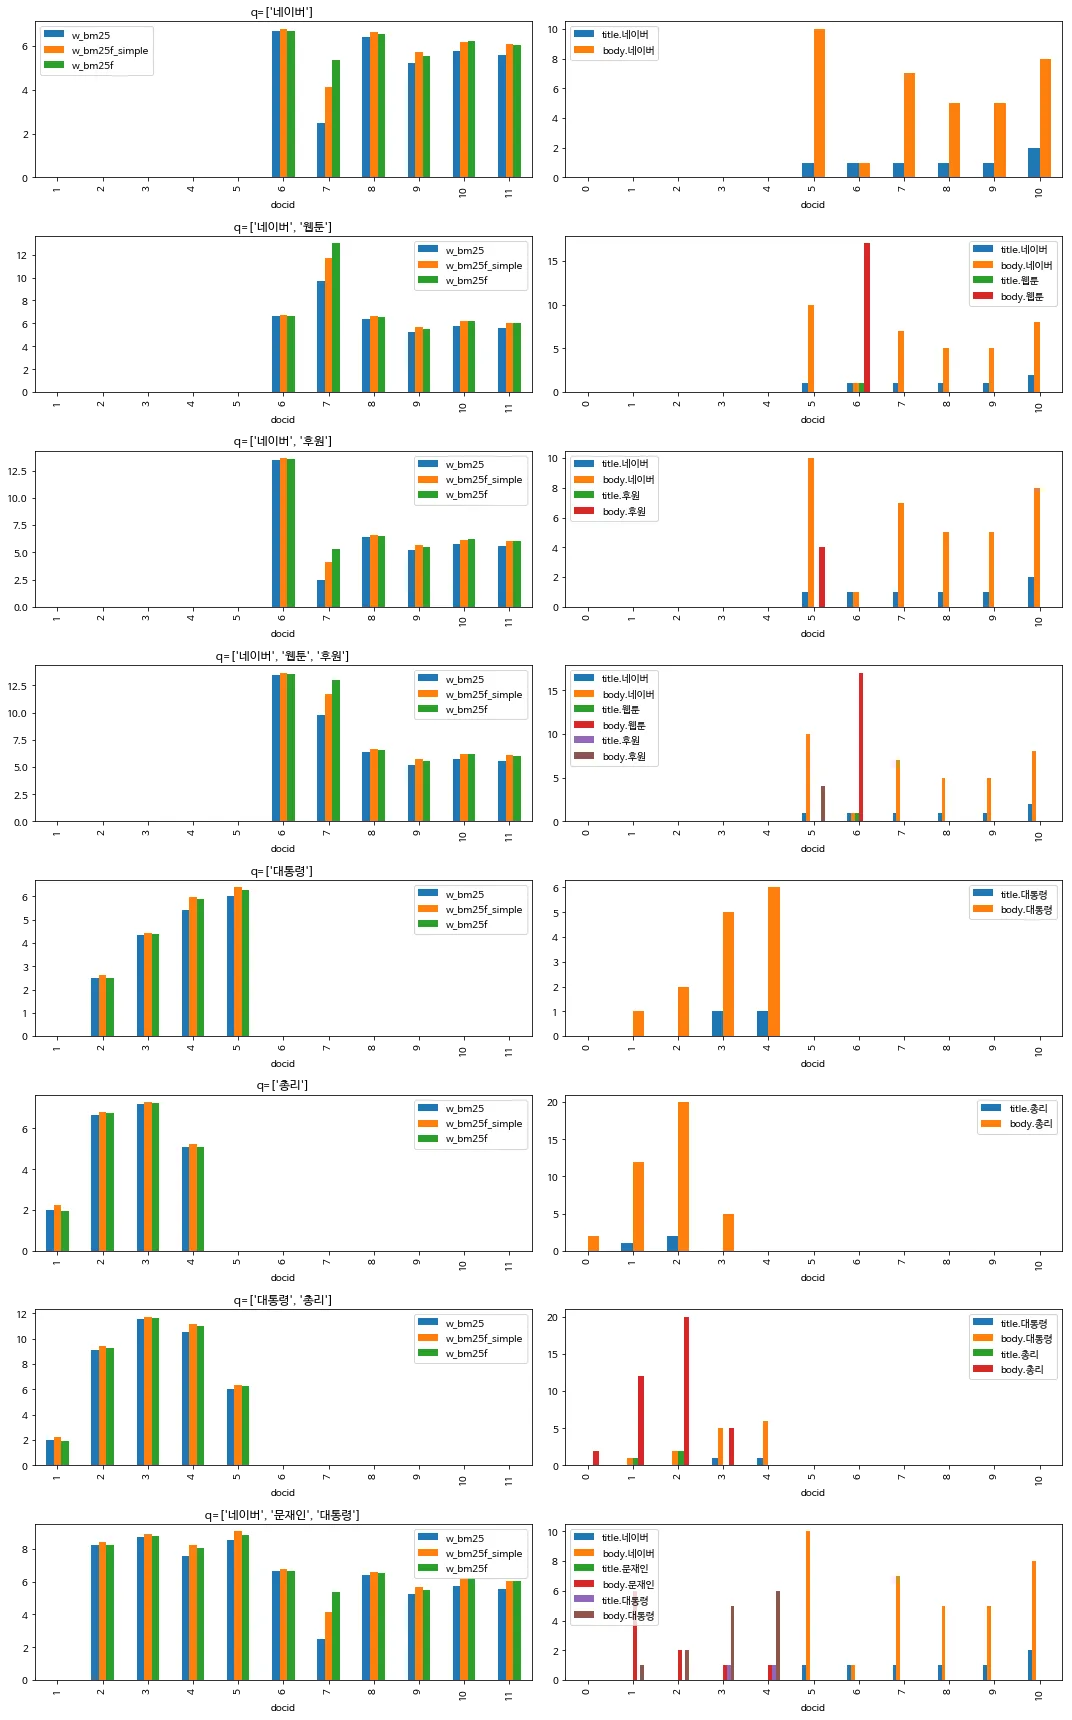
이제 계산한 BM25, BM25FSimple, BM25F 값과 TF를 가시화 합니다.

dflist_query_tf = []
for q in q_list:
df_query_tf = pd.DataFrame()
df_query_tf['docid'] = list(range(len(docs_bm25f)))
df_query_tf = df_query_tf.set_index('docid')
for queryterm in q:
title_tf = []
body_tf = []
for title, body in docs_bm25f:
title = np.array(title)
body = np.array(body)
title_query_included = np.core.defchararray.find(title, queryterm)
body_query_included = np.core.defchararray.find(body, queryterm)
title_tf.append(len(title_query_included[title_query_included != -1]))
body_tf.append(len(body_query_included[body_query_included != -1]))
df_query_tf["title."+queryterm] = title_tf
df_query_tf["body."+queryterm] = body_tf
dflist_query_tf.append(df_query_tf)
import matplotlib
import matplotlib.pyplot as plt
import matplotlib.font_manager as fm
font_location = "/Library/Fonts/NanumBarunGothic.otf"
font_name = fm.FontProperties(fname=font_location).get_name()
matplotlib.rc('font', family=font_name)
%matplotlib inline
fig, axes = plt.subplots(nrows=len(q_list), ncols=2, figsize=(15, len(q_list)*3))
def plot(ax, df, title):
ax = df.sort_values(by='docid').set_index('docid').plot.bar(ax=ax, title=title)
for ax, df, q in zip(axes[:, 0], df_result_combined_list, q_list):
plot(ax, df, 'q=%s' % (q,))
for ax, df in zip(axes[:, 1], dflist_query_tf):
df.plot.bar(ax=ax)
fig.tight_layout()

가시화 결과입니다.

가시화 결과

Django에서 Jinja2를 Template Engine으로 사용하기

Django는 대표적인 Python 웹 프레임워크 입니다. 페이지 렌더링, ORM, Session 자체 Template Engine도 가지고 있지요.

그런데 개인적인 의견으로 Template Engine은 Jinja2가 더 강력한 것 같습니다. 다행히 Django에서 Jinja2도 지원을 하고 있습니다. 다만 약간의 추가적인 세팅이 필요하죠.

이 포스트에서 Django에서 Jinja2를 사용하는 방법을 차근차근 설명하고자 합니다.

우선 Jinja2를 설치합니다.

Terminal window
$ pip install Jinja2

Django 프로젝트의 settings.py 파일을 수정합니다.

TEMPLATES = [
{
'BACKEND': 'django.template.backends.jinja2.Jinja2',
'DIRS': [
'app/templates'
],
'APP_DIRS': True,
'OPTIONS': {
'extensions': [
'jinja2.ext.do',
'jinja2.ext.loopcontrols',
'jdj_tags.extensions.DjangoCompat',
],
},
},
{
'BACKEND': 'django.template.backends.django.DjangoTemplates',
'DIRS': [],
'APP_DIRS': True,
'OPTIONS': {
'context_processors': [
'django.template.context_processors.debug',
'django.template.context_processors.request',
'django.contrib.auth.context_processors.auth',
'django.contrib.messages.context_processors.messages',
],
},
},
]

여기서 Jinja2 부분의 OPTION/extensions에 Jinja2에서 기본 제공하는 확장 기능들을 추가할 수 있습니다. jinja2.ext.do와 jinja2.ext.loopcontrols는 Jinja2의 기본 확장 기능입니다. Jinja2 Extensions에서 다른 확장 기능들도 확인해 보세요. jdj_tags.extensions.DjangoCompat는 Django Template Engine이 제공하는 Template Tag들을 Jinja2 버전으로 만들어 놓은 커스텀 확장 기능입니다. 이걸 사용하기 위해서 pip install jinja2-django-tags로 모듈을 설치합니다.

이렇게 하면 이제 Jinja2를 Template Engine으로 사용하게 됩니다. 그런데 Jinja2에서는 Custom Filter를 기존 Django 방식으로 할 수 없습니다.

필터 함수들을 가지고 있는 모듈 filters.py를 다음과 같이 정의합니다.

""" filters.py
"""
from django.utils.http import urlquote
# collection
def filter_getitem(value, arg):
return value.get(arg, '')
def filter_getat(value, arg):
try:
return value[int(arg)]
except Exception as e:
return None
def filter_notinappend(a, b):
if b not in a:
a.append(b)
return a
def filter_union(a, b):
return set(a) | set(b)
# math
def filter_divide(value, arg):
return float(value) / float(arg)
def filter_mod(value, arg):
return int(value) % int(arg)
def filter_min(a, b):
return min(a, b)
def filter_max(a, b):
return max(a, b)
# converting
def filter_int(value):
return int(value)
# type
def filter_type(value):
return str(type(value))
# str
def filter_endswith(value, arg):
return value.endswith(arg)
def filter_quote(a):
return urlquote(a)

filters.py의 필터들을 추가하기 위해 settings.py에 다음과 같은 코드를 추가합니다.

jinja2.filters.FILTERS.update({
"getitem": filters.filter_getitem,
"getat": filters.filter_getat,
"notinappend": filters.filter_notinappend,
"union": filters.filter_union,
"divide": filters.filter_divide,
"mod": filters.filter_mod,
"min": filters.filter_min,
"max": filters.filter_max,
"int": filters.filter_int,
"type": filters.filter_type,
"endswith": filters.filter_endswith,
"quote": filters.filter_quote,
})

이렇게 하면 html에서 Jinja2 태그들 및 새롭게 추가한 Custom Filter들도 사용할 수 있습니다.

예를 들어서 다음 html 코드는

{% raw %}<input type="number" value="{{ -100|max(0) }}">{% endraw %}

추가한 max 필터를 거쳐서 <input type="number" value="0">이 되는 것입니다.

Google과 Naver에서 동시 검색하는 Chrome Extension 만들기

Google과 Naver를 동시에 검색해 보고 싶어 졌습니다. 처음에는 iframe으로 그냥 띄우면 되지 않을까 했는데 문제가 생겼습니다. Google과 Naver와 같이 X-Frame-Options가 DENY 또는 SAMEORIGIN으로 설정되어 있는 사이트는 iframe으로 띄울 수가 없습니다.

그래서 생각한 것이 Chrome Extension으로 만들어 보는 것이였습니다. Chrome Extension 개발의 기본적인 사항은 Getting Started: Building a Chrome Extension에서 확인하시면 됩니다.

코드는 간단합니다. 우선 HTML 코드 입니다.

<!DOCTYPE html>
<html>
<head>
<meta charset="UTF-8">
<title>Google과 Naver 동시 검색 확장앱</title>
<link rel="stylesheet" type="text/css" href="lib/bootstrap-4.0.0-beta/css/bootstrap.css">
<link rel="stylesheet" type="text/css" href="lib/font-awesome-4.7.0/css/font-awesome.min.css">
<link rel="stylesheet" href="browser.css">
<script type="text/javascript" src="lib/jquery-3.2.1.min.js"></script>
<script type="text/javascript" src="lib/popper.min.js"></script>
<script type="text/javascript" src="lib/bootstrap-4.0.0-beta/js/bootstrap.min.js"></script>
<script src="browser.js"></script>
</head>
<body>
<div id="layout_srch">
<div class="row">
<div class="col">
<a id="a_back_g" href="#"><i class="fa fa-arrow-left my-control" aria-hidden="true"></i></a>
</div>
<div class="col-10">
<form id="form_srch" class="form-inline">
<div id="dv_srch" class="form-group">
<input id="inp_query" class="form-control mr-2" value="">
<button id="btn_srch" class="btn btn-success">
<i class="fa fa-search" aria-hidden="true"></i>
</button>
</div>
<div class="form-check mb-2 mr-sm-2 mb-sm-0">
<label class="form-check-label">
<input id="ckb_mode" type="checkbox" class="form-check-input">
모바일 모드
</label>
</div>
</form>
</div>
<div class="col">
<a id="a_back_n" href="#"><i class="fa fa-arrow-left my-control" aria-hidden="true" style="float: right"></i></a>
</div>
</div>
</div>
<webview id="ifr_g" src="https://www.google.co.kr/search?q="></webview>
<webview id="ifr_n" src="https://search.naver.com"></webview>
</body>
</html>

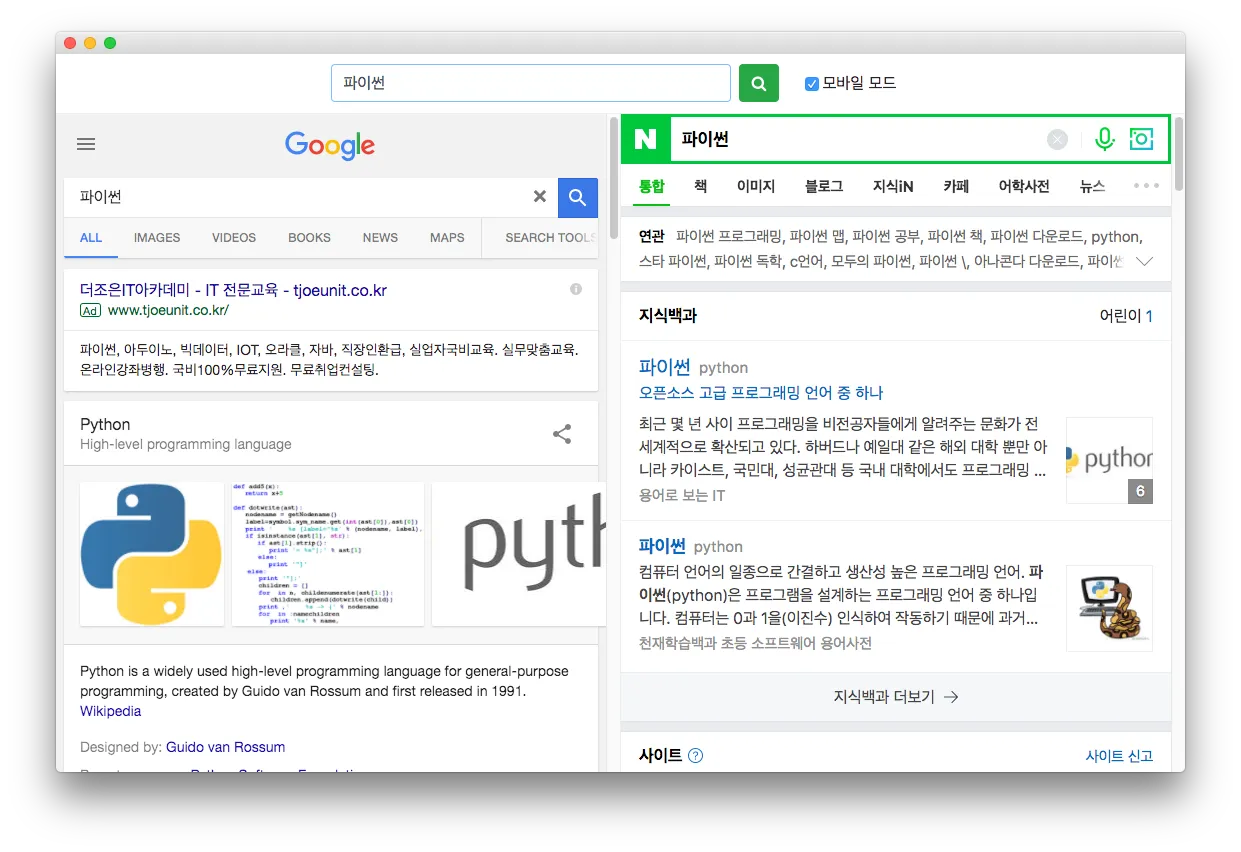
상단에 검색 폼을 두고 왼쪽에는 구글 웹뷰, 오른쪽에는 네이버 웹뷰를 두었습니다.

상단의 검색 폼에서 질의를 입력하고 검색 버튼을 누르면 이 두 웹뷰를 각 URL에 질의를 추가하여 다시 로딩합니다. 이를 위한 JavaScript 코드는 다음과 같습니다.

$(function() {
var webview_g = $('#ifr_g');
var webview_n = $('#ifr_n');
var version = navigator.appVersion.substr(navigator.appVersion.lastIndexOf('Chrome/') + 7);
var match = /([0-9]*)\.([0-9]*)\.([0-9]*)\.([0-9]*)/.exec(version);
var majorVersion = parseInt(match[1]);
var buildVersion = parseInt(match[3]);
var AGENT_PC = webview_g.get(0).getUserAgent();
var AGENT_MOBILE = "Mozilla/5.0 (Linux; Android 7.0; SM-G930V Build/NRD90M) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/59.0.3071.125 Mobile Safari/537.36";
function search() {
var query = $('#inp_query').val();
webview_g.attr('src', "https://www.google.co.kr/search?q="+query);
webview_n.attr('src', "https://search.naver.com/search.naver?query="+query);
}
$('#btn_srch').click(search);
$('#inp_query').keypress(function(event) {
if (event.which == 13) {
document.querySelector('#btn_srch').click();
event.preventDefault();
}
});
$('#ckb_mode').change(function () {
var checked = $(this).prop('checked');
if (checked) {
webview_g.get(0).setUserAgentOverride(AGENT_MOBILE);
webview_n.get(0).setUserAgentOverride(AGENT_MOBILE);
} else {
webview_g.get(0).setUserAgentOverride(AGENT_PC);
webview_n.get(0).setUserAgentOverride(AGENT_PC);
}
search();
});
function adjust_height() {
var height = window.innerHeight - 60;
webview_g.css('height', height);
webview_n.css('height', height);
}
adjust_height();
window.onresize = adjust_height;
});

여기서 주의할 점은 웹뷰의 에이전트를 잘 정해줘야 한다는 것입니다. 에이전트가 잘 정의되어 있지 않으면 (구글, 네이버가 막아놔서) 검색이 되지 않을 수도 있습니다.

추가로 CSS도 공유합니다.

body {
margin: 0;
padding: 0;
min-width: 800px;
}
#layout_srch {
position: fixed;
top:0px;
right:0px;
left:0px;
height: 60px;
border-bottom: 1px solid #eee;
}
#layout_srch .my-control {
color: #fff;
margin: 10px;
padding: 10px;
}
#form_srch {
margin: 0px auto;
width: 600px;
padding: 10px;
}
#inp_query {
width: 400px;
}
#lb_mode {
color: #fff;
}
#dv_srch {
width: 80%;
margin-right: 10px;
}
#ifr_g {
position: fixed;
right: 50%;
top: 60px;
bottom: 0px;
width: 50%;
}
#ifr_n {
position: fixed;
right: 0px;
left: 50%;
top: 60px;
bottom: 0px;
width: 50%;
}

결과는 다음과 같습니다.

결과

프로젝트 파일 첨부합니다. 다운로드

Pandas DataFrame을 엑셀 파일로 내보내기

한글을 포함하는 Pandas DataFrame을 csv 파일로 변환할 상황이 생겼습니다.

import pandas as pd
df = pd.DataFrame()
# ...
df.to_csv('out.csv', encoding='utf-8')

이렇게 인코딩까지 지정하면 한글이 깨지지 않을 것이라 기대했는데… 깨집니다. 안깨지게 하려면 csv가 아니라 excel 파일로 변환하면 됩니다.

df.to_excel('out.xlsx', sheet_name='sheet1')

긴 URL이 있으면 워닝 (UserWarning: Ignoring URL)이 뜨는데, 아래와 같이 해결할 수 있습니다.

writer = pd.ExcelWriter('out.xlsx', engine='xlsxwriter', options={'strings_to_urls': False})
df.to_excel(writer)

Matplotlib 라인차트

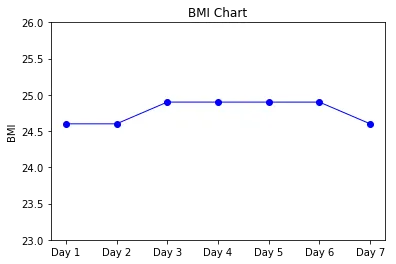
Python에서 초간단 라인차트를 그려보겠습니다. 누군가가 일주일 동안 BMI를 측정해보았다고 치고, 아래 코드는 x축을 날짜, y축을 BMI 값으로 가지는 차트를 그립니다.

import matplotlib.pyplot as plt
bmi = [24.6, 24.6, 24.9, 24.9, 24.9 ,24.9, 24.6]
plt.title("BMI Chart")
plt.ylabel("BMI")
plt.xticks(range(1, 8), ["Day 1", "Day 2", "Day 3", "Day 4", "Day 5", "Day 6", "Day 7"], fontsize=10)
plt.plot(range(1, 8), bmi, "o-", color="b", linewidth=1)
plt.ylim([23, 26])
plt.show()

title을 정하고, y축 레이블을 정하고, x축에 표시할 값들을 정해주고, 데이터를 뿌린다. 이 때, 값들을 점으로 표시하고 선으로 연결하도록 “o-” 옵션을 주고, 색깔을 blue로 하고, 선 굵기를 1로 했습니다. y축의 범위를 [23, 26]으로 정해서 선차트 위아래 어느정도 공간을 주고, show!

차트

Python에서 시간 값 변환

개발을 하다보면 시간 값을 자주 다루게 되는데, Python에서 datetime, timestamp (숫자), 문자열 시간 간의 변환하는 간단한 코드를 정리했습니다.

우선 시간 관련 값들을 처리하기 위해 다음 두 모듈을 임포트 합니다.

import datetime
import time
dt = datetime.datetime(2010, 2, 25, 23, 23)
ts = time.mktime(dt.timetuple())
dt, ts
(datetime.datetime(2010, 2, 25, 23, 23), 1267107780.0)
ts = 1284101485
dt = datetime.datetime.fromtimestamp(ts)
ts, dt
(1284101485, datetime.datetime(2010, 9, 10, 15, 51, 25))
dt = datetime.datetime(2010, 2, 25, 23, 23)
str_time = dt.strftime('%Y-%m-%d %H:%M:%S')
dt, str_time
(datetime.datetime(2010, 2, 25, 23, 23), '2010-02-25 23:23:00')
str_time = '2010-02-25 23:23:00'
dt = datetime.datetime.strptime(str_time, "%Y-%m-%d %H:%M:%S")
str_time, dt
('2010-02-25 23:23:00', datetime.datetime(2010, 2, 25, 23, 23))