콘텐츠로 이동
6 posts with the tag “백테스트”

수정주가와 원주가의 차이: 금융 데이터 분석과 백테스트의 필수 기초
수정주가와 원주가 개념 시각화

과거 주가 차트를 열어보았을 때, 2018년 이전 삼성전자의 주가가 5만 원대로 표시되어 의아했던 적이 있으신가요? 당시 신문 기사에서는 1주에 250만 원이 훌쩍 넘는 대표적인 ‘황제주’로 불렸는데 말입니다.

금융 데이터 분석이나 퀀트 백테스트를 처음 시작할 때 가장 흔하게 마주치는 혼란 중 하나가 바로 원주가(수정 전 주가, Unadjusted / Raw Price)와 수정주가(Adjusted Stock Price)의 구분입니다. 겉보기에는 단순한 가격 표기 방식의 차이처럼 보이지만, 이를 제대로 이해하지 못하고 백테스트나 분석 모델에 원주가를 그대로 넣으면 하루아침에 -80% 폭락이 발생한 것으로 인식되거나 모델의 가중치가 통째로 왜곡되는 치명적인 오류가 발생합니다.

이번 글에서는 원주가와 수정주가의 개념, 자본 변동 이벤트별 보정 메커니즘, 그리고 데이터 분석 및 백테스트 실무에서 반드시 확인해야 할 주의점을 정리합니다.


1. 원주가(Unadjusted Price)란 무엇인가?

섹션 제목: “1. 원주가(Unadjusted Price)란 무엇인가?”

원주가(수정 전 주가)는 해당 거래일 당시 한국거래소(KRX) 등 시장에서 실제로 체결되고 거래장에 공식 기록되었던 액면 그대로의 가격(Nominal / Raw Price)을 뜻합니다.

  • 실제 거래 체결 증명: 매매 당일 투자자가 지불한 실제 금액과 계좌 잔고 증명의 기준입니다.
  • 역사적 시가총액 계산: 과거 특정 시점의 기업 규모를 측정할 때 당시의 실제 상장주식수와 원주가를 곱해 계산합니다. 시가총액원주가실제발행주식수
  • 호가 단위(Tick Size) 및 최소 주문 금액 파악: 당시 시장 참여자가 직면했던 실제 호가 단위와 진입 장벽을 복원할 때 필요합니다.

원주가의 한계: 시계열의 인위적 단절

섹션 제목: “원주가의 한계: 시계열의 인위적 단절”

원주가만으로 장기 시계열을 분석하면 심각한 문제가 발생합니다. 기업이 액면분할, 액면병합, 무상증자, 유상증자, 감자 등 자본 변동을 단행할 때마다 주가 시계열에 급격한 갭(Gap)과 단절이 발생하기 때문입니다.

예를 들어 주가가 250만 원이던 주식이 50:1 액면분할을 하면 다음 날 아침 주가는 5만 원으로 시작합니다. 회사의 본질 가치나 주주의 자산 총액은 변함이 없는데, 원주가 시계열만 보면 하루 만에 주가가 98% 폭락한 것처럼 보이게 됩니다.


2. 수정주가(Adjusted Stock Price)란 무엇인가?

섹션 제목: “2. 수정주가(Adjusted Stock Price)란 무엇인가?”

수정주가는 액면분할, 증자, 배당 등 주주 가치의 실질적 변화가 없는 자본 변동 이벤트로 인해 발생하는 주가의 불연속성을 제거하기 위해, 과거 주가를 현재 가치 기준에 맞춰 소급 조정한 가격입니다.

수정주가가 반드시 필요한 이유

섹션 제목: “수정주가가 반드시 필요한 이유”
  1. 연속적인 수익률 계산: 주가 수익률은 연속된 두 거래일의 가격 비율로 정의됩니다. 수정주가를 사용해야 자본 변동 이벤트 발생일에도 왜곡 없는 정상적인 일일 수익률()을 얻을 수 있습니다.
  2. 기술적 지표의 유효성 유지: 20일 이동평균선, 볼린저 밴드, RSI, MACD 등 대부분의 기술적 분석 지표는 과거 가격 데이터의 연속성을 전제로 합니다. 원주가를 사용하면 50:1 액면분할이 발생한 날 이후 한 달 동안 이동평균선이 완전히 무너집니다.
  3. 머신러닝·통계 모델의 정상성(Stationarity): 시계열 예측 모델에 가격 데이터를 입력할 때 불필요한 충격(Outlier)을 배제하고 연속적인 패턴을 학습시킬 수 있습니다.

수정 방식의 표준: 후방 수정(Backward Adjustment)

섹션 제목: “수정 방식의 표준: 후방 수정(Backward Adjustment)”

금융 데이터 플랫폼(네이버 증권, Yahoo Finance, 인베스팅닷컴 등)과 증권사 HTS는 대부분 후방 수정(Backward Adjustment)을 표준으로 사용합니다. 즉, 현재 시점의 주가를 그대로 두고, 과거의 주가들을 분할·증자 비율에 맞춰 하향 조정(할인)하는 방식입니다.

과거 250만 원이던 삼성전자 주가가 오늘날 5만 원대로 표시되는 이유가 바로 현재 유통되는 1주 가치에 맞춰 과거 주가를 50분의 1로 환산했기 때문입니다.


3. 시각 자료로 보는 원주가와 수정주가의 차이

섹션 제목: “3. 시각 자료로 보는 원주가와 수정주가의 차이”

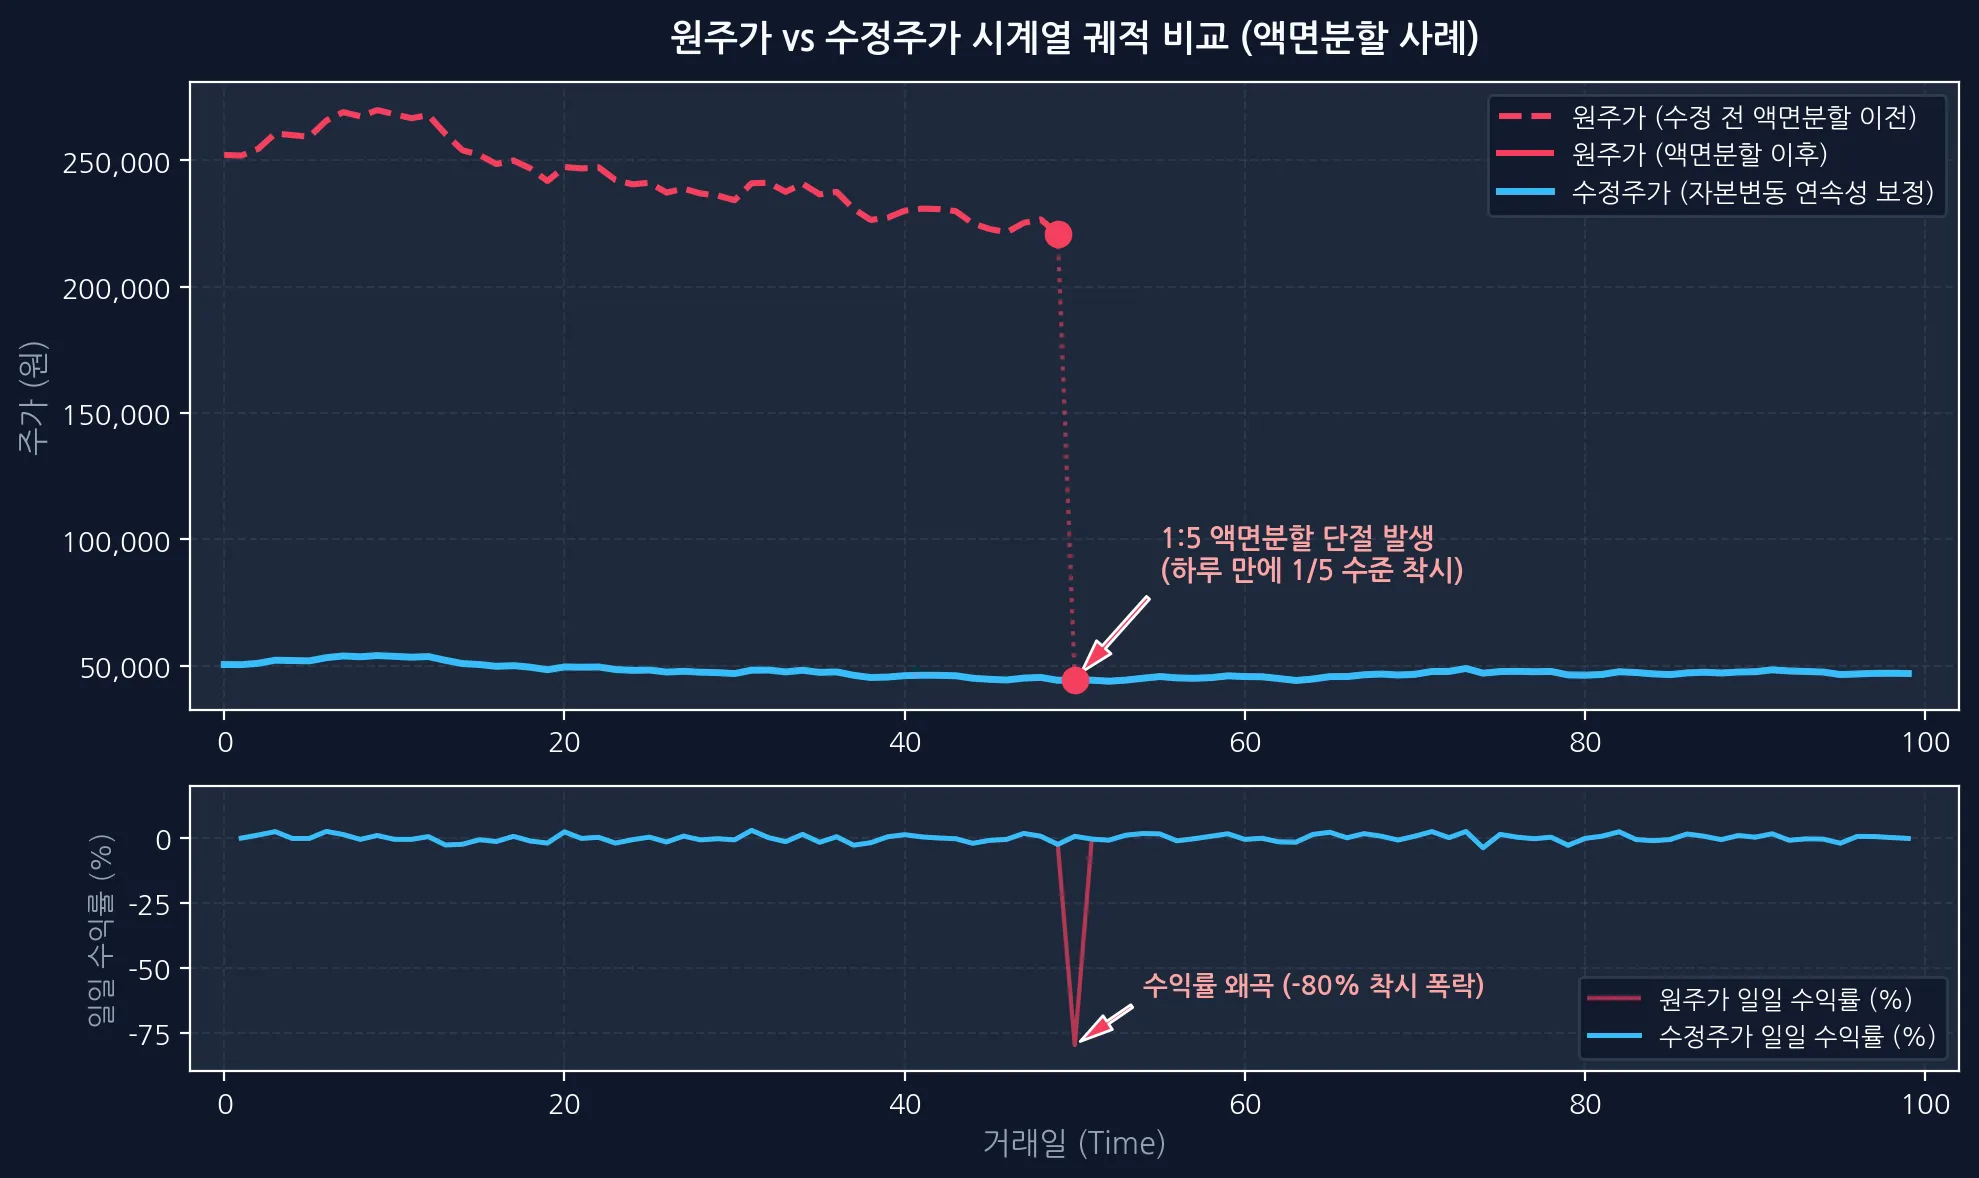
실제 주식 시장에서 액면분할이 발생했을 때 원주가와 수정주가가 어떻게 다르게 나타나는지 아래 차트를 통해 한눈에 비교할 수 있습니다.
원주가 vs 수정주가 시계열 및 수익률 비교

상단 그래프를 보면, 거래일 50일 차에 1:5 액면분할이 발생했을 때 원주가(붉은 점선)는 하루 만에 25만 원 수준에서 5만 원 수준으로 수직 낙하합니다. 반면 수정주가(하늘색 실선)는 분할 이전의 가격을 모두 1/5로 소급 적용하여 매끄럽고 연속적인 상승 흐름을 온전히 보존합니다.

하단 일일 수익률 그래프를 보면 차이는 더 극명합니다. 원주가로 계산한 일일 수익률은 분할 당일 -80% 폭락이라는 치명적인 아티팩트(Artifact)를 만들어내며, 이는 백테스트 알고리즘을 즉시 망가뜨리는 원인이 됩니다.


4. 자본 변동 이벤트별 수정 메커니즘

섹션 제목: “4. 자본 변동 이벤트별 수정 메커니즘”

수정주가가 계산되는 대표적인 이벤트와 보정 원리는 다음과 같습니다.

  • 액면분할 (1:N): 주식 액면가를 쪼개 유통 주식 수를 늘립니다. 분할 비율 만큼 과거 주가를 모두 로 나눕니다.
  • 액면병합 (N:1): 여러 주식을 하나로 합쳐 주가를 높입니다. 과거 주가를 모두 배로 곱합니다.

회사의 잉여금을 자본금으로 전입하여 주주들에게 대가 없이 신주를 발행합니다. 예를 들어 1주당 1주의 신주를 배정(100% 무상증자)하면 권리락일 주가는 50% 수준으로 조정되므로, 권리락 이전의 과거 주가를 0.5배로 보정합니다.

신주를 발행해 자금을 조달할 때 통상 기존 주가보다 할인된 가격(할인율 10~30%)으로 발행합니다. 이때 발생하는 권리락 기준가와 직전 종가의 비율을 바탕으로 수정계수(Adjustment Factor)를 산출하여 과거 주가에 곱해줍니다.

배당락일에는 배당금 지급 가치만큼 주가가 이론적으로 하락합니다.

  • 가격 수정주가 (Price Return Adjusted): 배당락은 보정하지 않고 분할/증자만 보정합니다. 일반적인 주가 차트에서 흔히 보는 형태입니다.
  • 총수익 수정주가 (Total Return Adjusted): 배당금을 당일 종가로 전액 재투자했다고 가정한 수정주가입니다. ETF의 분배금 재투자 성과나 장기 복리 백테스트에서 사용됩니다.

5. 원주가 vs 수정주가 핵심 비교

섹션 제목: “5. 원주가 vs 수정주가 핵심 비교”
비교 항목원주가 (Unadjusted Price)수정주가 (Adjusted Price)
정의거래 당일 시장에서 실제 체결된 명목 가격자본 변동 이벤트를 소급 보정한 연속 가격
시계열 연속성단절 발생 (분할·증자 시 급격한 갭)완벽한 연속성 유지
수익률 계산자본 변동일 왜곡 발생 (사용 부적합)장기 시계열 및 연속 수익률 계산에 필수
기술적 지표 산출이동평균선, RSI 등 지표 왜곡정상적인 지표 계산 가능
실제 체결가 일치 여부일치 (당시 거래 영수증과 동일)불일치 (소급 할인된 가상 가격)
주요 활용처체결 확인, 잔고 평가, 역사적 시가총액 산출백테스트, 퀀트 모델링, 차트 분석, 머신러닝

6. 실무 데이터 분석에서 흔히 저지르는 3대 함정

섹션 제목: “6. 실무 데이터 분석에서 흔히 저지르는 3대 함정”

데이터 파이프라인을 구축하거나 퀀트 백테스트 코드를 작성할 때 자주 마주치는 실무 함정들을 짚어보겠습니다.

함정 1: 주가는 수정주가를 쓰면서, 거래량(Volume)은 원데이터를 쓰는 경우

섹션 제목: “함정 1: 주가는 수정주가를 쓰면서, 거래량(Volume)은 원데이터를 쓰는 경우”

가장 흔하면서도 알아채기 힘든 실수입니다. 50:1 액면분할이 일어나면 주가는 50분의 1로 내려가지만, 시장에서 거래되는 주식 수(거래량)는 대략 50배로 늘어납니다.

주가만 수정주가로 바꾸고 거래량을 그대로 두면, 분할 이전의 거래량은 극도로 적고 분할 이후의 거래량만 폭증한 것처럼 왜곡됩니다. 이 상태로 거래량 이동평균이나 OBV(On Balance Volume), 유동성 필터를 계산하면 과거 구간의 거래량 신호가 전부 무용지물이 됩니다.

해결책:

  • 거래량도 주가와 반대 비율로 보정한 **수정거래량(Adjusted Volume = 원거래량 분할비율)**을 사용합니다.
  • 또는 주식 수의 영향을 받지 않는 **거래대금(원주가거래량수정주가수정거래량)**을 유동성 지표의 기준으로 사용합니다.

함정 2: 과거 특정 시점의 주문 수량 계산 오류

섹션 제목: “함정 2: 과거 특정 시점의 주문 수량 계산 오류”

백테스트 시뮬레이션에서 2017년 1월에 보유 자산 1,000만 원으로 삼성전자를 매수하는 로직을 짰다고 가정해 보겠습니다. 만약 수정주가(당시 기준 약 36,000원)로 매수 가능 주식 수를 계산하면 약 277주를 매수한 것으로 계산됩니다.

하지만 2017년 당시 실제 삼성전자 원주가는 약 180만 원이었습니다. 실제로는 5주밖에 살 수 없었고 나머지 현금은 잔액으로 남아 있었어야 합니다. 고가 대형주를 다룰 때 수정주가만으로 매수 수량을 계산하면 소수점 단위 매매나 최소 투자 단위 왜곡이 생길 수 있습니다.

함정 3: 미래 자본 변동으로 과거 데이터가 갱신되는 특성 (Data Versioning)

섹션 제목: “함정 3: 미래 자본 변동으로 과거 데이터가 갱신되는 특성 (Data Versioning)”

오늘 어떤 종목이 무상증자나 액면분할을 실시하면, 오늘 기준으로 과거 10년 치 수정주가 데이터 전체가 새롭게 다시 계산(Rewrite)됩니다.

데이터베이스에 과거 수정주가를 한 번 적재해 두고 고정해 버리면(Frozen), 새로 들어오는 주가와 과거 주가 사이의 수정 비율이 어긋나게 됩니다. 반대로 데이터베이스를 관리할 때는 원주가 테이블과 자본변동(수정계수) 테이블을 분리하여 관리하는 것이 안전합니다.


7. Python 코드로 확인하는 수정주가 계산 예시

섹션 제목: “7. Python 코드로 확인하는 수정주가 계산 예시”

간단한 Pandas 코드로 액면분할 시 원주가와 수정주가의 수익률 차이를 확인할 수 있습니다.

import pandas as pd
import numpy as np
# 가상의 주가 데이터 생성 (5일 차에 1:2 액면분할 발생)
df = pd.DataFrame({
"date": pd.date_range("2026-10-01", periods=6),
"raw_close": [100000, 102000, 101000, 104000, 53000, 54000], # 5일차에 1:2 분할
"split_ratio": [1.0, 1.0, 1.0, 1.0, 2.0, 1.0] # 5일차에 2배 분할
})
# 1. 후방 수정계수(Cumulative Adjustment Factor) 계산
# 미래부터 역순으로 누적 곱을 계산
df["adj_factor"] = df["split_ratio"].iloc[::-1].cumprod().iloc[::-1]
# 2. 수정주가 계산: 원주가 / 수정계수 (최신 기준 통일)
# (5일차 이전 과거 주가를 2로 나누어 현재 수준으로 맞춤)
df["adj_close"] = df["raw_close"] / (df["adj_factor"] / df["adj_factor"].iloc[-1])
# 3. 일일 수익률 계산 비교
df["raw_return"] = df["raw_close"].pct_change()
df["adj_return"] = df["adj_close"].pct_change()
print(df[["date", "raw_close", "adj_close", "raw_return", "adj_return"]])
date raw_close adj_close raw_return adj_return
0 2026-10-01 100000 50000.0 NaN NaN
1 2026-10-02 102000 51000.0 0.020000 0.020000
2 2026-10-03 101000 50500.0 -0.009804 -0.009804
3 2026-10-04 104000 52000.0 0.029703 0.029703
4 2026-10-05 53000 53000.0 -0.490385 0.019231 <-- 원주가 -49%, 수정주가 +1.92%
5 2026-10-06 54000 54000.0 0.018868 0.018868

4일 차에서 5일 차로 넘어갈 때, 원주가는 -49% 손실로 기록되지만 수정주가는 정상적인 +1.92% 상승으로 올바르게 반영됩니다.


8. 독자를 위한 실전 체크포인트

섹션 제목: “8. 독자를 위한 실전 체크포인트”

금융 데이터 분석이나 백테스트 파이프라인을 운영할 때 아래 항목들을 반드시 체크해 보세요.

  • 전략 시뮬레이션 및 백테스트: 가격 지표와 수익률 계산에 수정주가를 사용하고 있는가?
  • 거래량 지표 계산: OBV, MFI 등 거래량 기반 지표 계산 시 수정거래량 또는 거래대금을 적용했는가?
  • 실제 포트폴리오 회계 및 주문 집행: 과거 체결 금액, 잔고 증명, 세금 계산 시 원주가와 실제 유통 주식수를 기준으로 검증했는가?
  • 데이터베이스 보관 구조: 원주가(Raw Price)와 자본변동 수정계수(Adjustment Factor)를 분리 보관하여 과거 데이터의 재계산 유연성을 확보했는가?

데이터의 기본이 되는 가격 체계를 정확히 이해하고 정제하는 것이야말로 신뢰할 수 있는 퀀트 전략의 가장 첫 번째 출발점입니다.
기본적 분석 1장: 재무지표를 주가 데이터와 연결하는 법

재무지표와 가격 데이터를 연결하는 분석 장면

기본적 분석은 “좋은 기업을 찾는 방법”으로 설명되지만, 데이터 분석에서는 질문을 더 정확하게 써야 합니다.

특정 시점에 관측할 수 있었던 재무지표가 이후 수익률과 관련이 있었는가?

이 질문을 바꾸지 않으면 결과가 좋아 보여도 실제 투자 시점에는 사용할 수 없는 정보가 섞일 수 있습니다. 이 시리즈는 2024년 1월 2일부터 2026년 9월 4일까지의 가격·재무 데이터와 거래대금 상위 300개 종목을 사용한 탐색 분석입니다. 표본은 KOSPI 170개, KOSDAQ 130개이며 2025년 연간 재무 데이터를 보유한 종목은 294개입니다.

항목이번 시리즈의 기준
분석 단위종목-거래일 관측치
설명 변수PER, PBR, ROE, ROA, 부채비율, 마진, 성장률, 배당수익률 등
결과 변수관측일 종가 이후 5·20·60거래일 수익률
검증 구간2026-01-01 ~ 2026-09-04

단, 연간 재무지표가 실제 시장에 발표된 날짜까지 완전히 반영된 데이터인지 확인되지 않는다면 이 결과는 시점 누수 가능성이 있는 탐색 결과로 봐야 합니다. 연간 결산 숫자를 1월 1일부터 사용한 것처럼 처리하면 미래 정보를 과거에 미리 알고 투자한 셈이 될 수 있습니다.

import pandas as pd
prices = pd.read_csv("ohlcv.csv", dtype={"code": str})
prices = prices.sort_values(["code", "date"])
for horizon in [5, 20, 60]:
prices[f"forward_{horizon}d"] = (
prices.groupby("code")["close"].shift(-horizon)
/ prices["close"] - 1
)

이 수익률은 수수료, 세금, 슬리피지, 배당을 반영하지 않은 가격 수익률입니다. 신호를 종가 기준으로 계산했다면 체결은 다음 거래일로 미뤄야 하며, 그렇지 않으면 당일 종가를 알고 같은 가격에 매수한 것처럼 계산될 수 있습니다.

재무지표를 붙일 때 생기는 함정

섹션 제목: “재무지표를 붙일 때 생기는 함정”

재무지표를 거래일마다 반복해서 붙이는 것 자체는 편리하지만, 다음 조건이 지켜져야 합니다.

  • 재무지표의 기준일이 아니라 공시·발표일 이후에만 사용합니다.
  • 결측치를 전체 표본 중앙값으로 채우면 종목·섹터별 결측 패턴이 사라지므로 별도 표시합니다.
  • 현재 살아 있는 종목만 모으면 상장폐지·거래정지 종목이 빠지는 생존자 편향이 생깁니다.
  • 같은 기업의 연속된 거래일은 독립 표본이 아니므로 유의확률보다 기간별·종목별 재현성을 봅니다.

이번 시리즈에서 말할 수 있는 것과 없는 것

섹션 제목: “이번 시리즈에서 말할 수 있는 것과 없는 것”

현재 결과는 “어떤 지표가 반드시 주가를 예측한다”는 증명이 아닙니다. 동일한 표본과 제한된 기간에서 분위수별 미래 수익률이 어떻게 달랐는지 보여주는 가설 탐색입니다. 평균수익률 하나만으로 결론을 내리지 않고 중앙값, 양수 비율, 최대낙폭, 섹터별 결과를 함께 보겠습니다.

다음 장에서는 가장 널리 쓰이는 가치 지표인 PER을 보되, 금융업·적자 기업·일회성 이익처럼 PER이 왜곡되는 경우부터 분리해 보겠습니다.

  1. 이 숫자는 시장이 언제 알 수 있었는가?
  2. 미래 수익률의 시작 가격과 체결 시점은 일관적인가?
  3. 표본에서 빠진 종목은 없는가?
  4. 평균과 중앙값이 같은 방향인가?
  5. 다른 기간·섹터에서도 같은 결과가 나오는가?

이 다섯 질문에 답하지 못한 백테스트는 정교한 표보다 먼저 데이터 설계를 다시 봐야 합니다.


이 글은 교육 및 연구 목적의 자료이며 특정 종목의 매수·매도를 권유하지 않습니다. 과거의 분석 결과는 미래 수익을 보장하지 않습니다.

기본적 분석 11장: 백테스트 결과보다 먼저 검증할 것

기본적 분석 전략의 백테스트를 검증하는 장면

백테스트 표에서 누적수익률이 가장 큰 전략을 찾는 일은 쉽습니다. 어려운 일은 그 수익률이 미래 정보를 사용하지 않았고, 실제로 거래 가능한 방식으로 계산되었는지 확인하는 것입니다.

이번 결과는 탐색용 기준선이다

섹션 제목: “이번 결과는 탐색용 기준선이다”

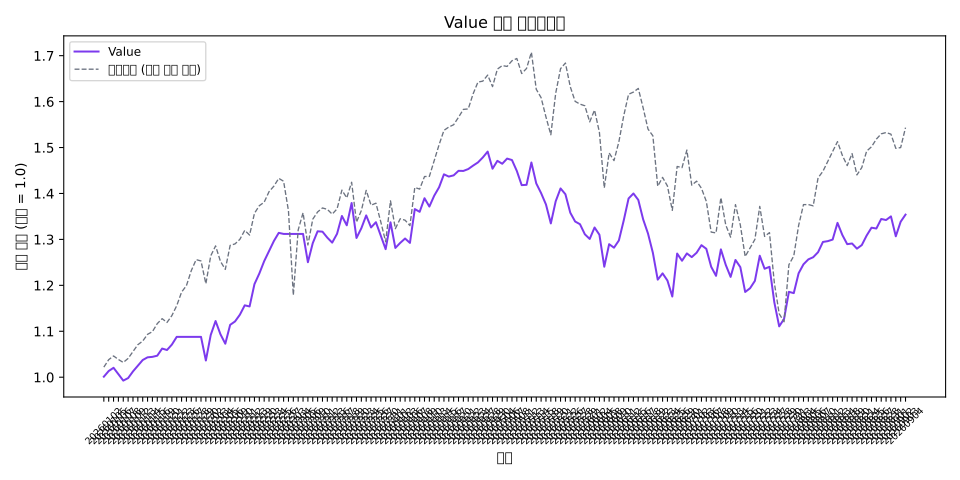
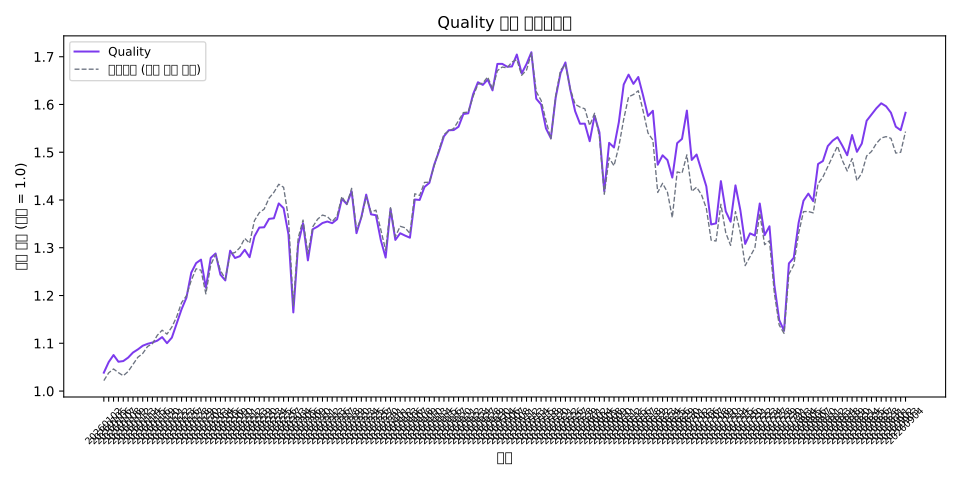
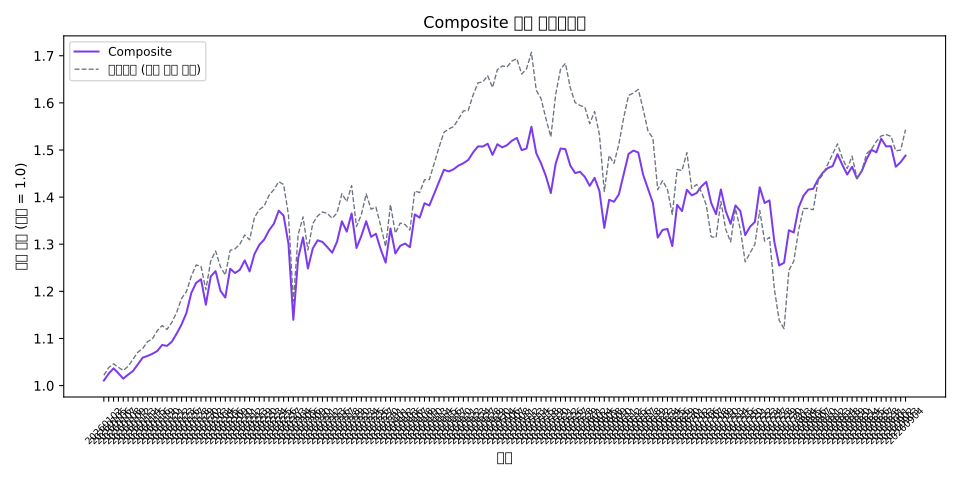
현재 공개된 기준선은 거래대금 상위 300종목, 2026-01-01~2026-09-04 166거래일, 월별 리밸런싱, 동일가중 상위 25%입니다.

전략누적수익률Sharpe최대낙폭
Value+35.39%1.44-25.52%
Quality+58.26%1.56-34.12%
Composite+48.80%1.63-19.00%

이 수치는 벤치마크와 함께 봐야 하며, 166거래일에 연환산수익률을 크게 표시하면 오해가 커집니다. 짧은 기간의 누적수익률을 1년 성과처럼 받아들이지 않는 것이 중요합니다.

Value 전략 누적수익률

Quality 전략 누적수익률

Composite 전략 누적수익률

2025년 연간 재무지표를 2026년 초부터 사용했다면, 실제 공시일 이전 정보를 사용한 것입니다. 이 시리즈의 현재 데이터에는 기준일과 발표일이 분리되어 있지 않으므로, 위 결과를 실거래 성과로 해석할 수 없습니다.

현재 표본은 분석 시점의 거래대금 상위 300종목입니다. 과거에도 같은 종목만 사용했다면 현재 살아 있는 종목만 남는 생존자 편향이 생길 수 있습니다. 과거 각 리밸런싱 시점의 유니버스를 복원해야 합니다.

신호를 월초 종가로 만들고 같은 종가에 체결하면 안 됩니다. 다음 거래일 시가 또는 현실적인 지정가로 체결하고, 수수료·세금·슬리피지·거래량 제한·상하한가를 반영해야 합니다.

동일한 유니버스·리밸런싱·체결 규칙으로 벤치마크와 전략을 계산해야 합니다. 전략만 거래비용을 부담하고 벤치마크는 비용을 부담하지 않으면 비교가 공정하지 않습니다.

  1. 재무지표에 발표일을 추가합니다.
  2. 월별 시점에서 그날 이용 가능한 값만 사용합니다.
  3. 2024~2025년을 학습 구간, 2026년을 완전히 잠근 테스트 구간으로 둡니다.
  4. 산업 중립 버전과 비중 제한 버전을 함께 실행합니다.
  5. 다른 기간과 비용 가정에서 결과가 유지되는지 확인합니다.

따라서 현재 결과의 정직한 결론은 “이 기간에 Composite의 변동성이 상대적으로 낮았다” 정도입니다. “Quality가 미래에도 가장 좋은 전략”이라는 결론은 아직 뒷받침되지 않습니다.

원자료는 전략 결과 CSV에서 확인할 수 있습니다.


이 글은 교육 및 연구 목적의 자료이며 특정 종목의 매수·매도를 권유하지 않습니다. 과거의 백테스트 결과는 미래 수익을 보장하지 않습니다.

기술적 분석 1장: 지표 신호의 수익률 구분 능력

차트와 기술적 분석 데이터

기술적 분석에서 먼저 답해야 할 질문은 “이 지표가 유명한가?”가 아니라 “신호가 발생한 뒤의 수익률이 신호가 없을 때와 달라지는가?”입니다. 한 종목의 차트에서 그럴듯해 보이는 패턴만으로는 이 질문에 답할 수 없습니다.

이번 분석은 같은 표본과 같은 규칙으로 이동평균, RSI, MACD, 볼린저 밴드, 거래량, OBV 신호를 만들고, 신호 발생 뒤 5·20·60거래일 수익률을 비교합니다. 이 장에서는 분석에 사용할 데이터와 계산 규칙을 고정한 뒤, 전체 지표 결과를 먼저 훑어봅니다. 이후 각 장에서 지표를 하나씩 정의하고, 이 결과가 어떤 조건에서 유지되거나 무너지는지 확인합니다.

따라서 이 글의 결론은 “데이터를 공개했다”가 아닙니다. 어떤 신호가 이후 수익률과 더 강하게 연결됐고, 어떤 신호는 평균수익률만 좋아 보였는지를 구분하는 것이 이 장의 목적입니다.

분석 기준일은 2026년 9월 4일입니다. 기준일 거래대금이 큰 일반 주식 300개를 표본으로 선정하고, 2024년 1월 1일부터 2026년 9월 4일까지의 일봉을 사용했습니다. ETF, ETN, 인버스, 레버리지, 채권형 상품은 제외했습니다.

항목값
표본 종목 수300개
OHLCV 원자료 행 수185,309개
120일 워밍업 이후 지표 행 수150,419개
가격 데이터 기간2024-01-01 ~ 2026-09-04
학습 구간2024-01-01 ~ 2025-12-31
검증 구간2026-01-01 ~ 2026-09-04

표본은 모든 상장 종목을 대표하지 않습니다. 거래대금 상위 종목을 사용했기 때문에 유동성이 낮은 종목의 체결 문제를 줄이는 대신, 대형주와 관심 종목에 유리한 표본 편향이 생깁니다. 이 한계를 숨기지 않고 원자료와 조건을 함께 공개합니다.

import pandas as pd
df = pd.read_csv(
"ohlcv.csv",
dtype={"code": str},
parse_dates=["date"],
)
df = df.sort_values(["code", "date"])
df["return_1d"] = df.groupby("code")["close"].pct_change()
df["return_20d"] = df.groupby("code")["close"].pct_change(20)
print(df.shape)
print(df[["code", "date", "close", "return_20d"]].tail())

이 코드의 핵심은 종목별로 날짜를 정렬한 뒤 수익률을 계산하는 것입니다. 전체 데이터를 날짜만 기준으로 정렬하면 서로 다른 회사의 가격이 이어지는 오류가 생깁니다. 실제 지표 계산과 신호 정의는 공개한 Python 파일에서 재현할 수 있고, 이 장에서는 그 결과 파일을 같은 기준으로 읽어 비교합니다.

지표 신호와 20일 수익률의 관계

섹션 제목: “지표 신호와 20일 수익률의 관계”

먼저 중간 기간인 20거래일을 기준으로 비교합니다. 검증 구간은 2026년 1월 1일부터 9월 4일까지이며, 신호가 발생한 날의 종가부터 20거래일 뒤 종가까지의 수익률을 계산했습니다. 신호 당일의 수익률을 사용하지 않았기 때문에 신호 이후의 결과만 측정합니다.

import pandas as pd
results = pd.read_csv(
"event_results.csv",
encoding="utf-8-sig",
)
validation_20d = (
results.query(
"sample == '검증' and horizon_days == 20 "
"and signal != '복합 신호 진입'"
)
.assign(
positive_rate=lambda x: x["positive_rate"] * 100,
mean_return=lambda x: x["mean_return"] * 100,
median_return=lambda x: x["median_return"] * 100,
)
.loc[:, [
"signal", "events", "positive_rate",
"mean_return", "median_return",
]]
.sort_values("mean_return", ascending=False)
)
print(validation_20d.round(2).to_string(index=False))

실행 결과는 다음과 같습니다.

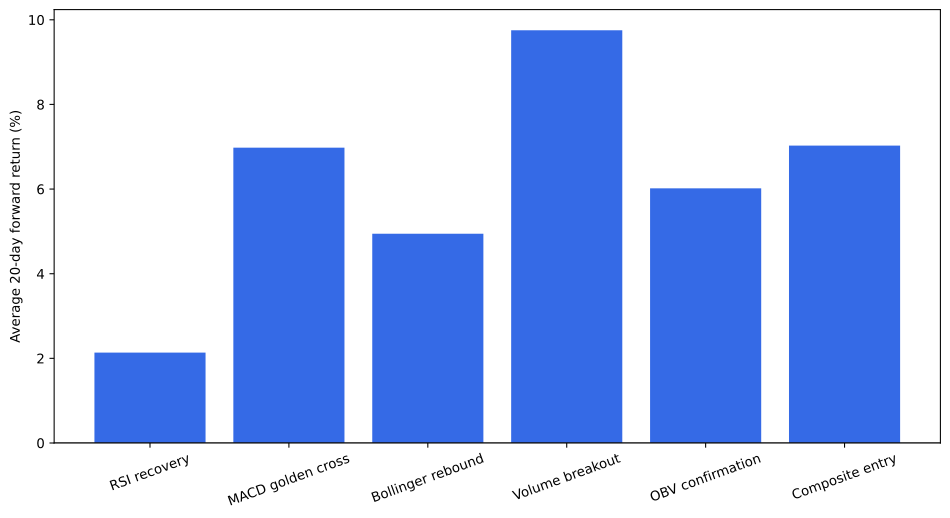
신호발생 횟수양수 비율평균 수익률중앙값 수익률
거래량 돌파2,72653.4%+9.75%+2.51%
MACD 골든크로스1,86855.1%+6.98%+2.72%
OBV 확인2,65353.8%+6.02%+2.03%
볼린저 하단 반등1,01549.4%+4.94%-0.27%
RSI 회복1,25847.1%+2.14%-0.91%

기술적 신호의 20일 선행수익률

이 표에서 가장 먼저 보이는 것은 평균수익률만으로 신호의 질을 판단하면 안 된다는 점입니다.

  • 거래량 돌파는 평균 수익률이 +9.75%로 가장 높고 중앙값도 +2.51%였습니다. 일부 대박 사례만으로 평균이 올라간 것이 아니라, 전형적인 신호에서도 수익률이 양수 쪽에 놓였다는 뜻입니다.
  • MACD 골든크로스는 양수 비율이 55.1%로 가장 높고 중앙값도 +2.72%였습니다. 이번 검증 구간에서는 추세 전환 신호 중 결과의 방향성이 가장 안정적이었습니다.
  • OBV 확인도 평균 +6.02%, 중앙값 +2.03%를 기록했습니다. 거래량 돌파와 함께 거래량을 확인하는 신호가 가격 반등만 보는 신호보다 일관된 결과를 보였다는 해석이 가능합니다.
  • RSI 회복과 볼린저 하단 반등은 평균수익률은 플러스였지만 중앙값이 각각 -0.91%, -0.27%였습니다. 소수의 큰 상승 사례가 평균을 끌어올렸을 가능성이 있어, “과매도 후 반등”을 반복적으로 기대하기에는 근거가 약합니다.

다만 이 결과가 신호가 발생하면 무조건 매수해야 한다는 뜻은 아닙니다. 가장 높은 양수 비율도 55.1%에 그쳤고, 모든 신호의 하위 25% 수익률은 마이너스였습니다. 즉 기술적 지표는 방향을 맞히는 단독 예언 도구라기보다, 어떤 상황에서 상대적으로 유리한 후보를 좁히는 필터로 해석하는 편이 적절합니다.

또한 이 표는 신호별 사건을 독립적으로 집계한 결과입니다. 신호가 겹치는 종목을 하나의 포트폴리오로 운용했을 때의 거래비용, 보유 비중, 최대낙폭은 아직 반영하지 않았습니다. 그래서 다음 장부터는 개별 지표의 신호 정의를 확인하고, 마지막 장에서 실제 전략 성과와 리스크를 별도로 비교합니다.

이번 결과는 다음 순서를 정하는 기준이 됩니다.

  • 이동평균과 MACD처럼 추세를 따라가는 신호는 왜 상대적으로 안정적이었는가
  • RSI와 볼린저 밴드의 반등 신호는 어떤 시장 국면에서 실패했는가
  • 거래량 돌파와 OBV 확인은 같은 정보를 반복해서 보는 것인가, 서로 보완하는가
  • 개별 신호의 관계가 실제 종목 스크리닝과 포트폴리오 백테스트에서도 유지되는가

다음 장에서는 이동평균선 신호를 전략으로 바꿔, 단순히 수익률이 높았다는 사실을 넘어 보유 시점과 최대낙폭까지 확인합니다.

원본은 OHLCV CSV, 종목 유니버스, 전체 데이터 설명에서 확인할 수 있습니다. 전체 재현 코드는 technical_analysis.py로 제공합니다.

기술적 분석 12장: 백테스트하는 기술적 전략

기술적 분석 전략 백테스트

앞 장의 후보 목록은 분석 대상을 줄여줄 뿐, 실제 투자 성과를 보여주지 않습니다. 기술적 분석의 마지막 질문은 “어떤 지표가 가장 유명한가?”가 아니라 “같은 조건과 비용을 적용했을 때 어떤 전략이 남는가?”입니다. 이번 장에서는 300개 종목에 같은 기간과 같은 비용 가정을 적용해 이동평균, MACD, 복합 신호를 비교합니다.

state = df["close"] > df["ma20"]
state &= df["ma20"] > df["ma60"]
# 당일 신호로 다음 거래일부터 보유
position = state.groupby(df["code"]).shift(1).fillna(False)
gross_return = position * df["return_1d"]
turnover = position.groupby(df["code"]).diff().abs().fillna(position)
net_return = gross_return - turnover * 0.0015

실제 포트폴리오 계산에서는 해당 날짜에 보유 중인 종목의 수익률을 동일 비중으로 평균냈습니다. 거래비용은 포지션 변경 시 0.15%를 차감했습니다.

검증 구간은 2026년 1월 1일부터 9월 4일까지입니다.

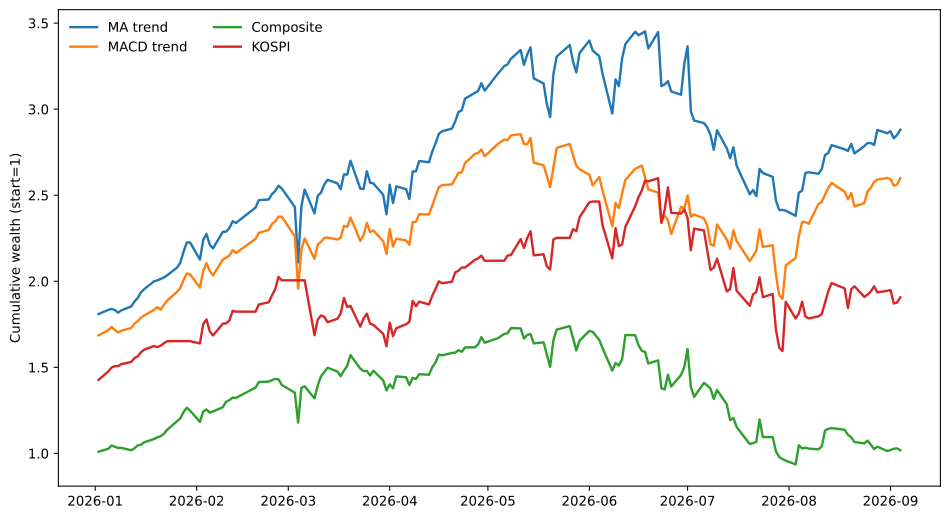
전략누적수익률연환산수익률변동성최대낙폭Sharpe 근사
MA 추세+63.55%+111.03%52.43%-31.05%2.12
MACD 추세+58.15%+100.55%50.36%-33.52%2.00
복합 신호+5.11%+7.86%63.69%-46.21%0.12
코스피+33.62%+55.69%61.14%-38.63%0.91

기술적 분석 전략 누적자산

이번 검증 구간에서는 MA와 MACD 추세 전략이 코스피를 앞섰습니다. MA 추세는 코스피보다 누적수익률이 높고 최대낙폭도 작았지만, -31.05%의 하락을 감수해야 했습니다. 반면 복합 신호 전략은 조건이 더 많았음에도 누적수익률이 +5.11%에 그쳤고 최대낙폭은 -46.21%였습니다.

이 표는 9장의 사건별 결과와 12장의 포트폴리오 결과가 다를 수 있다는 점도 보여줍니다. 복합 신호는 사건별 20일 평균수익률이 +7.03%였지만, 실제 진입·보유·거래비용을 적용한 전략의 누적수익률은 +5.11%였습니다. 신호가 발생한 사례의 평균과 투자자가 보유한 포트폴리오의 성과는 진입 시점, 신호 중복, 보유 종목 수, 거래비용에 의해 달라집니다.

이번 데이터에서 확인한 핵심은 다음과 같습니다.

  1. 거래량 돌파와 MACD 골든크로스는 20일 선행수익률에서 상대적으로 강했습니다.
  2. RSI 회복과 볼린저 하단 반등은 평균보다 중앙값이 낮아 일부 급등 사례의 영향을 크게 받았습니다.
  3. 높은 변동성 종목은 복합 신호가 나와도 양수 비율과 중앙값이 낮았습니다.
  4. 같은 기술 신호라도 산업별 결과가 달랐습니다.
  5. 조건을 많이 결합한다고 전략 성과가 자동으로 좋아지지는 않았습니다.
  6. 높은 수익률에는 항상 최대낙폭과 표본 편향을 함께 표시해야 합니다.

따라서 이번 분석에서 얻은 실전적인 순서는 다음과 같습니다.

  1. MA·MACD로 상승 추세에 있는 종목을 먼저 구분합니다.
  2. 거래량 돌파와 OBV로 추세에 거래량 확인이 붙었는지 봅니다.
  3. RSI·볼린저 반등은 단독 매수 신호가 아니라 시장·산업 조건과 함께 해석합니다.
  4. ATR로 종목별 포지션 크기와 손실 폭을 조정합니다.
  5. 산업·시장 국면으로 후보를 다시 나눈 뒤, 백테스트에서 거래비용과 최대낙폭을 확인합니다.

기술적 분석은 미래를 맞히는 주문이 아니라, 가격·거래량에서 반복적으로 관찰되는 조건을 정의하고 그 조건의 성과와 실패 범위를 측정하는 방법입니다. 이번 결과는 이 표본과 검증 기간에 대한 증거이지, 어떤 지표도 항상 작동한다는 보장은 아닙니다.

전체 원자료는 OHLCV, 신호 결과, 전략 결과, Python 코드에서 확인할 수 있습니다. 과거 검증 결과는 미래 수익을 보장하지 않으며, 실제 투자 전에는 체결 가능성·세금·슬리피지·생존자 편향을 추가로 검토해야 합니다.

AI 반도체 ETF 비교: 국내형과 미국형, 무엇이 다를까?

AI 반도체 ETF 비교 대표 이미지

AI 반도체 ETF를 찾을 때 가장 먼저 보이는 것은 최근 수익률입니다. 그러나 같은 ‘AI 반도체’라는 이름을 사용해도 국내 메모리 공급망에 집중하는 상품과 미국 팹리스·장비 기업을 담는 상품은 움직이는 이유가 다릅니다. 이 글에서는 최신 거래일 기준 데이터를 바탕으로 국내형 RISE AI반도체TOP10(0093A0)과 미국형 KODEX 미국AI반도체TOP3플러스(0151S0)를 비교합니다.

구분RISE AI반도체TOP10KODEX 미국AI반도체TOP3플러스
코드0093A00151S0
투자 지역한국미국
최신 기준일2026-09-032026-09-03
최신 종가30,400원14,345원
2026-06-01 종가39,665원17,887원

가격 수준 자체는 상품 간 비교 기준이 아닙니다. ETF 분할과 설정 시점이 다르기 때문에 수익률, 변동성, 구성종목 중복도를 함께 봐야 합니다.

수익률만 보면 국내형이 더 약했다

섹션 제목: “수익률만 보면 국내형이 더 약했다”

2026년 6월 1일부터 9월 3일까지 단순 가격 수익률은 RISE AI반도체TOP10이 약 -23.3%, KODEX 미국AI반도체TOP3플러스가 약 -19.8%였습니다. 두 상품 모두 조정을 받았지만, 국내형의 하락폭이 조금 더 컸습니다. 반도체 업황이 같아 보여도 원화 환율, 미국 기술주 밸류에이션, 국내 대형주 비중에 따라 결과가 달라질 수 있다는 뜻입니다.

다만 이 수치는 분배금과 거래비용을 반영하지 않은 종가 기준 단순 계산입니다. 실제 투자 성과를 비교할 때는 총수익률과 환헤지 여부를 확인해야 합니다.

국내형 ETF는 삼성전자·SK하이닉스와 국내 소재·장비 기업의 실적에 민감합니다. 메모리 가격과 HBM 출하가 개선되면 이익 레버리지가 커질 수 있지만, 특정 기업과 국내 수출 사이클에 위험이 집중될 수 있습니다.

미국형 TOP3 상품은 소수 종목 비중이 높아 ‘분산 ETF’라는 이름만으로 위험이 낮다고 보기 어렵습니다. 대신 엔비디아와 미국 반도체 설계·장비 기업의 AI 데이터센터 투자, 미국 기술주 흐름, 달러 가치가 함께 반영됩니다. 국내 투자자 입장에서는 주가 변동에 환율 변동까지 더해질 수 있습니다.

  • 한국 메모리와 HBM 사이클을 직접 보고 싶다면 국내형을 검토할 수 있습니다.
  • 미국 AI 인프라와 글로벌 팹리스 생태계에 투자하고 싶다면 미국형이 더 직접적인 선택입니다.
  • 하락장에서 버틸 상품을 찾는다면 이름보다 상위 보유종목 비중, 최근 최대낙폭, 거래대금을 먼저 비교해야 합니다.

첫째, HBM과 DRAM 가격이 물량 증가를 동반하는지 확인해야 합니다. 둘째, ETF의 상위 3~5개 종목 비중이 높아졌는지 살펴봐야 합니다. 셋째, 원·달러 환율과 미국 반도체 지수의 방향을 함께 봐야 합니다. 마지막으로 최근 수익률이 높다는 이유만으로 추격 매수하지 말고, 동일 기간의 최대낙폭과 회복 기간을 비교해야 합니다.

AI 반도체 ETF 비교에서 ‘국내형이냐 미국형이냐’보다 중요한 것은 어떤 위험을 감수할 것인지입니다. 국내형은 메모리와 HBM이라는 명확한 산업 노출을 제공하지만 한국 대형주와 수출 사이클에 집중됩니다. 미국형은 글로벌 AI 투자에 접근하지만 소수 종목과 환율 위험이 커질 수 있습니다. 따라서 수익률 순위 하나가 아니라 구성종목 집중도·환율 민감도·최대낙폭·거래대금을 같은 기간에 비교한 뒤 투자 비중을 결정하는 것이 합리적입니다.

이 글은 특정 ETF의 매수·매도를 권유하지 않으며, 투자 판단과 손익의 책임은 투자자에게 있습니다.